
做分镜过去意味着画画。对大多数人来说,这正是他们跳过这一步的全部理由。
现在不是了。你粘贴一段剧本,拿回一份带编号的镜头清单,改掉不对的地方,为每个镜头生成一张画面——然后把你确认过的画面变成视频。
这就是完整的工作流。五个步骤、目前仍然会崩的两个地方,以及一个可以跟着走的实例。
我们在做 Anyscene,下面大部分内容来自眼看着积分消失在没做好规划的分镜上。
为什么分镜仍然决定成片
视频是在前期垮掉的,不是在剪辑台上。
等你发现第四个镜头和第一个对不上时,两个的钱都已经付了。这在成本是一天拍摄的年代成立,在成本变成生成积分的今天同样成立——只是账单来得更快。
没有分镜会出什么事
这是我们见得最多的情形。
有人用八条互不相干的提示词生成了八个镜头。然后发现角色的夹克换了三次颜色。
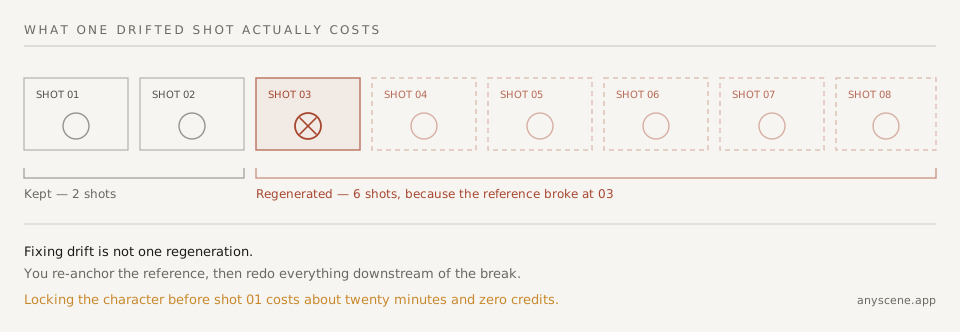
补救不是重生成一次。你得重新建立参考,再把漂移之后的全部重做一遍。
镜头开始消耗积分之后,变了什么
传统分镜通过避免浪费拍摄日来省钱。AI 分镜通过避免浪费生成来省钱——逻辑一样,只是反馈周期短得多。
返工的账
| 成本 | |
|---|---|
| 先规划分镜 | 约 20 分钟,0 积分 |
| 在第 3 个(共 8 个)镜头发现漂移 | 重生成 6 个镜头 |
| 在最终审片时才发现漂移 | 整条序列,外加你的一个下午 |
二十分钟的规划每次都赢过六次重生成,而且不是险胜。
什么是 AI 分镜
AI 分镜是由一份文字剧本生成的、带编号的镜头序列,每个镜头有自己的构图、运镜说明和图片提示词——并附带一张可以在进入视频之前审阅的生成画面。
这个定义是刻意收窄的。这个品类已经被拉扯到把只做一半的工具也包进去了。
分镜、动态分镜与预演的区别
这三个词经常被混着用。它们是不同的交付物。
| 术语 | 是什么 | 有动态吗 |
|---|---|---|
| 分镜 | 静止画面,每个镜头一张,带说明 | 无 |
| 动态分镜 | 按时长剪起来的分镜,有时配临时声音 | 只有时间 |
| 预演 | 用于走位和机位的粗糙动态镜头 | 有 |
这套工作流产出的是分镜,以及可选地,把它变成预演的那些动态镜头。
AI 实际替你决定的部分
镜头的切分、构图建议、时长估算,以及每个镜头的提示词初稿。
这确实省掉了实打实的一部分工作——但它是初稿,不是决定。
以及它决定不了的
它不知道你的品牌、你的预算,也不知道哪个节拍要紧。它不知道第 5 个镜头才是客户会盯着不放的那个。
任何声称相反的工具,说的是演示,不是工作流。
五步工作流
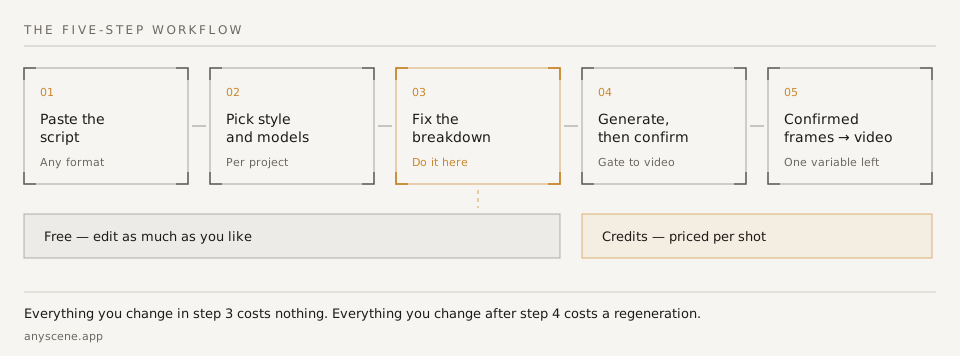
五个步骤,每一步都需要你明确操作。这里没有一键按钮,那是设计在起作用,不是功能缺失。
第 1 步 — 把剧本写成能干净拆解的样子
什么格式都行:剧本、广告脚本、旁白稿,或者一串要点。
要紧的是动作行要具体。
具体的动作行胜过场次标签
"她在门口犹豫了一下"给拆解提供了材料。"开场"什么都没给,于是模型编了个平庸的东西出来。
写物理上发生了什么。镜头语言是后面的事。
第 2 步 — 选风格、画幅和模型
挑一个视觉风格、一个画幅比例,以及负责图片和视频的模型。
模型的选择为什么盖过其他所有设置
Veo 3.1 和 Kling 2.6 的长处确实不同——对话和人物动作,对上风格化的运动和运镜。
这里选错的代价高过页面上任何其他设置,而且你之后还能逐镜头更换。
第 3 步 — 花钱之前先把拆解结果改对
剧本会以带编号的镜头清单返回,所有字段可编辑,包括生成出来的提示词。
这是大多数工具藏起来的一步,也是决定你账单的一步。
合并、拆分、重排
两个本该是一个的镜头?合了。一个镜头扛了三个动作?拆了。
改文字免费,重新生成画面不免费。
一致性模式与速度模式
| 模式 | 怎么工作 | 什么时候用 |
|---|---|---|
| 一致性 | 顺序生成,每个确认过的镜头作为下一个的参考 | 有反复出现的人物或产品 |
| 速度 | 并行,纯文字生成 | 互不相关的画面集锦 |
一致性更慢,在保住一个角色上好得多。速度更便宜,漂移肉眼可见。
💡 提示:在这一步用镜头提示词规则把提示词重写一遍。这是整个流程里杠杆最大的二十分钟。
第 4 步 — 生成并确认画面
一张张生成或批量生成都行。审阅,把没中的重做。
确认这道关卡为什么存在
在你说某一帧对之前,任何东西都不会进入视频阶段。
每个镜头多点一次,而它挡住的是一个坏画面变成一段更贵的坏视频。
第 5 步 — 把确认过的画面变成视频
确认过的画面成为该镜头视频的首帧。
只剩一个变量
因为画面在生成片段之前就锁定了,唯一可能出问题的就是运动。这让排查变得便宜——片段不好,那是运镜的问题,不是构图的。
之后把素材全下载下来,在剪辑软件里接成片。
一个实例
来看这套流程在一段短剧本上是什么样子。
📝 说明:这是为展示输出形态而构造的实例——剧本、一份典型的拆解结果,以及它会需要的修改。它不是某一次具体生成的记录。
剧本
内景・工坊 — 夜
雨打在窗上。米娅打磨着一条椅腿,停下来,举到光下。不对。她把它放下,伸手去拿另一件工具。
四十个词。三个节拍。
它返回的拆解结果
这样一段剧本通常会返回五到六个镜头:
| # | 景别 | 运镜 | 时长 | 提示词 |
|---|---|---|---|---|
| 01 | ELS | 固定 | 0:03 | Extreme long shot, workshop interior at night, rain on windows, single work lamp |
| 02 | MS | 固定 | 0:04 | Medium shot, waist up, Mia sanding a chair leg, warm lamp key from camera left |
| 03 | CU | 固定 | 0:03 | Close-up, hands moving along the wood grain, shallow depth of field |
| 04 | MCU | Slow dolly in | 0:04 | Medium close-up, she stops and holds the leg to the light, reading it |
| 05 | ECU | 固定 | 0:02 | Extreme close-up, the flaw in the wood, raking light across the surface |
| 06 | MS | 固定 | 0:03 | Medium shot, she sets it down and reaches off-frame for another tool |
你会动手改的地方
几乎总有东西要改。要看的是这些。
该合并的镜头
5 和 6 是同一个节拍——她看见瑕疵并对它作出反应。在中间切一刀,就多出一个剧本没要求的拍子。
合并省下一次生成,序列也更紧。
缺掉的那个镜头
没有反应镜头。剧本写的是"不对",那是一个内在状态,而拆解给了它一个物件特写而不是一张脸。
在 5 和 6 之间加一个她脸部的中近景。拆解容易少给反应镜头,因为剧本写的是动作,不是感受。
完成的序列
六个镜头,约十九秒,一个从头到尾看起来是同一个人的角色——因为参考在第一个镜头之前就锁定了。
这就是全部交付物。剩下在剪映、Premiere 或 DaVinci Resolve 里组装。
按格式做分镜
五个步骤不变。变的是镜头数量,以及你在优化什么。
竖屏短视频
三十秒配六到十个镜头。一开始就按 9:16 构图,别事后裁。
景别要有变化——竖屏会放大单一景别序列的平淡。
广告与产品短片
广告分镜有剧情片分镜没有的结构义务。
六格的义务
| 格 | 职责 | 秒数 |
|---|---|---|
| 1 | 钩子 | 0:00–0:03 |
| 2 | 问题 | 0:03–0:05 |
| 3 | 解决 | 0:05–0:08 |
| 4 | 证据 | 0:08–0:11 |
| 5 | 报价 | 0:11–0:13 |
| 6 | CTA | 0:13–0:15 |
钩子那一格没做好,后面的一切都不重要了,因为已经没人在看。
解说视频
常常是静帧加旁白,完全不需要视频。生成画面,跳过第 5 步,把积分省下来。
一致性模式能让反复出现的讲解者保持稳定。
音乐与歌词段落
唯一一种镜头之间的漂移反而是优点的场景。用速度模式,让画面发散。
生成前的检查清单
这里所有的事都发生在编辑还免费的阶段。花掉一个积分之前,过一遍。
检查镜头清单
每个镜头都写了景别吗
如果某一行写的是"工坊的镜头",它会以中景返回,因为那是模型的默认落点。
景别是唯一一个默认值会实实在在让你花钱的字段。
有没有镜头扛着两个动作
在动作那一栏里找"和""然后""一边"。每出现一次,通常就是一个你还没画出来的镜头分界。
拆分的代价是一次生成。不拆的代价是一个两个动作都没说清的画面。
有反应镜头吗
拆解在这一项上总是给得不够,因为剧本写的是人在做什么,不是在感受什么。
把序列读一遍,问自己哪里该有一张脸。通常就在某件事出岔子之后。
检查连贯性
角色参考锁定了吗
在第一个镜头之前,不是第三个之后。后面所有东西都从它继承。
光线那句话重复了吗
同一场戏,每个镜头都该带同样的光线描述。"Late afternoon, low sun through the window, warm rim light from camera left" 一字不差地复制到六个镜头里。
它对连贯性的作用大过任何风格关键词。
相邻镜头的景别有变化吗
同一主体、景别几乎相同的两个镜头会跳。至少变两档:中景切特写干净,中景切中近景就跳。
检查钱
到底哪些镜头需要视频
不是全部。解说序列常常静帧就够,而一个静态的产品画面不会因为动起来就变好。
把六个里的三个标成只出图,这部分账单就砍一半。
模型和内容配吗
生成完六个镜头再换模型,意味着六个镜头重做。
📝 说明:整份清单在六镜头的分镜上大约花十分钟。上面每一项在这个阶段都是免费修改,过了这个阶段就要付一次重生成的钱。
AI 分镜目前仍然会崩的地方
三个诚实的限制。没有一个能靠更好的提示词解决。
超过十来个镜头后的角色漂移
顺序参考会把小误差累积起来。到十二个镜头左右,角色已经复印自己很久了。
回到最初的参考图重新锚定,而不是继续这条链。
画面朝向与 180 度规则
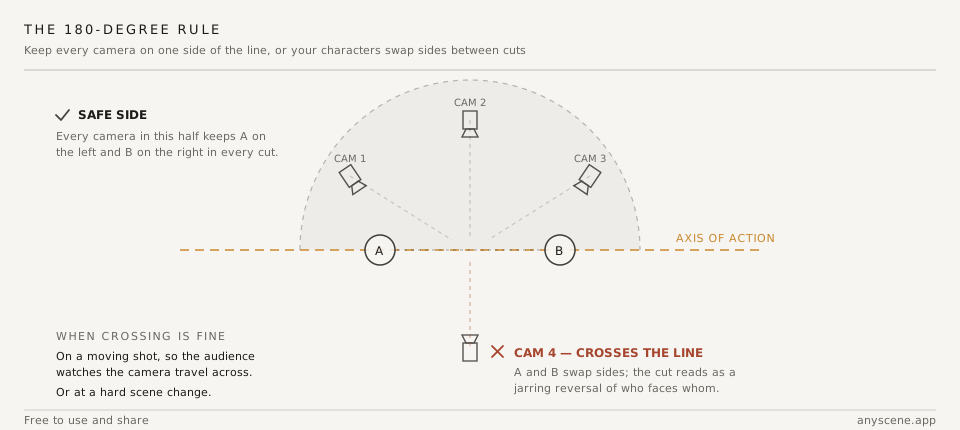
模型不会跨镜头追踪画面朝向。你要一个反打,可能就会拿到角色左右互换的结果。
这只能在分镜阶段抓住。这份参考讲了这条规则,以及什么时候可以破。
任何需要真实地点的东西
某一栋特定的建筑、真实货架上的真实商品、认得出来的某条街。生成是近似,不是复现。
如果这个镜头必须是那个地方,就去那个地方拍。
常见问题
用 AI 做一条视频的分镜要多久?
拆解本身大约一分钟。改它要十到三十分钟,而决定质量的正是这部分。生成画面按模型不同,每个镜头再加几分钟。六个镜头的分镜,连修改一起算一小时,而不是演示里暗示的五分钟。
需要会画画吗?
不需要。画画是把大多数人挡在分镜之外的那道门槛,生成把它拆掉了。取而代之的是写作——你现在需要精确地描述一个镜头,那是另一种能力,而且更容易学。
一条 30 秒的视频需要几个镜头?
叙事类六到十个。广告更紧,五到七个,因为每一格都有结构上的职责。解说可以更长,因为静帧比动态撑得久。三十秒里少于五个镜头,通常读起来是静的。
AI 能让同一个角色贯穿所有镜头吗?
能。用一张角色参考图加一致性模式,它会把每个确认过的镜头作为下一个的参考往前传。在一般长度的短序列里保持得不错,超过十来个镜头会衰减,那时回到最初的参考图重新锚定,不要接着往下传。
分镜和镜头清单有什么区别?
镜头清单是文字:编号、景别、运镜、时长。分镜是在这之上给每一条配一张画面。现场按清单干活,客户看分镜签字。AI 工作流从同一份拆解结果里同时产出两者。
AI 分镜能用在客户项目上吗?
能,而且分镜是给客户看的 AI 产物里比较安全的一类,因为它明确就是草稿。缺的是审批流程——Boords 这类专门工具有版本管理和画格级批注,生成工具通常没有。导出,然后用你现有的方式分享。
必须有完整剧本才能开始吗?
不必。一串节拍就够——六行按顺序写清楚发生了什么,就能拆出可用的结果。行不通的是主题或情绪("关于跑鞋的、有能量感的东西"),因为那里面没有可以变成镜头的动作。如果只有一个概念,先把节拍写出来;十分钟的事,而这就是分镜和情绪板的分界。
生成完的画面之后怎么用?
下载下来,在剪映、Premiere 或 DaVinci Resolve 里组装。生成工具是素材工厂,不是剪辑软件——转场、文字和音乐都属于剪辑,在那里改动不花钱。
你的下一份分镜
拿一份你已经写好的剧本。不要新写——用已经存在的,这样你是在试这套流程,而不是一边学一边写。
把它贴进 AI 分镜生成器,把时间花在第 3 步上。质量在那里决定,而编辑在那里还是免费的。
如果拆解结果里的提示词需要打磨,提示词库里有四十条可以借用。