新モデル登場:Seedance 2.5、Gemini Omni Flash、Nano Banana Pro ほか

Seedance 2.5 を試す
Anyscene AI

画像からプロンプト生成

画像をアップロードすると、被写体・場所・光・カメラ・スタイルに分けたプロンプトが得られ、そのままワンクリックで生成できます。

画像をドロップ、貼り付け、または選択

JPG、PNG、WebP、GIF、AVIF、HEIC · 最大 10 MB

ファイルに保存されたプロンプトは、何もアップロードせずにここで読み取ります。

例で試す

詳しさ

プロンプトの言語

English
プロンプトを取得1

ここにプロンプトが、被写体・場所・光・カメラ・スタイルに分かれて表示されます。

画像はこの分析のためだけに Google Gemini へ送られます。「参照画像として使う」か「この画像を動かす」を選ばない限り、保存しません。

ひとことで言うと

画像からプロンプトとは?

画像からプロンプトは、テキストから画像の逆です。画像を渡すと、画像モデルがその絵を描くための言葉が返ってきます。

画像からプロンプト(image to prompt)は、テキストから画像の逆の処理です。AIが画像を見て、よく似た絵を生成できるテキストのプロンプトを、被写体・場所・光・カメラ・スタイルまで含めて書き出します。

レイヤーに分かれたプロンプト

画像からプロンプトは、被写体・場所・光・カメラ・スタイル、そして画像内の文字を別々の行で返します。1行を書き換えたりオフにしたりすると、全文もすぐに変わります。

1回の分析で4つの形式

自然な文章、キーワードタグ、--ar 付きの Midjourney プロンプト、動きを加えた動画プロンプトが、すべて同じ 1 クレジットの分析から出てきます。

保存されたプロンプトを原文のまま

AUTOMATIC1111、ComfyUI、NovelAI、InvokeAI のファイルには、作成時のプロンプトが残っていることがよくあります。AIに推測させる前に、ブラウザでそれを読み取ります。

ワンクリックで生成

プロンプトを Seedream 5.0 Flash に送れば1枚 5 クレジット。画像を参照に使うことも、動画にすることもできます。

私たちのテスト

プロンプトで元の画像を再現できる? 2つの実テスト

プロンプトがわかっている画像を2枚用意し、それぞれ画像からプロンプトにかけて、返ってきたプロンプトで描き直しました。各1回だけで、結果は選んでいません。

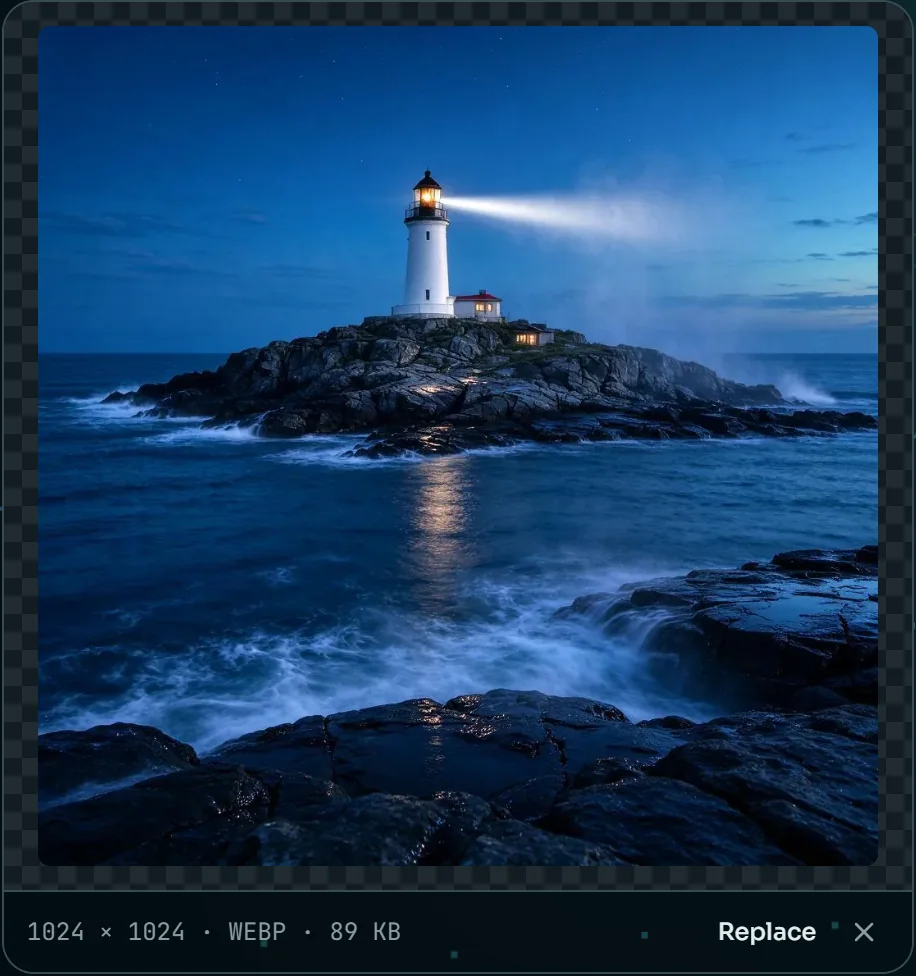
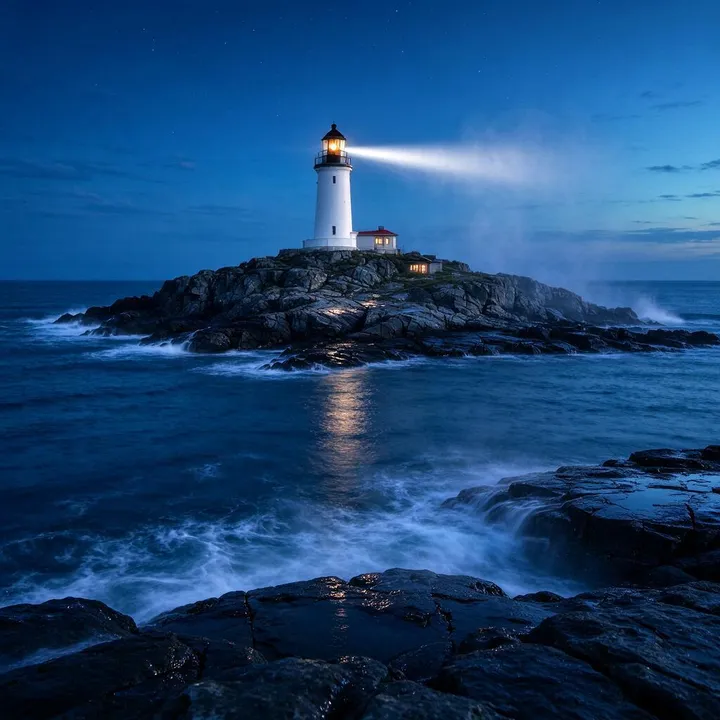
写真:灯台

元の画像:ブルーアワーの岩の島に立つ灯台。光の筋が薄い霧を切り裂いている
元の画像(当サイトのテキストから画像ページで作成)
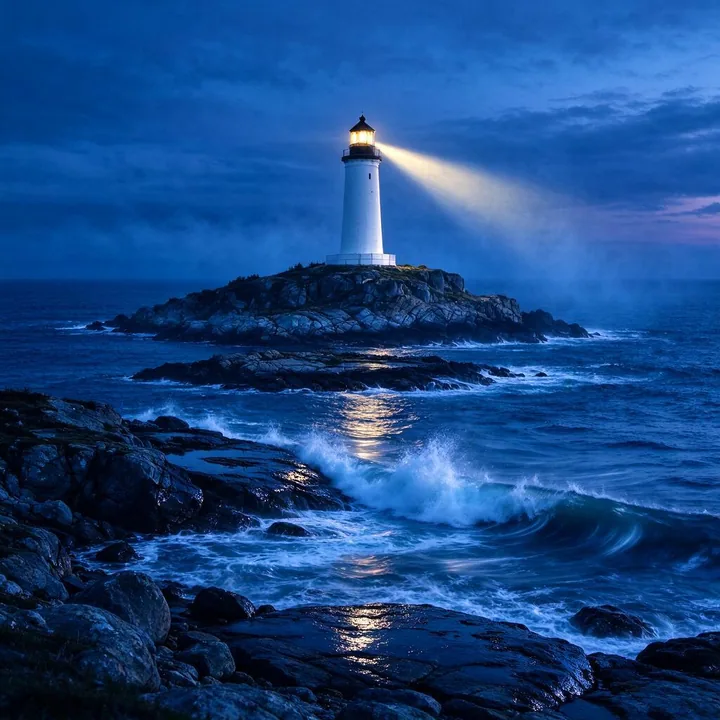
抽出したプロンプトで描き直した画像:夕暮れの岩の島に立つ白い灯台。手前の岩に波が砕けている
抽出したプロンプトから Seedream 5.0 Flash で描き直した画像

元の画像を作ったプロンプト · 英語 45 語

A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out, shot from a low angle with a wide 24mm lens, long exposure that smooths the water, cinematic colors

画像からプロンプトが書いたもの · 英語 82 語

A white lighthouse with a black roof and a glowing golden lantern room, on a rocky island surrounded by deep blue ocean water, with waves crashing against the shore at dusk, lit by the warm yellow beam of the lighthouse cutting through the mist and the cool blue ambient light of twilight, shot from a straight-on eye-level angle with a wide-angle lens, capturing the full island and foreground rocks, photograph with rich blue color grading, long exposure water effect, and sharp focus

  • 被写体: 灯台。色や灯室まで書き足された
  • 場所: 岩の島と、そこに打ち寄せる波
  • 光: 霧を抜ける光の筋と青い夕暮れ。「最初の星」は抜けた
  • カメラ: 広角レンズと長時間露光は残った。ローアングルは目線の高さになった

新しい画像には同じ島、同じ光の筋、同じ青い光があります。抽出したプロンプトのとおりカメラ位置が高くなり、手前に岩が広がりました。
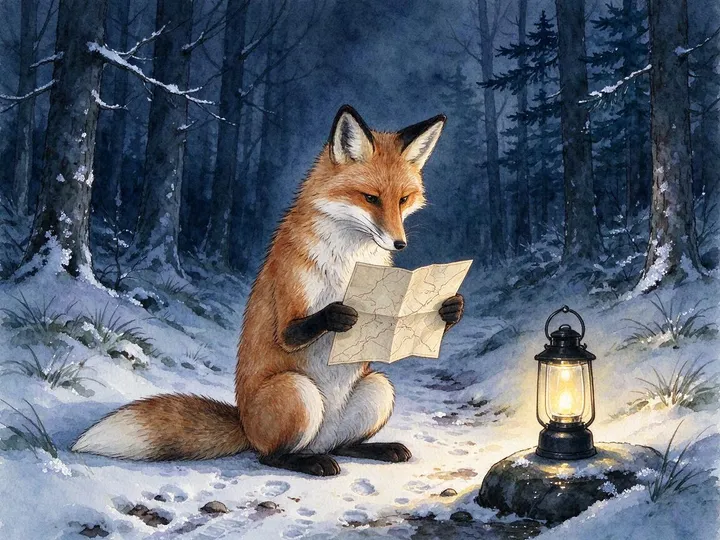
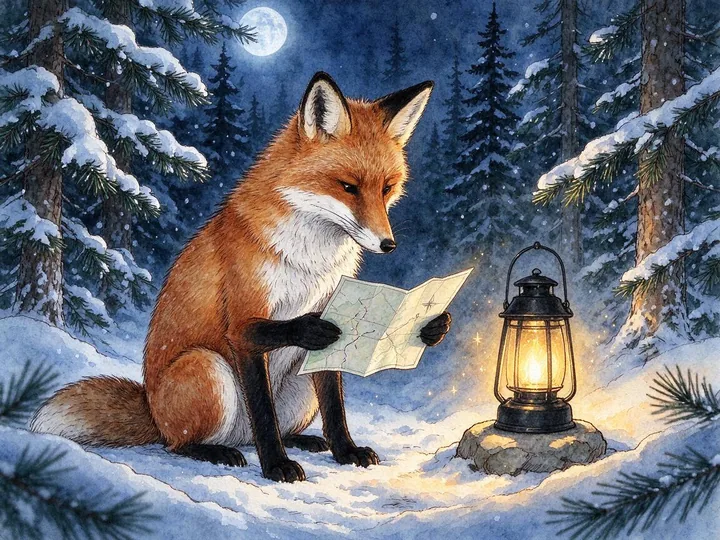
絵画:水彩のキツネ

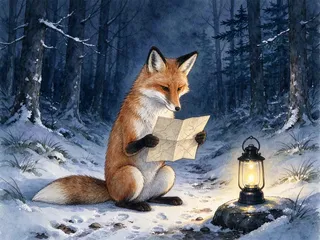
元の画像:雪の夜の森の小道で、小さなランタンの明かりで紙の地図を読む水彩の赤いキツネ
元の画像(当サイトのテキストから画像ページで作成)
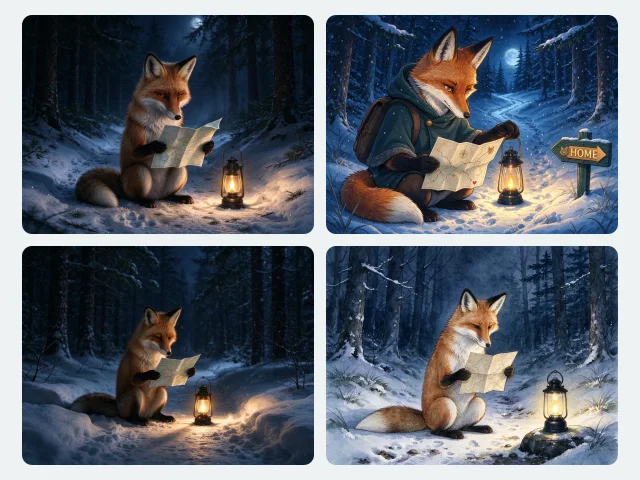
抽出したプロンプトで描き直した画像:石の上のランタンのそばで地図を読む水彩のキツネ。松の上に満月が出ている
抽出したプロンプトから Seedream 5.0 Flash で描き直した画像

元の画像を作ったプロンプト · 英語 24 語

A red fox sitting on a snowy forest path at night, reading a paper map by the light of a small lantern, Watercolor style

画像からプロンプトが書いたもの · 英語 80 語

A red fox with white chest fur and black paws, sitting upright and holding an open paper map, in a snowy pine forest at night, with a lit black metal lantern sitting on a stone beside it, warm golden light emanating from the lantern illuminating the fox and snow, contrasting with cool blue moonlight in the woods, eye-level medium shot focusing on the fox studying the map, detailed watercolor painting with soft washes, visible paper texture, and fine ink outlines

  • 被写体: 地図を読む赤いキツネ。白い胸元と黒い足も加わった
  • 場所: 夜の雪の森。小道は松林になった
  • 光: ランタンの明かり。加えて、元のプロンプトにない月明かり
  • スタイル: 水彩。柔らかなにじみ、紙の質感、インクの輪郭線が加わった

抽出したプロンプトは青い影を月明かりと読んだため、新しい絵には月が描かれました。それ以外は、石の上のランタンまで再現されています。

どちらのテストでも、画像からプロンプトは被写体・場面・スタイルを再現しました。ずれたのはカメラの角度と光源という判断の分かれる部分で、だからこそ各レイヤーを編集できるようにしています。

2026年11月5日に1回だけ実行:Gemini 3.5 Flash-Lite(詳しさ「詳しく」、英語)で 7.0 秒と 5.1 秒、続いて Seedream 5.0 Flash を初期設定で使用。各レイヤーの判定は、2つのプロンプトを見比べた私たちの読みです。

ファイルに保存

プロンプトを保存している画像もあります

多くのAI画像ツールは、保存するファイルにプロンプトを書き込みます。それが残っていれば、画像からプロンプトがブラウザで読み取り、原文のまま表示します。

ツールプロンプトの保存場所読み取れる内容
AUTOMATIC1111、ForgePNG のテキストチャンク「parameters」、JPEG と WebP は EXIF UserCommentプロンプト、ネガティブプロンプト、ステップ数、サンプラー、CFG スケール、シード、サイズ、モデル
FooocusPNG のテキストチャンク「parameters」(テキストまたは JSON)プロンプト、ネガティブプロンプト、モデル、シード、ステップ数
ComfyUIPNG のテキストチャンク「prompt」(ノードグラフの JSON)サンプラーのポジティブ・ネガティブ入力につながったテキスト、チェックポイント、シード、ステップ数
NovelAIPNG のテキストチャンク「Description」と「Comment」プロンプト、除外したい要素、ステップ数、シード、サンプラー、スケール
InvokeAIPNG のテキストチャンク「invokeai_metadata」(旧版は「sd-metadata」)プロンプト、ネガティブプロンプト、モデル、シード、ステップ数
このファイルに保存されていたプロンプトファイルのメタデータ
プロンプト
a lighthouse on a rocky island, blue hour, (long exposure:1.2)
ネガティブプロンプト
blurry, lowres, watermark
モデル · シード · ステップ数
sd_xl_base_1.0 · 1234567 · 28
AUTOMATIC1111 で保存されたファイルを画像からプロンプトで開いたときの表示。ここでは私たちのテスト用ファイルを使っています。

コンテンツ認証情報

Adobe Firefly や ChatGPT などのアプリで作った画像には、C2PA のコンテンツ認証情報が付いていることがあります。付いていればお知らせし、読み取れればアプリ名も表示します。署名の検証は公式の検証ツールで行ってください。

contentcredentials.org で検証する →

プロンプトが残っていないことが多い理由

ほとんどのSNSやチャットアプリはこの情報を削除します。スクリーンショットや、コピーを保存するときの多くの編集ソフトも同じです。その場合、画像からプロンプトは画像そのものから新しいプロンプトを書きます。

プロンプトの中身

画像プロンプトの構造

画像からプロンプトは、見えたものを6つのレイヤーに分けます。色分けは当サイトのテキストから画像ページと同じです。例はどれも、テストで Gemini が実際に書いた表現です。

被写体

何が、誰が写っているか:種類、色、服装、ポーズ、表情。いつも最初に来ます。

A white lighthouse with a black roof and a glowing golden lantern room

場所

どこで、周りに何があるか:場所、背景、小物、季節や時間帯。

on a rocky island surrounded by deep blue ocean water, with waves crashing against the shore at dusk

光

光はどこから来て、どんな雰囲気か:光源、向き、色、天気、空気感。

warm golden light emanating from the lantern illuminating the fox and snow, contrasting with cool blue moonlight in the woods

カメラ

どう切り取られているか:ショットの大きさ、角度、レンズ、被写界深度。絵画なら視点です。

shot from a straight-on eye-level angle with a wide-angle lens, capturing the full island and foreground rocks

スタイル

画材と仕上がり:写真、水彩、3Dレンダー、アニメなど。カラーグレーディングも含みます。

detailed watercolor painting with soft washes, visible paper texture, and fine ink outlines

文字

画像の中で読める文字。書かれたとおりに引用し、位置と見た目も添えます。

文字のない画像では省きます。今回の2つのテストもそうでした。

  • 被写体
  • 場所
  • 光
  • カメラ
  • スタイル
  • 文字

テキストから画像でレイヤーごとにプロンプトを組み立てる →

3ステップ

画像からプロンプトを取り出す3ステップ

画像からプロンプトは3ステップで、テストでは待ち時間が10秒未満でした。

  1. 灯台の写真を読み込んだ画像からプロンプトのツール。下にサイズと形式が表示されている
    01

    画像を追加する

    最大 10 MB の画像を、画像からプロンプトの枠にドロップ、貼り付け、または選択するか、画像のリンクを貼り付けます。ファイルにプロンプトが保存されていれば、すぐに表示されます。

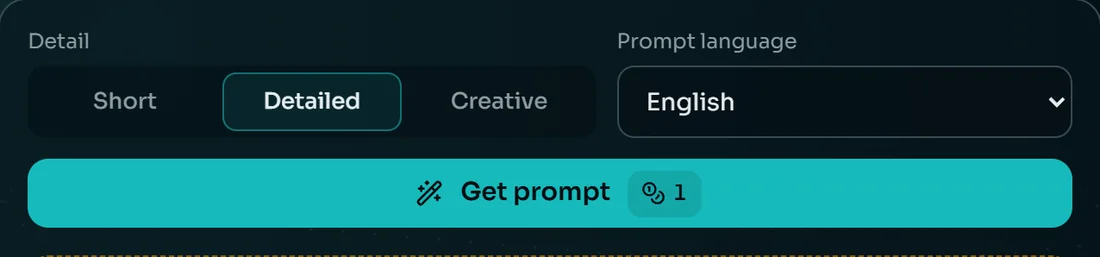
  2. 詳しさは「詳しく」、プロンプトの言語は英語。「プロンプトを取得」ボタンに価格が表示されている
    02

    詳しさと言語を選ぶ

    短め・詳しく・クリエイティブのいずれかと、18 の言語から1つを選び、「プロンプトを取得」を押します。1 クレジットで、すべての形式が一度に返ってきます。

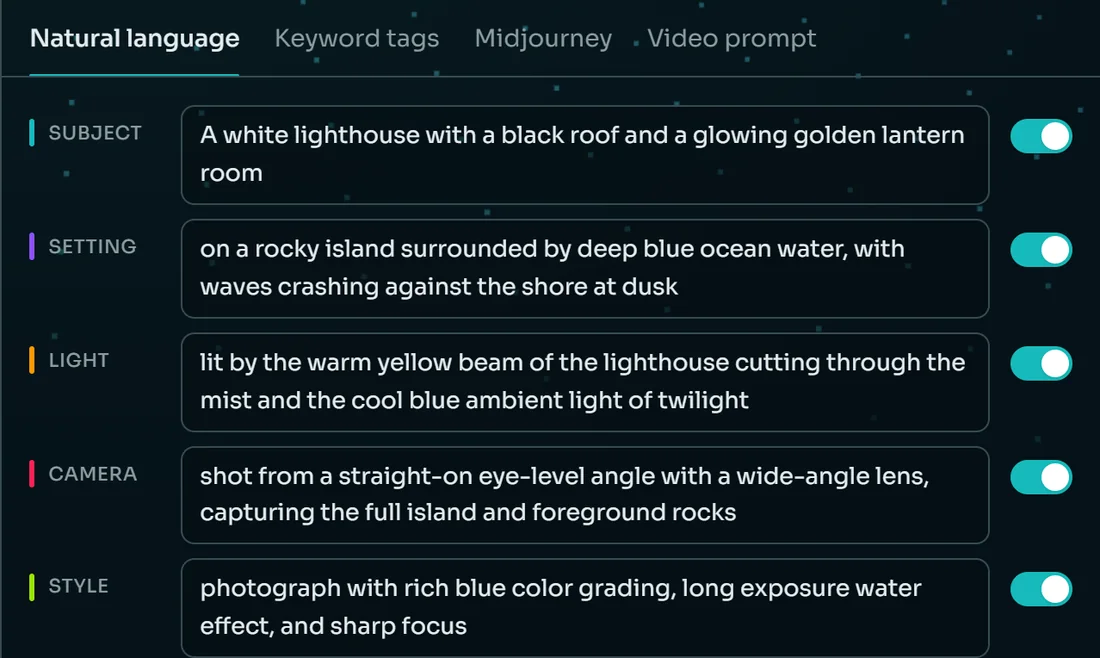
  3. 灯台のプロンプトが5つの色分けされたレイヤーに分かれ、それぞれにスイッチ。下に全文と生成ボタン
    03

    レイヤーを編集して生成する

    どのレイヤーも書き換えられ、不要なものはオフにでき、必要な形式をコピーできます。ワンクリックで Seedream 5.0 Flash に送ることもできます。

あなたの画像で画像からプロンプトを試す

4つの形式

自然な文章、キーワードタグ、Midjourney、動画プロンプト

画像からプロンプトの1回の分析で4つとも手に入るので、形式の切り替えに追加料金はかかりません。以下はテストの水彩のキツネで実際に出た結果です。

この4つのプロンプトのもとになった水彩のキツネ
1枚の画像、1回の読み取り、4通りの書き方。

自然な文章

Seedream、Nano Banana、GPT Image、Flux 向け。

A red fox with white chest fur and black paws, sitting upright and holding an open paper map, in a snowy pine forest at night, with a lit black metal lantern sitting on a stone beside it, warm golden light emanating from the lantern illuminating the fox and snow, contrasting with cool blue moonlight in the woods, eye-level medium shot focusing on the fox studying the map, detailed watercolor painting with soft washes, visible paper texture, and fine ink outlines

当サイトの画像ジェネレーターでそのまま使えます。

キーワードタグ

Stable Diffusion などタグで指示するモデル向け。

red fox, reading map, snowy forest, winter night, lantern light, watercolor illustration, animal fantasy, cozy atmosphere, pine trees, snow, stone, sitting fox, detailed painting, blue and gold

AUTOMATIC1111、ComfyUI など、タグ入力欄に貼り付けます。

Midjourney

自然な文章に、画像の比率を表す --ar を付けたもの。

A red fox with white chest fur and black paws, sitting upright and holding an open paper map, in a snowy pine forest at night, with a lit black metal lantern sitting on a stone beside it, warm golden light emanating from the lantern illuminating the fox and snow, contrasting with cool blue moonlight in the woods, eye-level medium shot focusing on the fox studying the map, detailed watercolor painting with soft washes, visible paper texture, and fine ink outlines --ar 4:3

比率はあなたの画像から自動で計算します。

動画プロンプト

場面、続いて何が動くか、カメラがどう動くか。

A red fox with white chest fur and black paws, sitting upright and holding an open paper map, in a snowy pine forest at night, with a lit black metal lantern sitting on a stone beside it, warm golden light emanating from the lantern illuminating the fox and snow, contrasting with cool blue moonlight in the woods, eye-level medium shot focusing on the fox studying the map, detailed watercolor painting with soft washes, visible paper texture, and fine ink outlines. The lantern flame flickers and casts soft moving light across the snow and the fox holding the map. Slow subtle zoom in on the fox.

画像から動画で、あなたの画像を最初のフレームにして使います。

次にすること

プロンプトの使い道

プロンプトは何かを作ってこそ役に立ちます。どれを開いても、画像からプロンプトの結果が入力済みの状態で始まります。

新しい画像を生成する

テキストから画像の Seedream 5.0 Flash で1枚 5 クレジット。比率はあなたの画像に最も近いものになります。

テキストから画像 →

画像を参照にする

画像から画像は、あなたの画像の構図を保ったまま、プロンプトのとおりに内容を変えます。これを選ぶと画像がアップロードされます。

画像から画像 →

動かす

画像から動画は、あなたの画像から始めて、動画プロンプトの動きとカメラワークに沿って動かします。

画像から動画 →

プロンプトの書き方を学ぶ

テキストから画像のプロンプトビルダーで、同じ6つのレイヤーを一から1つずつ選んで組み立てられます。

プロンプトビルダー →

あなたの画像

画像はどう扱われるか

画像からプロンプトは、画像を1か所に、1つの目的のためだけに送り、私たちは何も残しません。

  1. 01

    ブラウザで読み取る

    AIを使う前に、画像からプロンプトは保存されたプロンプトとコンテンツ認証情報をあなたの端末で読み取ります。何もアップロードせず、ログインも不要です。

  2. 02

    Gemini へ送り、保存しない

    「プロンプトを取得」は、長辺 1,536 ピクセル以下に縮小したコピーを Google の有料 Gemini API に送ります。私たちは保存せず、ログにも残しません。

  3. 03

    頼まれたときだけアップロード

    「参照画像として使う」と「この画像を動かす」は画像を当サイトのストレージに置く必要があるため、その時点でアップロードします。ジェネレーターに画像を追加するときと同じです。

“Google doesn't use your prompts (including associated system instructions, cached content, and files such as images, videos, or documents) or responses to improve our products.”
Gemini API Additional Terms of Service、有料サービス、2026年3月23日発効

要旨:Google は、有料サービスのプロンプト(画像などのファイルを含む)と回答を、自社製品の改善には使いません。同じ規約には、違反の検出、サービスの安全確保、法的な要請への対応のため、Google がプロンプトと回答を一定期間記録するとも書かれています。

画像からプロンプトのよくある質問

ファイルにプロンプトが保存されている場合だけで、そのときは原文のまま表示します。それ以外は、画像からプロンプトが似た画像を生成できる新しいプロンプトを書きます。上のテストがその例です。


被写体・場面・スタイルは再現できますが、シードやモデルが違うため、ピクセルまで同じにはなりません。テストでは2枚とも内容は一致し、カメラの角度と光源の読み取りだけが異なりました。


自然な文章は Seedream、Nano Banana、GPT Image、Flux 向けで、どれも当サイトのジェネレーターで使えます。キーワードタグは Stable Diffusion 向け、Midjourney 形式は --ar 付き、動画プロンプトは画像から動画のモデル向けです。


はい。ファイルを保存し直したり、チャットアプリで送ったりしていなければ読めます。AUTOMATIC1111、Forge、Fooocus、ComfyUI、NovelAI、InvokeAI のファイルをブラウザで読み取り、ログインもクレジットも不要です。


いいえ。見た目、服装、ポーズは描写しますが、有名人かどうかに関わらず名前は決して書かず、民族などの機微な特徴も推測しません。


いいえ。分析のために Google の有料 Gemini API へ送られますが、私たちは何も保存しません。Google の規約でも、有料サービスのファイルは製品の改善に使わないとされています。アップロードするのは「参照画像として使う」か「この画像を動かす」を選んだときだけです。


最大 10 MB の JPG、PNG、WebP、GIF、AVIF、HEIC、または JPG・PNG・WebP 画像へのリンクです。大きな画像は、送る前にブラウザで長辺 1,536 ピクセルに縮小します。


画像1枚につき 1 クレジットで、すべての形式がこの1回の分析から出てきます。分析に失敗した場合は返却され、ファイルに保存されたプロンプトの読み取りは無料でアカウントも不要です。


あなたの画像をプロンプトに

画像を追加して「プロンプトを取得」を押し、レイヤーを編集するだけ。1 クレジットで、分析に失敗したら返却されます。