 Anyscene AI
テキストから画像 AI
見たいものを文章で書けば、画像になって返ってきます。テキストから画像を生成するすべてのモデルが1つの入力欄を共有し、料金は押す前からボタンに表示されています。
作例から試す
1つのプロンプト、6つのスタイル
同じテキストから画像プロンプトを6つのスタイルで
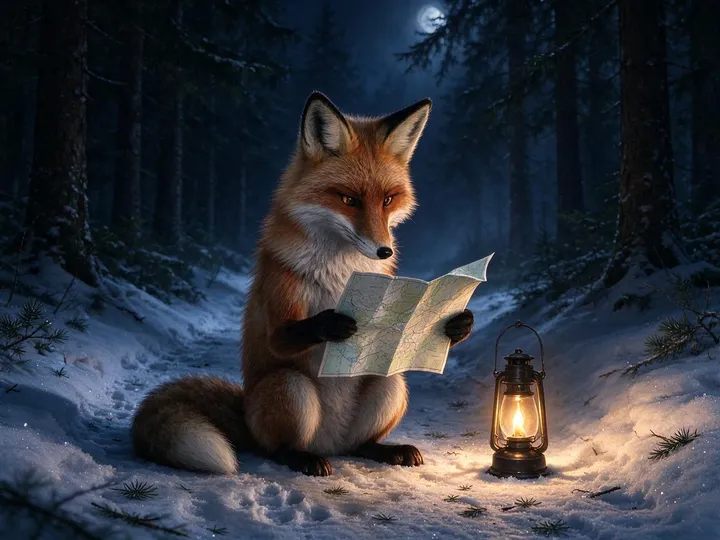
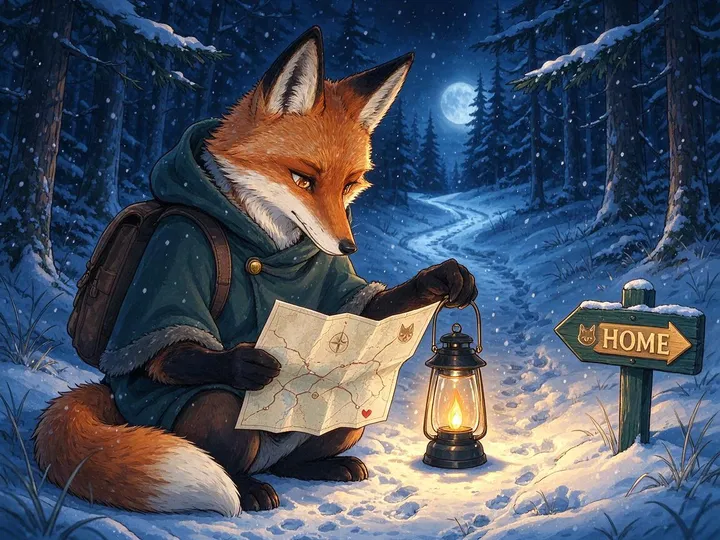
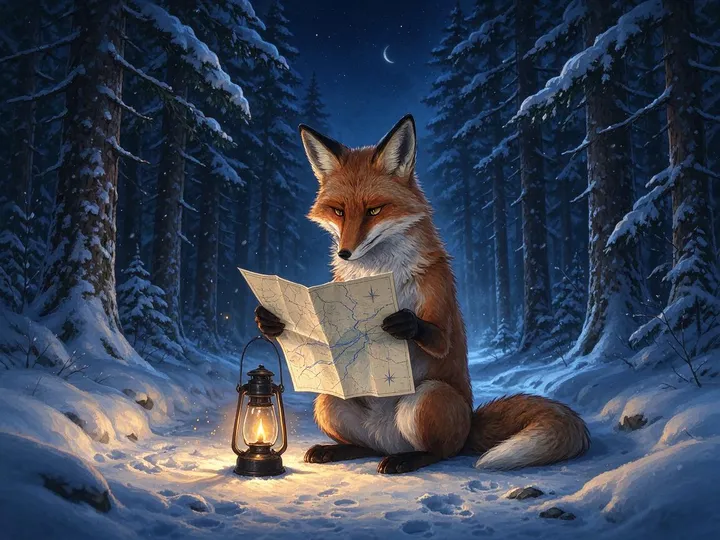
ジェネレーターのスタイルメニューは、プロンプトの末尾に短いフレーズを1つ加えます。同じキツネのプロンプトを、このページの標準モデルであるSeedream 5.0 Flashで6つのスタイルすべてに通し、そのフレーズで画像がどこまで変わるかを確かめました。
実際に送ったプロンプト
A red fox sitting on a snowy forest path at night, reading a paper map by the light of a small lantern, [style] style
- 被写体
- 場所
- 光
- スタイル
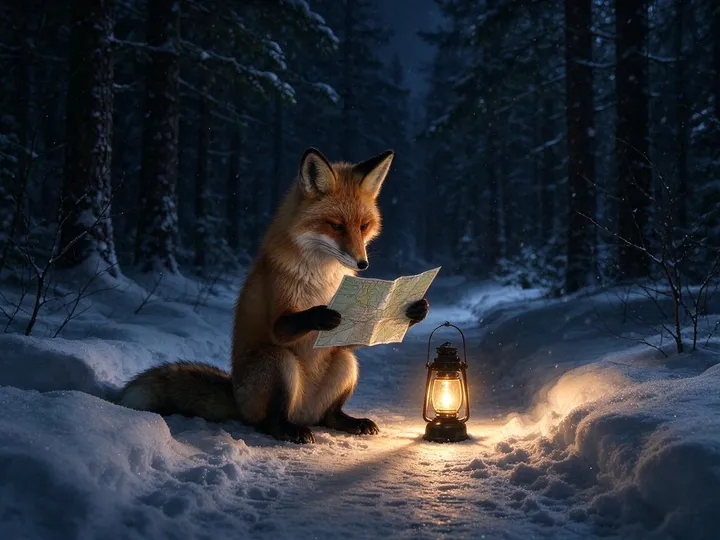
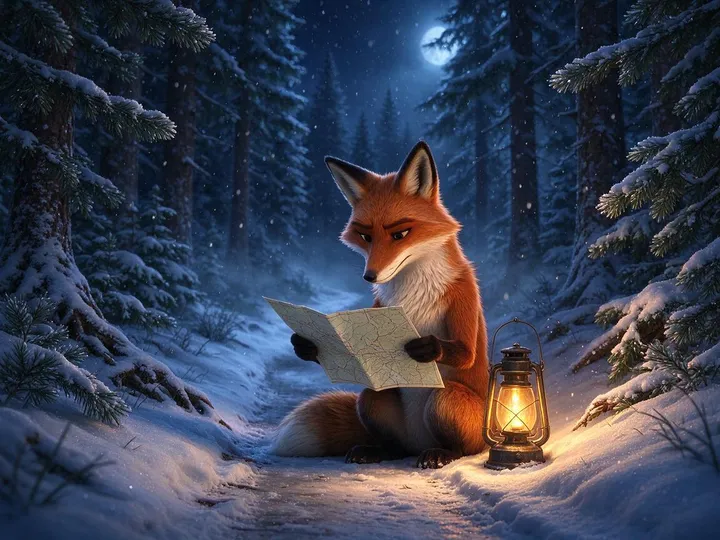
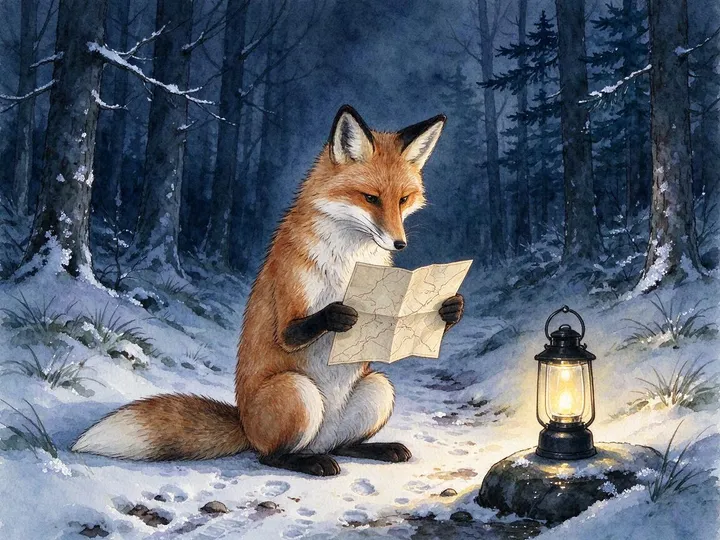
変わったところ、変わらなかったところ
- いちばん大きく変わったのはアニメです。キツネはフード付きのコートを着てリュックを背負い、HOMEと書かれた道標まで現れました。どれもプロンプトにはありません。
- 水彩は輪郭がやわらかくなり、雪が明るくなりましたが、構図は同じでした。
- デジタルアート、シネマティック、3Dモデルの3枚は、フォトリアルとほとんど変わりません。このモデルでは、スタイルの言葉は指示ではなく、軽く押す程度の働きです。
- スタイルが効かないときは、素材を直接書きます。「やわらかな粘土の質感とスタジオ照明の3Dレンダリング」のほうが、「3Dモデルスタイル」よりずっと伝わります。
2026年10月23日に行ったテキストから画像の生成6回。スタイルごとに1回ずつで、やり直しもレタッチもしていません。1枚あたり14〜25秒でした。
ひとことで言うと
テキストから画像を生成するAIとは?
AIによるテキストから画像の生成は、生成AIのうち「描く」部分です。言葉で画像を説明すると、モデルがそれを描きます。
テキストから画像を生成するAIは、文章による説明(プロンプト)を新しい画像に変えるソフトウェアです。説明文つきの画像を数百万枚学習したモデルがプロンプトを読み取り、それに合うピクセルを生成します。写真でもイラストでも、文字入りのポスターでも、比率は自由に選べます。
あなたのプロンプト
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out, shot from a low angle with a wide 24mm lens, long exposure that smooths the water, cinematic colors
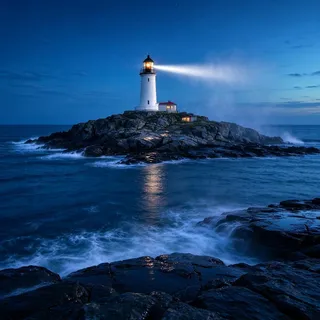
拡散モデルのしくみを簡略化した図で、実際の生成途中の画像ではありません。最後の1枚は、下のステップ4の灯台です。
ノイズを取り除いていくモデル
Flux、Seedream、Qwen Imageをはじめ、テキストから画像を生成するモデルの多くは拡散モデルかフローモデルです。ノイズから出発し、プロンプトに導かれながら段階的に仕上げていきます。新しいモデルは前段に言語モデルを置き、世界についての知識を使ってプロンプトを読み取ります。
"The model couples the Mistral-3 24B parameter vision-language model with a rectified flow transformer."
Black Forest Labs、FLUX.2の発表記事チャットボットに組み込まれたモデル
OpenAIのGPT Imageシリーズは、別の画像モデルをつないだものではなく、ChatGPTを動かすGPT-4oに組み込まれた画像生成から始まりました。OpenAIによれば、詳しい指示に従うことができ、画像に文字を入れることも確実にこなせます。
"…because it is embedded natively, deep in the architecture of our omnimodal GPT‑4o model, 4o image generation can use everything it knows…"
OpenAI、4o画像生成のシステムカードおかしな手や崩れた文字の直し方まで載った、詳しい解説も読みたい方は テキストから画像ガイドを読む →
4ステップ、1つのプロンプト
テキストから画像のプロンプトが具体的になっていく様子
短いプロンプトでは、すべての選択がモデル任せになります。下のステップでは、同じ灯台のプロンプトに1種類ずつ詳細を足していきます。新しく加えた言葉には印をつけ、前の言葉はグレーにしています。
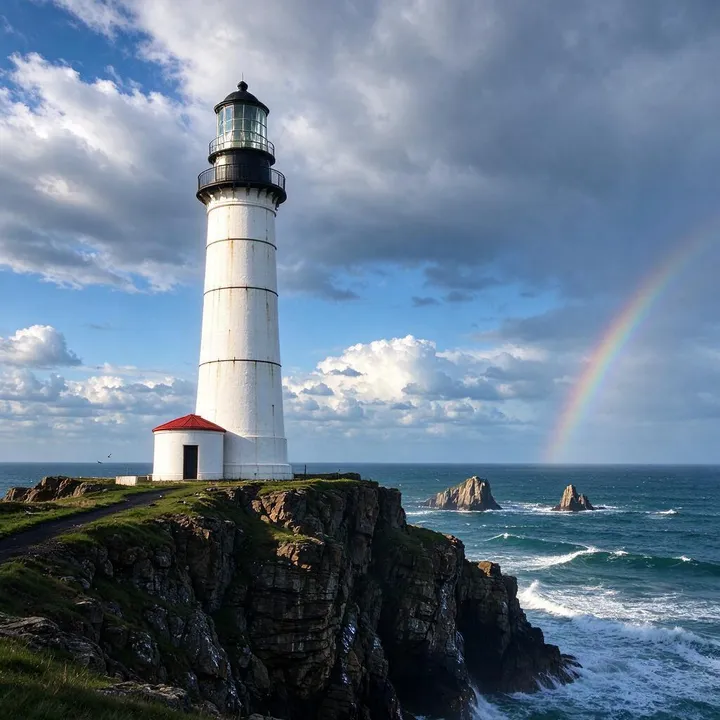 1 / 4
1. 被写体だけ
A lighthouse
2語だけでは、晴れた崖の上の灯台と虹になりました。それ以外はすべて、モデルがいちばんありふれた灯台の絵で埋めています。
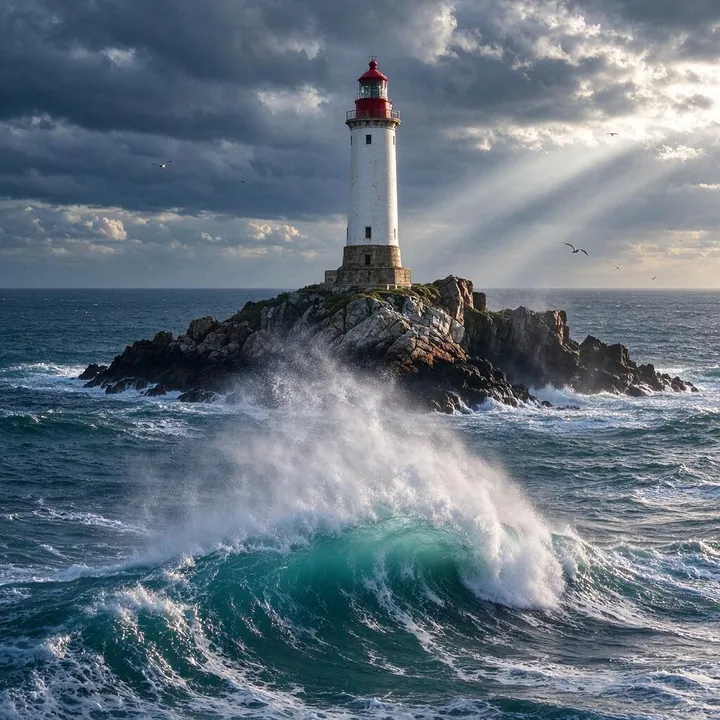 2 / 4
2. 場所を加える
A lighthouse on a rocky island, waves breaking against the rocks below
場所を書くと、灯台は沖の岩場に移り、手前に砕ける波が加わりました。
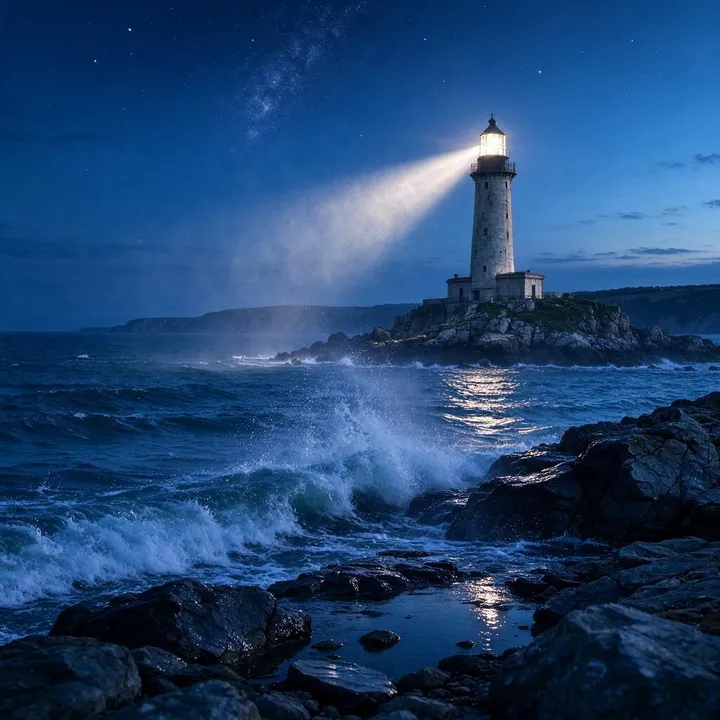 3 / 4
3. 光と時間を加える
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out
ブルーアワー、霧、星で、雰囲気ががらりと変わりました。今回の生成では、このステップでの変化がいちばん大きくなりました。
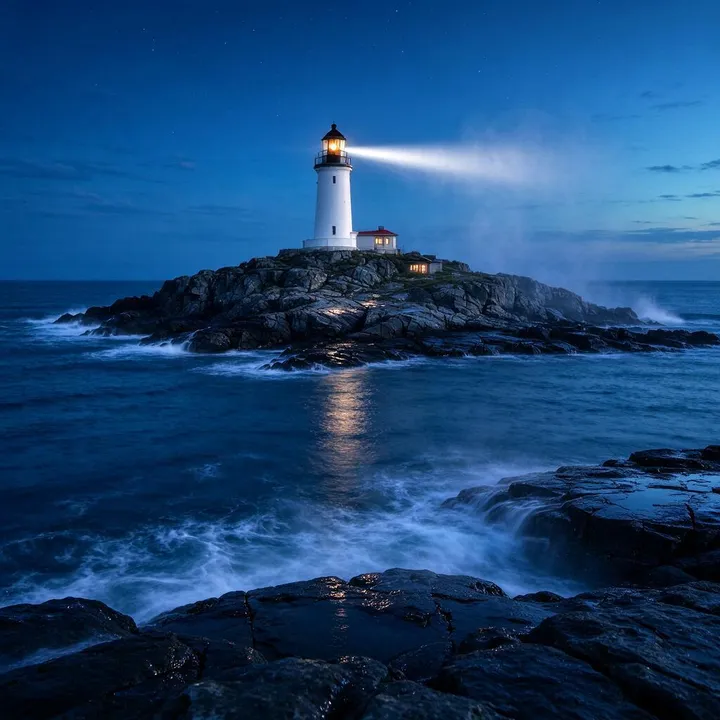 4 / 4
4. カメラを加える
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out, shot from a low angle with a wide 24mm lens, long exposure that smooths the water, cinematic colors
長時間露光で水面はなめらかになりましたが、24mmのローアングルはほとんど表れていません。このモデルがいちばん従わなかったのはカメラの言葉でした。
Seedream 5.0 Flash、1:1。2026年10月23日に各ステップ1回ずつテキストから画像を生成し、1枚あたり14〜19秒でした。
プロンプトビルダー
テキストから画像のプロンプトを組み立てる
何を書けばいいか迷ったら。このテキストから画像のプロンプトジェネレーターは、被写体を1つ書いて各グループからフレーズを選ぶだけで、プロンプトが組み上がります。ページ上部のジェネレーターに送ることも、コピーすることもできます。
あなたのプロンプト
陶器のコーヒーマグ、窓辺の木のテーブルの上、やわらかな朝の光
- 被写体
- 場所
- 光
- カメラ
- スタイル
- 文字
- 被写体はいちばん前に。前に置いた言葉が主役と取り違えられないようにします。
- 場所も光もスタイルも1つずつ。スタイルが2つあると互いに引っぱり合います。
- 雰囲気ではなく、目に見えるものを書きます。「霧と低い太陽」のほうが「エモい感じ」より効きます。
- 画像に描く文字はかぎかっこで囲み、なるべく短くします。
画像の中の文字
AI画像の文字を正しく綴らせるには
看板、ラベル、ポスターのタイトルは、かつてテキストから画像AIがいちばん苦手としたところです。いまのモデルは、プロンプトの書き方さえ合っていれば短い文字を正しく描けます。下の4枚がその例です。
01
入れる文字はそのまま引用符で囲む
引用符は、テキストから画像モデルに「これは表す意味ではなく、描く文字だ」と伝えます。本とお茶についての看板ではなく、「Books & Tea」と書かれた看板、と書きます。
02
文字をどこに置くかを書く
手描きの看板に、ラベルに、ポスターの上部に。置き場所のない文字は、宙に浮いたり、思わぬ場所に入ったりします。
03
書体を説明する
手書き風、太字、上品なセリフ体。書体の名前があると、モデルは合わせる手がかりを得て、文字の形もそろいます。
04
短くして、1字ずつ確かめる
下の例で引用符の中の文字は、どの行も英単語6語以内です。頼んでいない文字が加わることもあります。Seedream 5.0 Proは、コーヒーのインフォグラフィックにサブタイトルと説明文を足しました。
 1
 2
 3
 4
1Nano Banana Pro16:9
A cozy bookshop storefront on a cobblestone street at dusk, a hand-painted sign reading "The Paper Lantern — Books & Tea", warm light spilling from the windows, a bicycle leaning against the wall
2GPT Image 2.52:3
A vintage travel poster for Kyoto: a five-storey pagoda among cherry blossoms at sunset, the title "KYOTO" in bold letters at the top and "Cherry Blossom Season" at the bottom, flat screen-print style
3Nano Banana Pro4:5
A kraft-paper coffee bag on a café counter, the label printed with "MORNING RITUAL — Single Origin, Ethiopia" in an elegant serif, soft morning light, shallow depth of field
4Qwen Image 3.03:4
A chalkboard café menu titled "Morning Menu" listing Espresso 3.00, Latte 4.50 and Croissant 3.50, hand-lettered, warm café light
モデルページの生成結果で、どれも1回ずつ生成したものです。引用符の中の文字はすべて書いたとおりに出ましたが、公開前にはご自身の綴りも確かめてください。
すべてのモデルと料金
テキストから画像のモデルはどれを選ぶか
17のモデルはどれも同じプロンプトを受け付けます。違うのは得意なこと、必要なクレジット、返ってくる画像の大きさです。下の表のクレジット、サイズ、利用できるアカウントは、生成ボタンが使っているのと同じ料金表から取っています。
表を横にスワイプすると、すべての列を見られます。
| モデル | 得意なこと | 1枚のクレジット | 最大サイズ | 利用できる範囲 |
|---|---|---|---|---|
| Basic | アイデアを試す手早い下書き | 2クレジット | 1K | すべてのアカウント |
| Z-Image | テキストだけで作る低価格の画像 | 2クレジット | 1K | すべてのアカウント |
| Seedream 5.0 Flash | 低価格で日常使いの画像。このページの標準のテキストから画像モデル | 5クレジット | 2K | すべてのアカウント |
| GPT Image 1.5 | 長く細かいプロンプトに忠実 | 6クレジット | 1K | いずれかのプランまたはクレジットパック |
| Nano Banana | ふつうの場面と、被写体を変えない編集 | 6クレジット | 1K | いずれかのプランまたはクレジットパック |
| Nano Banana 2 Lite | シンプルな場面や料理の写真を、Nano Bananaでいちばん安く | 6クレジット | 1K | すべてのアカウント |
| Wan 2.7 Image | 低価格で日常使いに十分な品質。Pro版はさらに精細 | 6〜20クレジット | 4K | いずれかのプランまたはクレジットパック |
| Flux 2 | 写真のようなディテール(Pro)と、もっとも精緻なタイポグラフィ(Flex) | 8〜36クレジット | 2K | いずれかのプランまたはクレジットパック |
| GPT Image 2 | きれいな文字、レイアウト、UIモックアップ | 8〜22クレジット | 4K | いずれかのプランまたはクレジットパック |
| Nano Banana 2 | 初代Nano Bananaより鮮明なディテール | 8〜22クレジット | 4K | いずれかのプランまたはクレジットパック |
| Qwen Image 3.0 | 文字入りのメニュー、看板、ポスターを中くらいの価格で | 8クレジット | 2K | いずれかのプランまたはクレジットパック |
| GPT Image 2.5 | 文言を一字一句そのまま入れたいポスターやアプリ画面 | 10〜26クレジット | 4K | いずれかのプランまたはクレジットパック |
| Seedream 5 Lite | 最大3Kの大きく精細な画像 | 10〜14クレジット | 3K | いずれかのプランまたはクレジットパック |
| Seedream 5.0 Pro | 自然な肌の質感のポートレートと、インフォグラフィック | 11〜22クレジット | 2K | いずれかのプランまたはクレジットパック |
| Nano Banana Pro | いちばん難しいプロンプトと、小さく正確な文字 | 29〜38クレジット | 4K | いずれかのプランまたはクレジットパック |
テキストから画像のモデルは全部で17種類。まだ使っていないモデルは、そのモデルのページで実際の生成例を見られます。
テキストを画像にする3つのステップ
最初の1語から画像のダウンロードまで、テキストから画像は3ステップ。標準モデルなら待ち時間は30秒もかかりません。
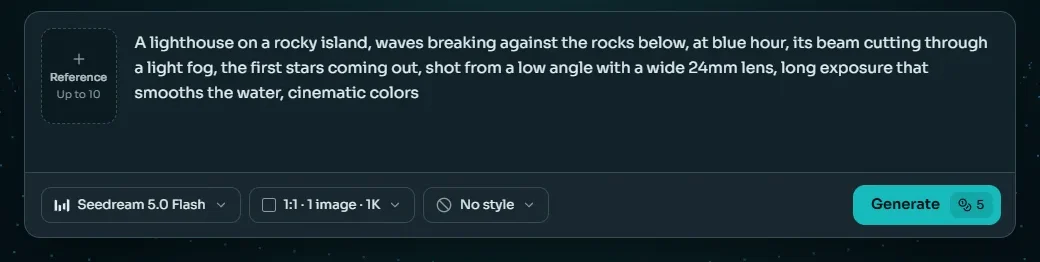
ステップ1:プロンプトを書く
ページ上部のテキストから画像の入力欄に、画像に描くものを書きます。まず被写体、それから場所、光、スタイル。思いつかなければ、プロンプトビルダーか、入力欄の下の例から始めましょう。
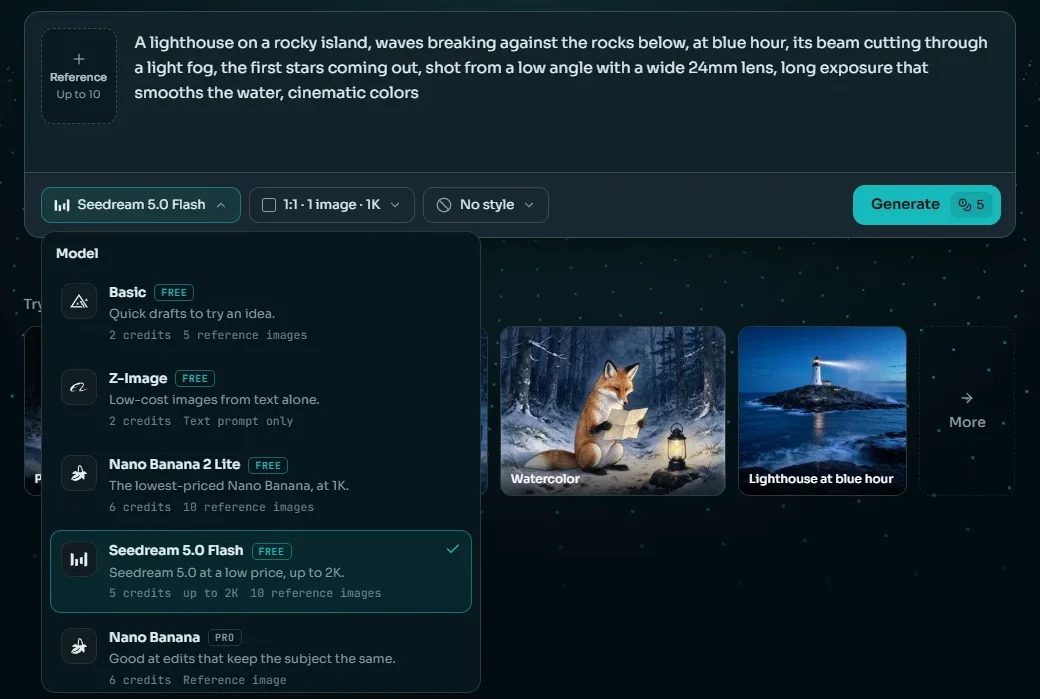
ステップ2:モデル、比率、スタイルを選ぶ
最初はSeedream 5.0 Flashが選ばれています。最初のボタンでモデルを切り替え、バナーなら16:9、ストーリーなら9:16のように比率を選び、必要ならスタイルを加えます。生成ボタンの料金も合わせて変わります。
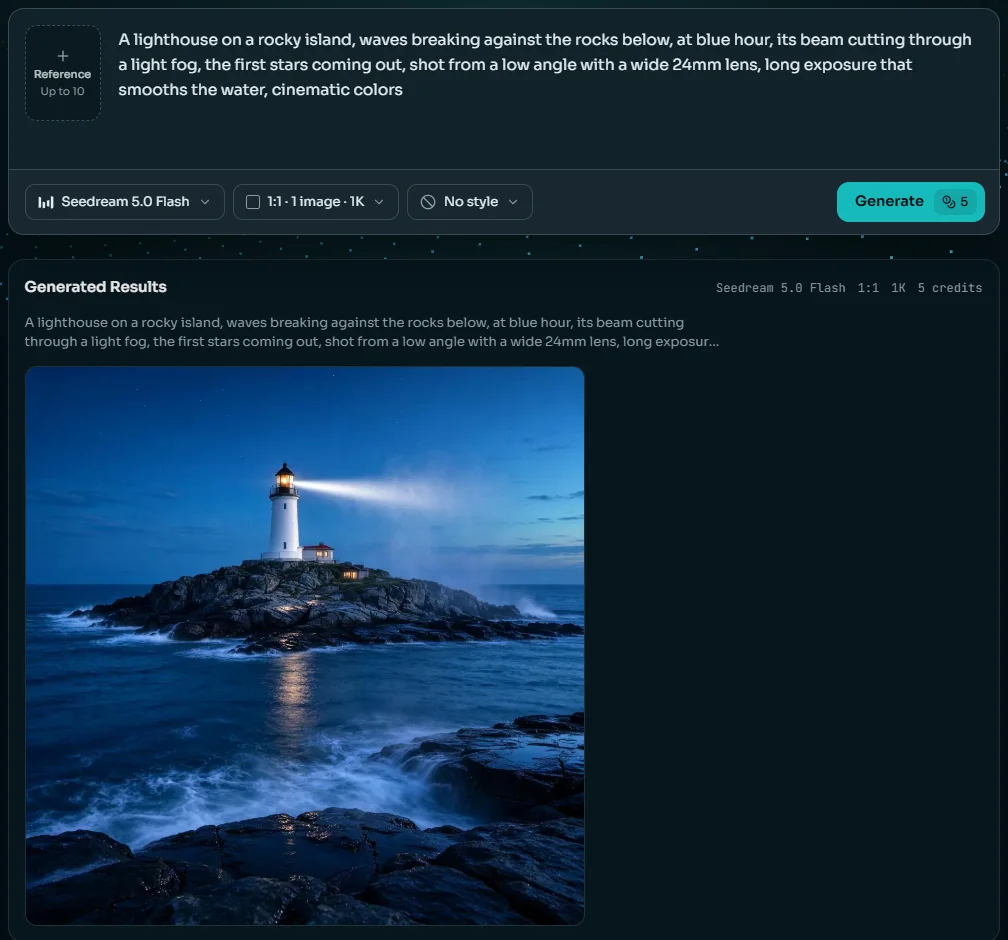
ステップ3:生成し、比べて、直す
生成を押すと、入力欄の下に画像が、それを作ったプロンプトと一緒に表示されます。プロンプトの一部を変えてもう一度生成したり、同じ文章で別のモデルを試したり、結果をエディター、高画質化、動画に回したりできます。
みんなが作っているもの
テキストから画像AIで作られているもの
モデルページにある、実際のテキストから画像の生成結果6枚。それぞれ、次によく使うツールを添えています。


画像を作る3つの方法
テキストから画像、画像から画像、それともAI画像編集?
テキストから画像、画像から画像、画像編集は、どれも同じモデルで動いています。何から始めるかで、使うべきものが決まります。
| テキストから画像 | 画像から画像 | AI画像編集 | |
|---|---|---|---|
| 始めるもの | 言葉だけ | 言葉と、1枚以上の参考画像 | あなたの写真と、1つの指示 |
| 変わらないもの | なし。毎回新しい画像 | 参考画像の被写体、雰囲気、レイアウト | 変更を頼まなかったすべて |
| 向いていること | 新しいアイデア、ポスター、ゼロからの場面 | 別の画像のスタイルや被写体で新しい画像を作る | 実際の写真を変える:背景、服、文字、光 |
| 同じキャラクターをもう一度 | 難しい。毎回くわしく説明する | 参考画像があるので比較的かんたん | 写真の中のその人そのもの |
| Anysceneのどこで | このページ | 同じ入力欄で参考画像を追加 | AI画像編集のページ |
参考画像の枠に画像を入れると、このページのテキストから画像ジェネレーターは画像から画像になります。生成ボタンには新しい料金が表示されます。
正直な限界
テキストから画像がまだつまずくところ
どのテキストから画像モデルにも、苦手なことがあります。ここでは私たちがいちばんよく見る6つを、それぞれの対処法とともに紹介します。
長い文字
1文まるごとや、小さな文字の段落は、いまでも崩れます。引用符の中は1行ずつ短くするか、あとからエディターで文字を入れましょう。
正確な数
「7羽の鳥」が5羽にも9羽にもなります。数が少ないほど安定します。多いときは、結果を数えて、違っていればもう一度生成しましょう。
人混みの中の手と顔
画面に1人なら、たいていうまくいきます。崩れやすいのは集団の中の小さな顔や手なので、人物を近づけるか、人数を減らしましょう。
左右と前後
「犬の左にいる猫」は、思っているほど守られません。画面のどこに何があるかを書き、ずれたらエディターで動かしましょう。
実在の人物とブランド
実在の人物、ロゴ、自分のものではないキャラクターの名前を出したプロンプトは拒否されることがあり、そうした画像を使うと誰かの権利を侵害するおそれもあります。名前ではなく、見た目を書きましょう。
すべてのテキストから画像モデルを1つの残高で
画像1枚はモデルとサイズにより2〜38クレジット、標準モデルなら5クレジット。プランは年払いで月あたり$15.9から。クレジットパックでどのプランにも追加できます。
表示価格は年払いの月額換算です。月払いの料金とクレジットパックは料金ページでご確認ください。
テキストから画像AIのよくある質問
文章による説明を新しい画像に変えるAIです。プロンプトを入力すると、説明文つきの画像で学習したモデルがそれに合う画像を生成し、ダウンロード、編集、動画化ができます。
多くのモデルは拡散モデルかフローモデルで、ランダムなノイズから始め、プロンプトに導かれながら少しずつノイズを取り除きます。OpenAIのGPT Imageシリーズのように言語モデルに組み込まれた新しいモデルもあり、長い指示や画像の中の文字に強みがあります。
唯一の正解はありません。日常の画像なら標準のSeedream 5.0 Flash(5クレジット)から。文字を入れるならNano Banana ProかGPT Image 2.5、ポートレートならSeedream 5.0 Pro、アイデアを試すなら2クレジットのBasicかZ-Imageがおすすめです。
BasicとZ-Imageの2クレジットから、4KのNano Banana Proの38クレジットまで。標準モデルは5クレジットです。料金は押す前から生成ボタンに表示され、失敗した画像のクレジットは戻ります。新しいアカウントには40クレジットがあり、無料アカウントに開放されている4つのモデル(Basic、Z-Image、Seedream 5.0 Flash、Nano Banana 2 Lite)に使えます。
はい。Anysceneで作ったものはすべて、広告、商品ページ、SNS投稿などで商用利用できます。権利を持たない実在の人物、ロゴ、キャラクターをプロンプトで指定するのはやめましょう。画像を作っても、その権利が得られるわけではありません。
入れる文字をそのまま引用符で囲み、置く場所と書体を書き、1行を短くします。私たちのモデルページでは、Nano Banana Pro、GPT Image 2.5、Qwen Image 3.0が、引用符の中の文字をすべて正しく描きました。公開前には原寸で1字ずつ確かめてください。
はい。ほとんどのモデルは、英語に加えて日本語、中国語、韓国語、スペイン語、フランス語、ドイツ語、ポルトガル語のプロンプトも読めます。モデルが読み違えたときは、同じプロンプトを英語で試してください。画像に描く文字は、表示したいとおりの形で引用符に入れるのが確実です。
テキストから画像は言葉だけから始めるので、毎回新しい画像になります。画像から画像は参考画像を加え、その画像の被写体、スタイル、レイアウトを引き継ぎます。同じ入力欄で参考画像を加えれば切り替わります。
モデルによります。BasicとZ-Imageは約1K、Seedream 5.0 Flashは最大2K、Nano Banana 2、Nano Banana Pro、GPT Image 2、GPT Image 2.5、Wan 2.7 Image Proは最大4Kです。結果は履歴に30日間残るので、残したいものはダウンロードしてください。
関連するAI画像ツール
同じクレジットで、画像ができたあとにやりたくなる次のこと。