
文章を1行入力する。1分後には、画像が手元にある。
2026年のテキストから画像へのAIが実際にやっていることは、これだけです。このガイドでは — モデルの選び方、ぼんやりした出力にならないプロンプトの書き方、6本指の手の修正、そして本物のサイトでそのまま使える画像を仕上げるところまで、すべてのステップを順に追います。
私たちはAnysceneを運営しています。だからこそ、何が効くかを掴むまでに、たくさんのひどい画像を生成してきました。これから書く内容は、初日に誰かが教えてくれていたら、と思うことの全てです。
短い版が欲しければ、このままスクロール。長い版が欲しければ、ブックマークを。
テキストから画像へのAIが実際にやっていること
ほとんどのチュートリアルはここを飛ばします。飛ばさないでください。モデルの形を理解すると、プロンプトの書き方が変わります。
拡散モデルの仕組み(普通の言葉で)
写真を1枚用意します。テレビの砂嵐のように見えるまでランダムノイズを足します。次に、ノイズを一層ずつ剥がしてもとに戻す方法をニューラルネットワークに教え込む — その間、テキストプロンプトが「下に何があるべきか」を伝えます。
これを学習中に数億回繰り返すと、Midjourney、Flux、Stable Diffusionが生まれます。仕掛けはそれだけです。
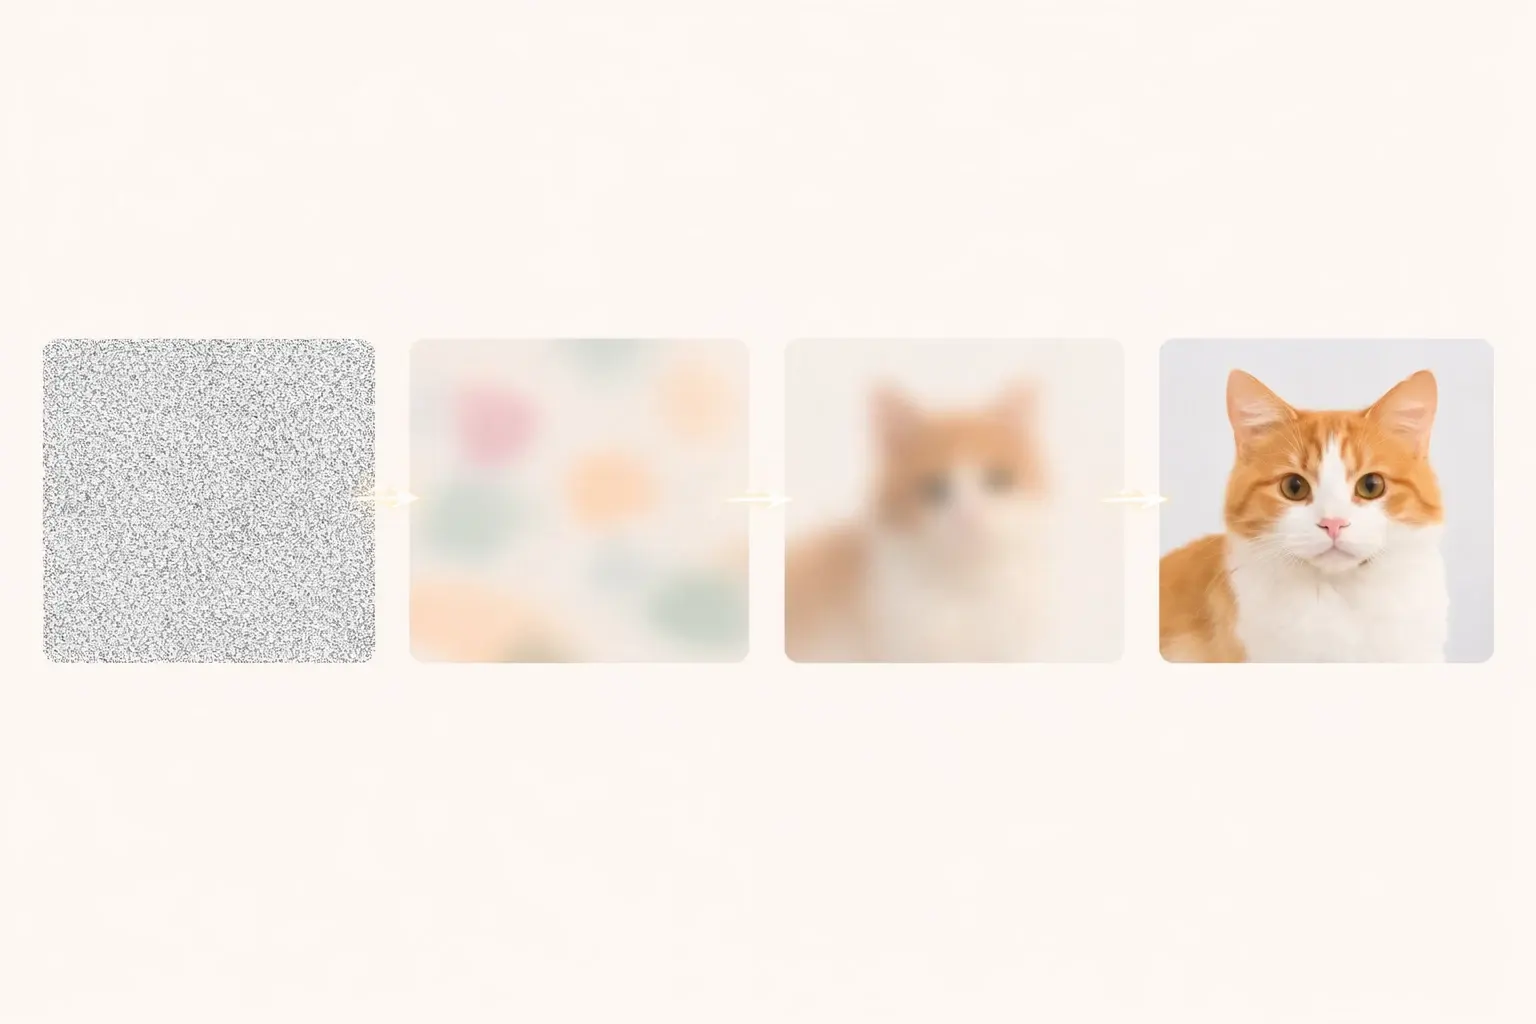
ここから2つのことが言えます。第1に、モデルはあなたの正確な画像を見たことがありません — 説明に合うものを再構築しているのです。第2に、プロンプトの仕事量はとても大きい。言葉が曖昧だと、モデルは学習データで最も多かったもので隙間を埋めます。だから雑なプロンプトはありがちなストックフォト風の画像になるのです。
テキストから画像 vs 画像からテキスト vs 画像編集
この3つは絶えず混同されます。実はまったく別の仕事です。
| タスク | 与えるもの | 戻ってくるもの | 例となるツール |
|---|---|---|---|
| テキストから画像 | 言葉 | 新しい画像 | Anyscene、Midjourney、Flux |
| 画像からテキスト(OCR) | 画像 | その中の文字 | Google Lens、Tesseract |
| 画像編集 | 画像+指示 | 同じ画像を変更したもの | Photoshop AI、Canva |
このガイドは1番目を扱います。スクリーンショットから文字をコピーしようとしてここに辿り着いた方は、このタブを閉じてOCRで検索してください。
4ステップでテキストから画像を生成する方法
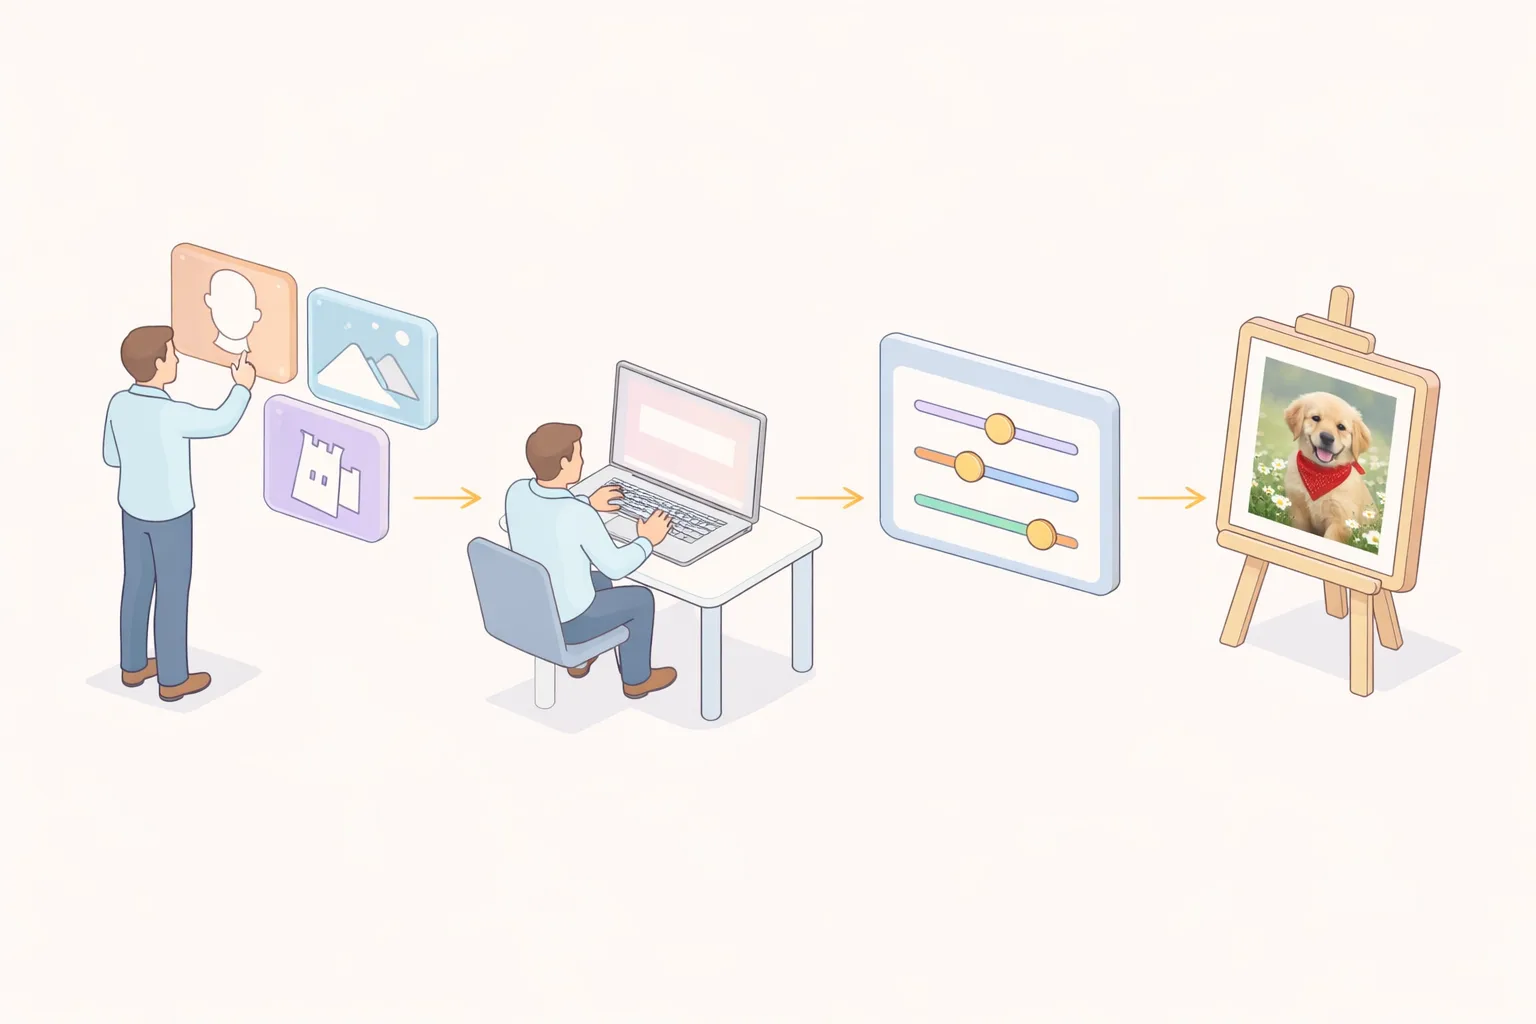
ステップ1 — タスクに合うモデルを選ぶ
すべてのモデルに個性があります。間違ったものを使うのは、スポーツカメラマンに結婚式を撮らせるようなものです。
- 写実性 → Flux 1.1 ProまたはMidjourney V7。どちらも肌、布、自然光をプラスチックに見せず扱えます。
- スタイル化アートやイラスト → Midjourney V7またはSDXL。デフォルトでより良い色構成を出します。
- 画像内の文字(ポスター、看板、ロゴ) → Flux ProまたはDALL·E 3。古いモデルは言葉を意味不明な文字列に変えます。
- 品質より速度 → Flux Schnell。1枚2秒未満、高速反復に有用。
まだ分からないなら、ひとつ選んで午後いっぱいコミットしましょう。10分ごとにツールを行ったり来たりしても何も身につきません。
ステップ2 — 4つのパートからなるプロンプトを書く
良いプロンプトは4つの問いに答えます。どれかが欠けるとモデルは推測し、その推測はだいたい平凡です。
| パート | 問い | 例 |
|---|---|---|
| 被写体 | 画像に何があるか? | a border collie catching a frisbee |
| 設定 | どこ、いつ? | on a windy beach, late afternoon light |
| スタイル | どんな見た目? | shot on Fujifilm X-T5, 35mm, shallow depth of field |
| 品質 | どれくらい磨き込まれているか? | sharp focus, natural colors, no filter |
つなげるとこうなります:
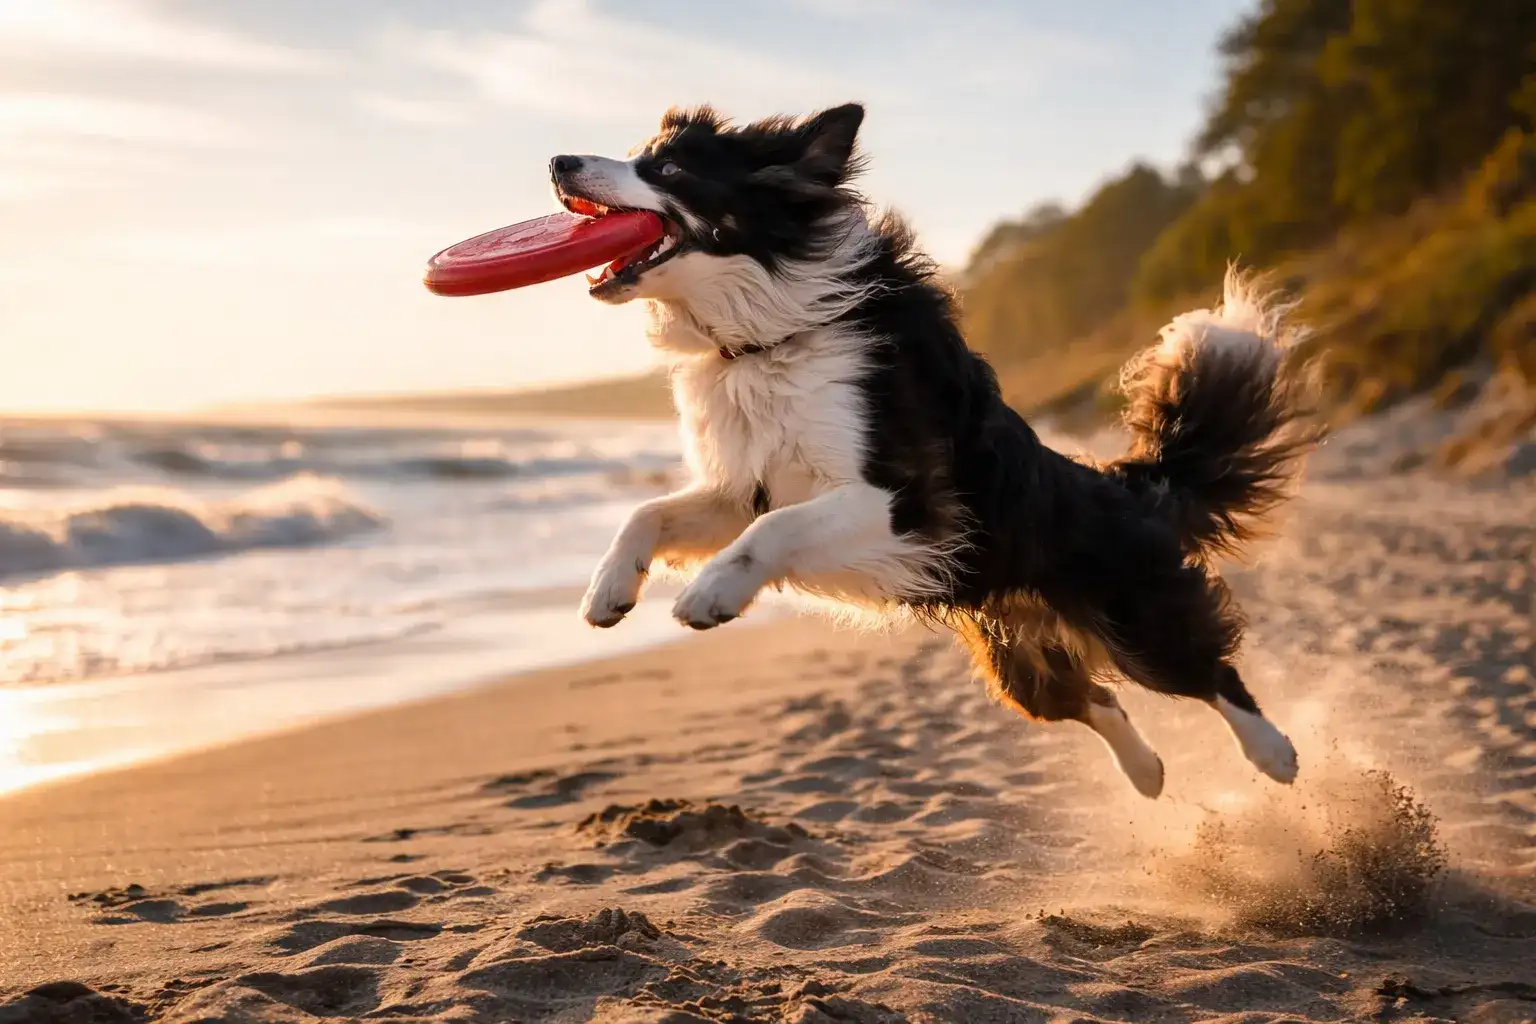
a border collie catching a frisbee on a windy beach, late afternoon light,
shot on Fujifilm X-T5, 35mm, shallow depth of field, sharp focus, natural colors
これだけです。魔法の言葉も、秘密のパラメータもありません。このプロンプトから得られた画像はこちら:
ステップ3 — 3つのパラメータを調整する(他は無視)
ほとんどのプラットフォームは15個のスライダーをぶつけてきます。必要なのは3つだけ。
- Seed — 同じシードと同じプロンプトは同じ画像を生みます。気に入ったものを保持しておけば、その周りで反復できます。
- Steps — 多いほどディテールが増え、待ち時間も伸びます。30がスイートスポット。50を超えると効果は逓減します。
- CFG / Guidance — モデルがプロンプトにどれだけ密着するか。デフォルトは7。精度なら10へ、創造的解釈なら4へ。
それ以外 — サンプラー、スケジューラー、CLIP skip — は、より良いプロンプトより重要ではありません。
ステップ4 — やり直さず、反復する
最初の画像は決まりません。2枚目もたいてい決まりません。
一度に1つだけ変えましょう。シーン全体ではなく、レンズだけ。被写体ではなく、時間帯だけ。どの言葉が画像を動かしたか追跡する — それがこのスキルの本質で、50回ほど生成して初めて身につきます。
20回目もまだおかしいなら、問題はプロンプトではなくモデルかもしれません。ステップ1へ戻りましょう。
2026年に試す価値のあるツール
料金と機能は数か月ごとに変わります。本稿執筆時点で、各ツールが勝つ場面はこちら。
| ツール | 得意分野 | 速度 | 価格 | 強み |
|---|---|---|---|---|
| Anyscene | シーンベース生成、マーケター向け | 約8秒 | 無料+有料ティア | シーンプリセット、ワンクリックでバリエーション |
| Midjourney V7 | そのままで美しい仕上がり | 約15秒 | $10/月から | 後処理不要 |
| Flux 1.1 Pro | リアリズム、読める文字 | 約10秒 | 画像ごとの従量制 | 手、顔、タイポグラフィ |
| Stable Diffusion 3.5 | オープンソース、ローカル利用 | GPUに依存 | 無料 | フル制御、検閲なし |
| DALL·E 3 | 会話ベースの編集 | 約20秒 | ChatGPT Plus経由 | マルチターンの調整 |
率直な見立て:今日結果がほしいならAnysceneかMidjourneyから。画像上の文字や商用品質のリアリズムが必要になったらFluxへ。GPUと週末を持てる人だけStable Diffusionを触ってください。
画像を本当に動かすプロンプトエンジニアリング
ほとんどの「プロンプトガイド」は、同じ5つのアイデアを12段落引き伸ばしただけです。短い版をどうぞ。
4パートの公式、繰り返し使う
被写体・設定・スタイル・品質。すべてのプロンプトでこれを使いましょう。覚えたら、プロンプトガイドを読むのはやめて構いません。
コピペで使える10個のプロンプトテンプレート
これらのどれかを貼り付け、名詞を入れ替えれば、動くプロンプトのできあがり。
1. Product photography: matte-white ceramic {product} on a peach-to-coral
   gradient background, studio softbox lighting, soft shadow, centered, 1:1.

2. Isometric SaaS illustration: a cloud dashboard with floating charts,
   pastel palette, clean lines, marketing style, 16:9.

3. Anime portrait: young woman with short black hair, cherry blossoms
   drifting, cel shading, pastel colors, 2:3.

4. Architectural concept: modernist house with glass walls, cantilevered
   over a pine forest at dusk, warm interior glow, cinematic, 16:9.

5. Botanical watercolor: eucalyptus sprig, loose brushstrokes, soft greens,
   paper texture, white background, 1:1.

6. Low-poly 3D scene: tiny mountain village with pine trees and a river,
   mint and sky-blue palette, soft ambient occlusion, 16:9.

7. Pixel art: cozy wizard's study, bookshelves, crystal ball, black cat,
   warm candlelight, 16-bit style, 1:1.

8. Minimalist line drawing: hand holding a coffee cup, thin black line
   on off-white paper, centered, 1:1.

9. Cyberpunk cityscape: neon pink and teal signage, wet streets, light
   rain, lone silhouette, anamorphic lens, 16:9.

10. Studio food photography: overhead shot of ramen with soft-boiled egg,
    scallions, nori, dark slate background, side lighting, 1:1.
どれも被写体・設定・スタイル・品質に沿っています。そのレンズで読み直してみてください。
ネガティブプロンプト
モデルが対応しているなら、ネガティブプロンプトはリトライを半減させます。ネガティブフィールドにこれを貼って、先に進みましょう:
blurry, extra fingers, deformed hands, text artifacts, watermark,
low contrast, oversaturated, distorted face
ネガティブプロンプトを公開していないモデル(DALL·E 3)は無視します。対応しているもの(Flux、SD、Midjourneyの--no)は喜んでくれます。
画像が崩れたときの修正表
これがほとんどのガイドが省略する部分です。出力が間違っているときに必要なのは理論ではなく、引き表です。
| 問題 | 原因 | 対処 |
|---|---|---|
| 6本指、溶けた手 | 手足に対する学習不足 | anatomically correct hands, five fingers を追加、ネガティブに deformed hands, extra fingers を |
| 看板の崩れた文字 | トークナイザーが綴れない | Flux ProまたはDALL·E 3に切り替え。文字は4語以内に。引用符で囲む |
| 顔がどこかおかしい | アスペクト比が広すぎる | ポートレートは16:9ではなく2:3か3:4を |
| 色が抜けて見える | CFGが低すぎる | ガイダンスを8〜10に上げる |
| どの顔も同じに見える | デフォルトチェックポイントの偏り | 民族、年齢、特徴を具体的に追加 |
| ライティングが変、または平板 | プロンプトに光の方向がない | rim light、golden hour、studio softbox を追加 |
| 被写体が小さく、シーンに埋もれる | フレーミングの言葉がない | close-up、medium shot、wide angle を追加 |
| いかにもAI生成に見える | 過度に滑らかな肌、左右対称の顔 | film grain, natural imperfections, asymmetric features を追加 |
この表をラミネートしましょう。何度も戻ってくることになります。
実際に使われている用途
アート展ではありません。地味で、退屈で、役に立つこと。
ブログや記事のビジュアル。 私たちが最もよく見る単一用途はストックフォトの置き換えです。プロンプトひとつ、ライセンスの煩雑さなし、トピックにぴったり一致。このガイドも3枚使っています。
プロダクトモックアップ。 デザイナーが手を入れる前にパッケージデザインを確認。午後のうちに5つのボトル形状をテスト。高額なレンダリングの前におかしいものを切る。
SNSコンテンツ。 10時間ではなく1日で投稿のバリエーションを10本。同じプロンプト、異なるシード、ベスト2を選ぶ。
ストーリーボードとコンセプトワーク。 予算を投じる前にアイデアをビジュアルでテスト。広告、新商品ローンチ、上に通すあらゆるピッチに向いています。
リスティングとカタログ。 同じ商品ショットに対して背景バリエーションを生成。写真1枚で5キャンペーンを回す場面に有用。
これらの画像に自分自身を入れたいですか?AI画像ジェネレーターに自分を取り込む方法 →
法律周りの話を30秒で
短い版:ツールのライセンスが許せば、商用利用はおおむね問題ありません。Anyscene、Midjourneyの有料ティア、Flux Pro、DALL·E 3はすべて商用出力を許可しています。
それでも2つは引っかかる可能性があります。存命のアーティストのスタイル名を入れたプロンプト(in the style of [名前])はよくてグレーゾーン、悪ければ訴訟対象です。商標キャラクター(ミッキーマウス、ポケモン、ブランドロゴ)を再現した出力は、ツールではなくあなたの責任です。
一部の地域では、広告や編集コンテンツへのAI使用開示が義務付けられています。公開前にお住まいの地域のルールをご確認ください。
よくあるご質問
AIテキストから画像は無料? はい、ほとんどのプラットフォーム(Anysceneを含む)で1日の生成数に制限付きで無料です。有料ティアでは速度、高解像度、商用ライセンスが手に入ります。
初心者に最適なAI画像ジェネレーターは? AnysceneまたはMidjourney。どちらも普通の言葉で動きます。初日にパラメータを覚える必要はありません。
AI生成画像を商用利用できる? ほとんどの有料ティアで可能です。具体的なプランのライセンスページをご確認ください。無料ティアの画像には利用制限が付くことがあります。
GPUは必要? Stable Diffusionをローカルで動かすときだけ。ウェブツールはあなたの代わりに計算してくれます。
1枚の生成時間は? Flux Schnellのような高速モデルでは2秒。高品質モデルでは最大30秒。
画像がいつも同じに見えるのはなぜ? シードが同じ、または短いプロンプトが同じ、のどちらかです。どちらかを変えてください。
画像上に読める文字をAIに描かせられる? Flux ProとDALL·E 3なら可能。文字は4語以内に。古いモデルはそれ以上になると崩します。
これはデザイナーを置き換える? ストックフォトやコンセプトスケッチの用途では、ほぼそうです。ブランドアイデンティティや本番アートワークでは、いいえ — 誰かが「何が良いか」を判断し続ける必要があります。
最初の1行を打ってください。それだけが本当に大事なステップです。
次の読み物:Kling 2.6が動画生成をどう変えたか →