 Anyscene AI
Text zu Bild mit KI
Schreib auf, was du sehen willst, und erhalte es als Bild zurück. Alle Text-zu-Bild-Modelle teilen sich ein Eingabefeld, und der Preis steht auf dem Button, bevor du klickst.
Beispiel ausprobieren
Ein Prompt, sechs Stile
Ein Text-zu-Bild-Prompt in sechs Stilen
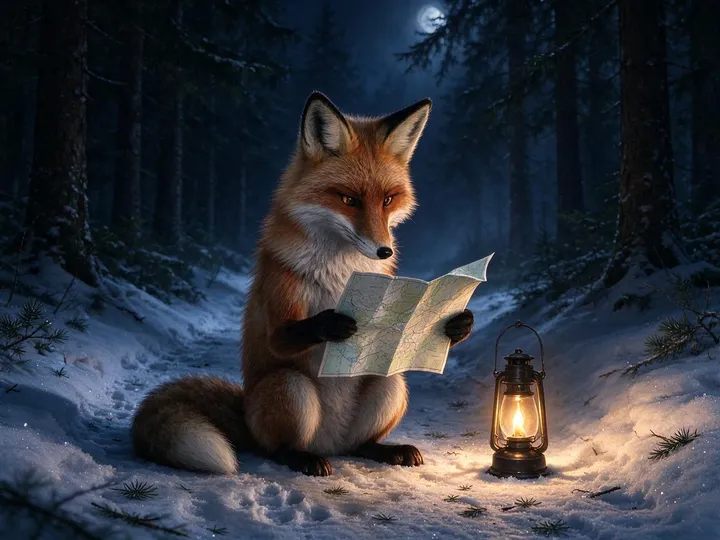
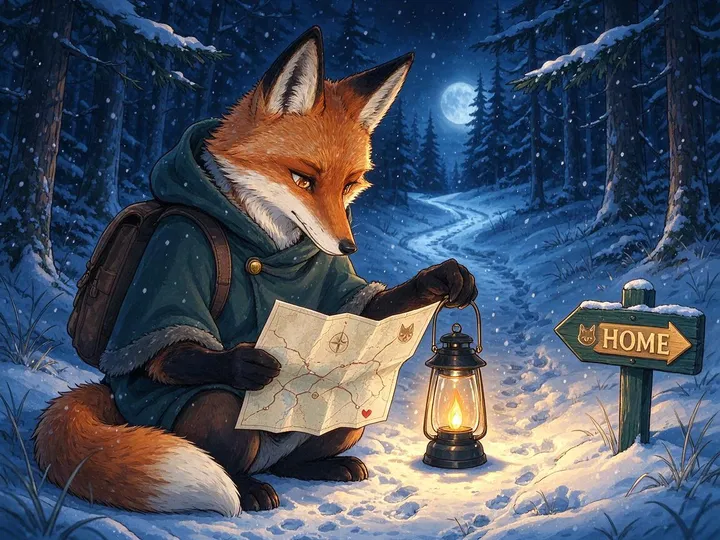
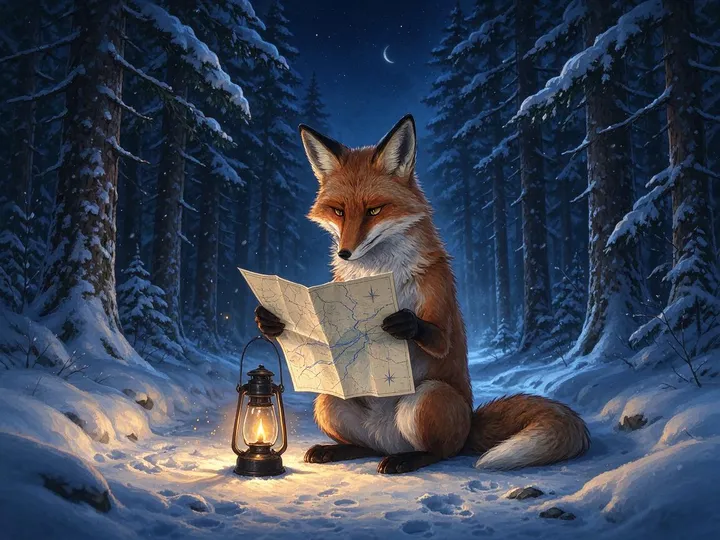
Das Stilmenü des Generators hängt eine Wendung an das Ende deines Prompts. Wir haben denselben Fuchs-Prompt mit Seedream 5.0 Flash, dem Standardmodell für Text zu Bild auf dieser Seite, durch alle sechs Stile geschickt, um zu sehen, wie weit diese eine Wendung das Bild verändert.
Der Prompt, wie er gesendet wurde
A red fox sitting on a snowy forest path at night, reading a paper map by the light of a small lantern, [style] style
- Motiv
- Ort
- Licht
- Stil
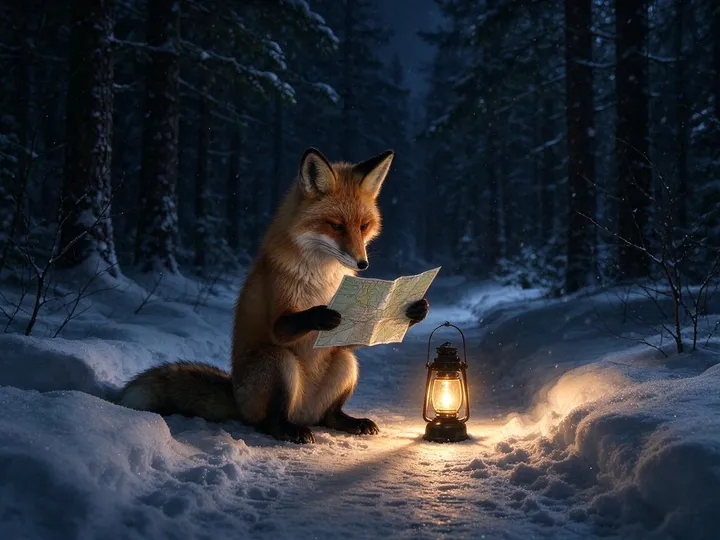
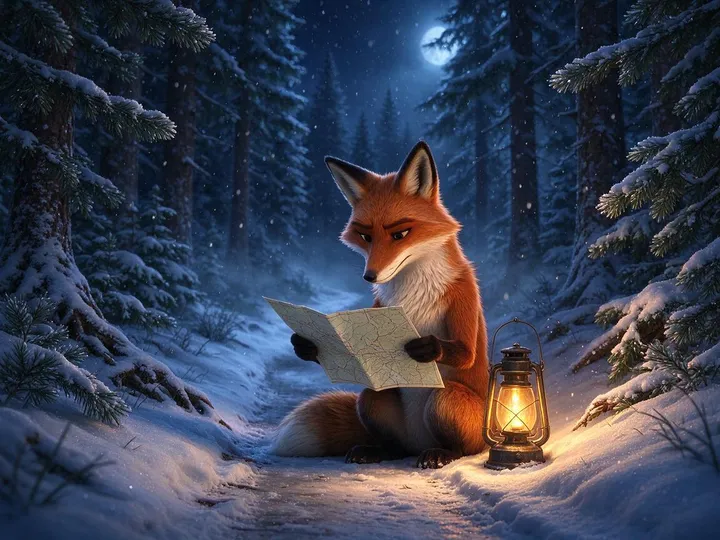
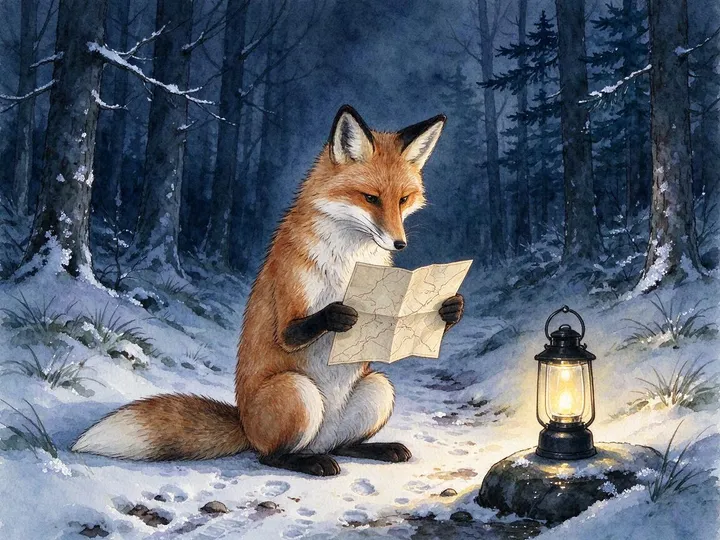
Was sich änderte und was nicht
- Anime hat das Bild am stärksten verändert. Der Fuchs bekam einen Kapuzenmantel, einen Rucksack und einen Wegweiser mit der Aufschrift HOME – nichts davon stand im Prompt.
- Aquarell machte die Kanten weicher und den Schnee heller, ließ den Bildaufbau aber gleich.
- Digitale Kunst, Filmisch und 3D-Modell sahen Fotorealistisch sehr ähnlich. Bei diesem Modell ist ein Stilwort ein Anstoß, keine Anweisung.
- Wenn ein Stil nicht greift, beschreib das Material: „ein 3D-Render mit weichen Tonmaterialien und Studiolicht“ sagt viel mehr als „3D-Modell-Stil“.
Sechs Text-zu-Bild-Durchläufe am 23. Oktober 2026, einer pro Stil, nichts neu generiert oder retuschiert. Jeder dauerte 14 bis 25 Sekunden.
Kurz gesagt
Was ist Text zu Bild mit KI?
KI für Text zu Bild ist der Teil der generativen KI, der zeichnet: Du beschreibst ein Bild in Worten, und ein Modell erstellt es.
Text zu Bild mit KI ist Software, die eine schriftliche Beschreibung, den Prompt, in ein neues Bild verwandelt. Ein Modell, das mit Millionen beschrifteter Bilder trainiert wurde, liest den Prompt und erzeugt Pixel, die dazu passen: ein Foto, eine Illustration oder ein Poster mit Schrift, im Format deiner Wahl.
Dein Prompt
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out, shot from a low angle with a wide 24mm lens, long exposure that smooths the water, cinematic colors
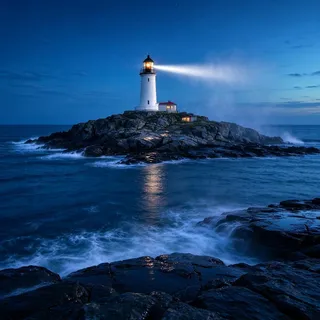
Eine vereinfachte Skizze, wie Diffusion funktioniert, keine Zwischenbilder eines echten Durchlaufs. Das Bild ist unser Leuchtturm aus Schritt 4 weiter unten.
Modelle, die Rauschen entfernen
Die meisten Text-zu-Bild-Modelle, darunter Flux, Seedream und Qwen Image, sind Diffusions- oder Flow-Modelle: Sie beginnen mit Rauschen und verfeinern es schrittweise, gesteuert von deinem Prompt. Neuere stellen ein Sprachmodell davor, das den Prompt mit mehr Weltwissen liest.
"The model couples the Mistral-3 24B parameter vision-language model with a rectified flow transformer."
Black Forest Labs, Ankündigung von FLUX.2Modelle, die in einem Chatbot stecken
Die GPT-Image-Reihe von OpenAI entstand aus der Bildgenerierung, die in GPT-4o eingebaut ist, das Modell hinter ChatGPT, statt aus einem separaten Bildmodell. Laut OpenAI folgt sie detaillierten Anweisungen und setzt Text zuverlässig in Bilder.
"…because it is embedded natively, deep in the architecture of our omnimodal GPT‑4o model, 4o image generation can use everything it knows…"
OpenAI, System Card zur 4o-BildgenerierungLieber die lange Version, mit Lösungen für seltsame Hände und verstümmelte Schrift? Unseren Text-zu-Bild-Leitfaden lesen →
Vier Schritte, ein Prompt
So wird ein Text-zu-Bild-Prompt konkreter
Ein kurzer Prompt überlässt jede Entscheidung dem Modell. Jeder Schritt unten fügt demselben Leuchtturm-Prompt eine Art von Detail hinzu. Die neuen Wörter sind markiert, die früheren ausgegraut.
 1 / 4
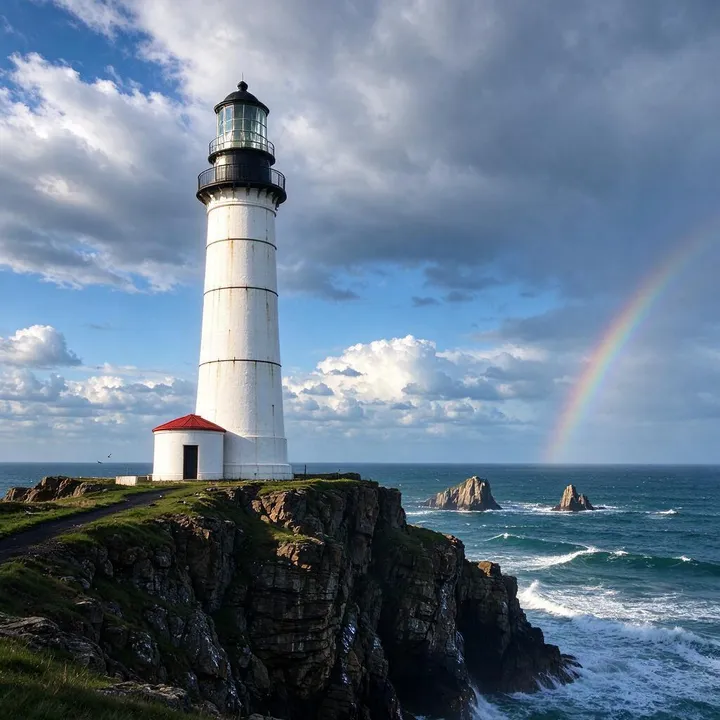
1. Nur das Motiv
A lighthouse
Zwei Wörter ergaben eine sonnige Klippe mit Regenbogen. Alles andere hat das Modell mit dem gewöhnlichsten Bild eines Leuchtturms gefüllt.
 2 / 4
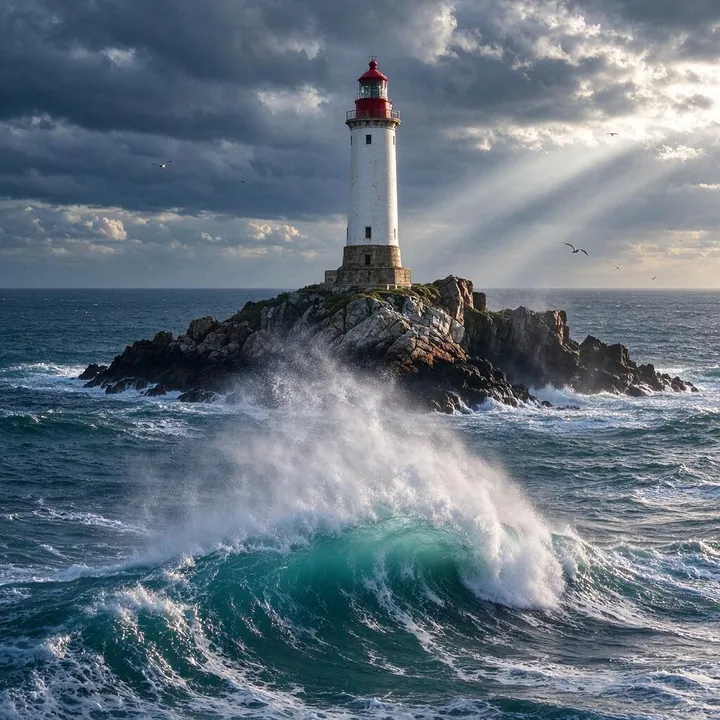
2. Den Ort ergänzen
A lighthouse on a rocky island, waves breaking against the rocks below
Der Name des Ortes setzte den Leuchtturm auf einen Felsen im offenen Meer und brachte die brechende Welle dazu.
 3 / 4
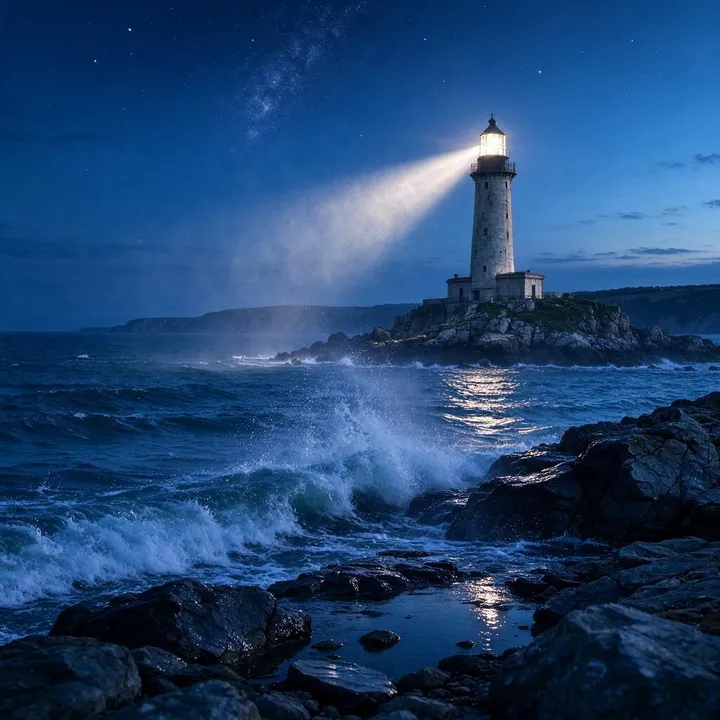
3. Licht und Tageszeit ergänzen
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out
Blaue Stunde, Nebel und Sterne veränderten die ganze Stimmung. In unserem Durchlauf hat dieser Schritt das Bild am stärksten verändert.
 4 / 4
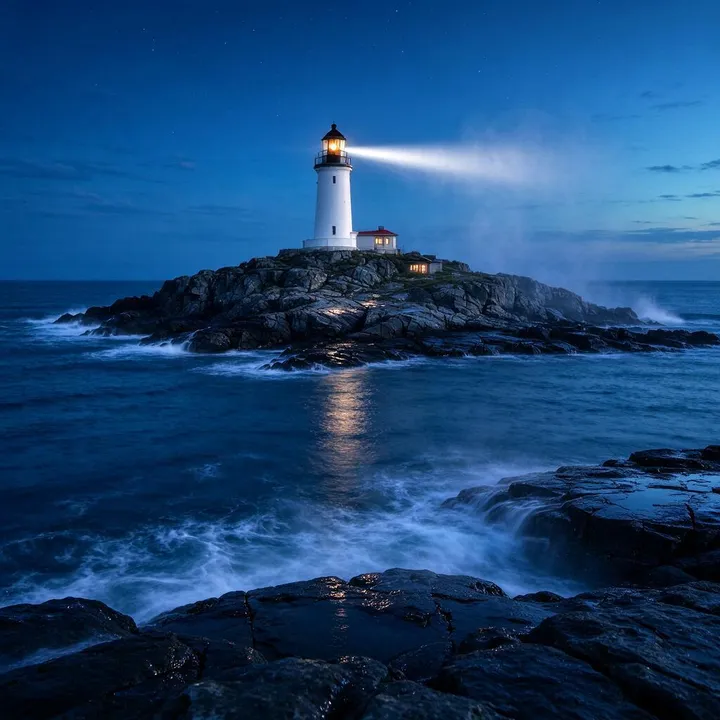
4. Die Kamera ergänzen
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out, shot from a low angle with a wide 24mm lens, long exposure that smooths the water, cinematic colors
Die Langzeitbelichtung glättete das Wasser, doch der niedrige 24-mm-Blickwinkel ist kaum zu sehen. Kamerawörter befolgte dieses Modell am wenigsten.
Seedream 5.0 Flash im Format 1:1, ein Text-zu-Bild-Durchlauf pro Schritt am 23. Oktober 2026, jeweils 14 bis 19 Sekunden.
Prompt-Baukasten
Einen Text-zu-Bild-Prompt bauen
Du weißt nicht, was du schreiben sollst? Dieser Text-zu-Bild-Prompt-Generator braucht nur ein Motiv und eine Wendung aus jeder Gruppe, dann baut sich der Prompt von selbst. Schick ihn an den Generator oben auf der Seite oder kopiere ihn.
Dein Prompt
Eine Kaffeetasse aus Keramik, auf einem Holztisch am Fenster, weiches Morgenlicht
- Motiv
- Ort
- Licht
- Kamera
- Stil
- Schrift
- Setz das Motiv an den Anfang, damit nichts davor für die Hauptsache gehalten wird.
- Ein Ort, ein Licht, ein Stil: Zwei Stile ziehen in verschiedene Richtungen.
- Nenn, was man sehen würde, nicht, wie es wirken soll. „Nebel und eine tief stehende Sonne“ funktioniert besser als „stimmungsvoll“.
- Wörter, die ins Bild sollen, gehören in Anführungszeichen, und je weniger, desto besser.
Schrift im Bild
So schreibt eine KI den Text im Bild richtig
Schilder, Etiketten und Plakattitel waren lange die Schwachstelle von Text-zu-Bild-KI. Aktuelle Modelle schreiben kurzen Text richtig, wenn der Prompt dafür geschrieben ist, wie die vier Ergebnisse unten zeigen.
01
Den genauen Wortlaut in Anführungszeichen
Anführungszeichen sagen einem Text-zu-Bild-Modell, dass das Buchstaben zum Zeichnen sind, keine Ideen zum Darstellen: ein Schild mit der Aufschrift „Books & Tea“, nicht ein Schild über Bücher und Tee.
02
Sagen, wo der Text hinkommt
Auf ein handgemaltes Schild, auf das Etikett, oben aufs Plakat. Text ohne festen Platz schwebt am Ende irgendwo oder landet an der falschen Stelle.
03
Die Schrift beschreiben
Handgeschrieben, fette Buchstaben, eine elegante Serifenschrift. Ein benannter Stil gibt dem Modell eine Vorlage und hält die Buchstaben gleichmäßig.
04
Kurz halten, jedes Wort prüfen
Jede Zeile in Anführungszeichen unten hat höchstens sechs Wörter. Modelle fügen auch Wörter hinzu, die niemand wollte: Seedream 5.0 Pro gab unserer Kaffee-Infografik einen Untertitel und Bildunterschriften.
 1
 2
 3
 4
1Nano Banana Pro16:9
A cozy bookshop storefront on a cobblestone street at dusk, a hand-painted sign reading "The Paper Lantern — Books & Tea", warm light spilling from the windows, a bicycle leaning against the wall
2GPT Image 2.52:3
A vintage travel poster for Kyoto: a five-storey pagoda among cherry blossoms at sunset, the title "KYOTO" in bold letters at the top and "Cherry Blossom Season" at the bottom, flat screen-print style
3Nano Banana Pro4:5
A kraft-paper coffee bag on a café counter, the label printed with "MORNING RITUAL — Single Origin, Ethiopia" in an elegant serif, soft morning light, shallow depth of field
4Qwen Image 3.03:4
A chalkboard café menu titled "Morning Menu" listing Espresso 3.00, Latte 4.50 and Croissant 3.50, hand-lettered, warm café light
Ergebnisse von unseren Modellseiten, je ein Durchlauf. Jedes Wort in Anführungszeichen kam wie geschrieben heraus, aber prüf die Schreibweise deiner eigenen Wörter vor dem Veröffentlichen.
Jedes Modell mit Preis
Welches Text-zu-Bild-Modell du wählen solltest
Alle 17 Modelle nehmen denselben Prompt. Sie unterscheiden sich darin, was sie am besten können, was sie kosten und wie groß das Bild ist, das sie liefern. Credits, Größen und Tarife unten stammen aus derselben Preisliste, die der Generieren-Button nutzt.
Wisch die Tabelle seitwärts, um alle Spalten zu sehen.
| Modell | Am besten für | Credits pro Bild | Größte Auflösung | Verfügbar für |
|---|---|---|---|---|
| Basic | Schnelle Entwürfe, um eine Idee zu testen | 2 Credits | 1K | Alle Konten |
| Z-Image | Günstige Bilder nur aus Text | 2 Credits | 1K | Alle Konten |
| Seedream 5.0 Flash | Alltagsbilder zum kleinen Preis; das Standardmodell für Text zu Bild auf dieser Seite | 5 Credits | 2K | Alle Konten |
| GPT Image 1.5 | Folgt langen, detaillierten Prompts genau | 6 Credits | 1K | Jeder Tarif oder jedes Credit-Pack |
| Nano Banana | Schlichte Szenen und Bearbeitungen, bei denen das Motiv gleich bleibt | 6 Credits | 1K | Jeder Tarif oder jedes Credit-Pack |
| Nano Banana 2 Lite | Einfache Szenen und Food-Fotos zum niedrigsten Nano-Banana-Preis | 6 Credits | 1K | Alle Konten |
| Wan 2.7 Image | Alltagstaugliche Qualität zum kleinen Preis, mit einer Pro-Stufe für mehr Details | 6–20 Credits | 4K | Jeder Tarif oder jedes Credit-Pack |
| Flux 2 | Fotografische Details (Pro) und feinste Typografie (Flex) | 8–36 Credits | 2K | Jeder Tarif oder jedes Credit-Pack |
| GPT Image 2 | Sauberer Text, Layouts und UI-Mock-ups | 8–22 Credits | 4K | Jeder Tarif oder jedes Credit-Pack |
| Nano Banana 2 | Schärfere Details als das erste Nano Banana | 8–22 Credits | 4K | Jeder Tarif oder jedes Credit-Pack |
| Qwen Image 3.0 | Speisekarten, Schilder und Plakate mit Text, zum mittleren Preis | 8 Credits | 2K | Jeder Tarif oder jedes Credit-Pack |
| GPT Image 2.5 | Plakate und App-Screens mit exaktem Wortlaut | 10–26 Credits | 4K | Jeder Tarif oder jedes Credit-Pack |
| Seedream 5 Lite | Große, detailreiche Bilder bis 3K | 10–14 Credits | 3K | Jeder Tarif oder jedes Credit-Pack |
| Seedream 5.0 Pro | Porträts mit natürlicher Haut und Infografiken | 11–22 Credits | 2K | Jeder Tarif oder jedes Credit-Pack |
| Nano Banana Pro | Die schwierigsten Prompts und kleiner, exakter Text | 29–38 Credits | 4K | Jeder Tarif oder jedes Credit-Pack |
Insgesamt 17 Text-zu-Bild-Modelle. Eines noch nicht ausprobiert? Die Beispiele auf seiner Seite zeigen, wie seine eigenen Ergebnisse aussehen.
Text in 3 Schritten in ein Bild verwandeln
Vom ersten Wort bis zum heruntergeladenen Bild braucht Text zu Bild drei Schritte und mit dem Standardmodell weniger als eine halbe Minute Wartezeit.
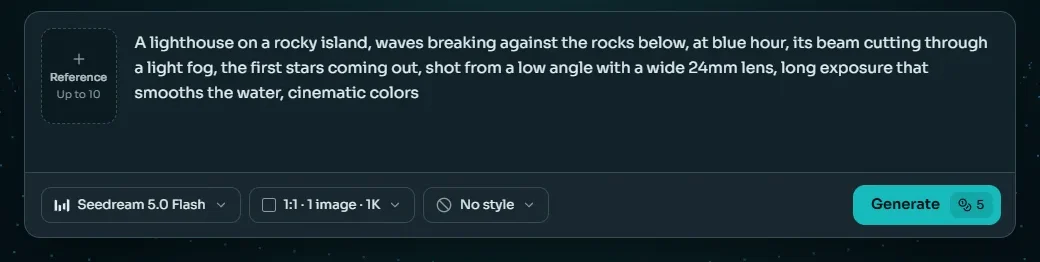
Schritt 1: Prompt schreiben
Schreib in das Text-zu-Bild-Eingabefeld oben auf der Seite, was das Bild zeigen soll: zuerst das Motiv, dann Ort, Licht und einen Stil. Keine Idee? Fang mit dem Prompt-Baukasten oder einem der Beispiele unter dem Feld an.
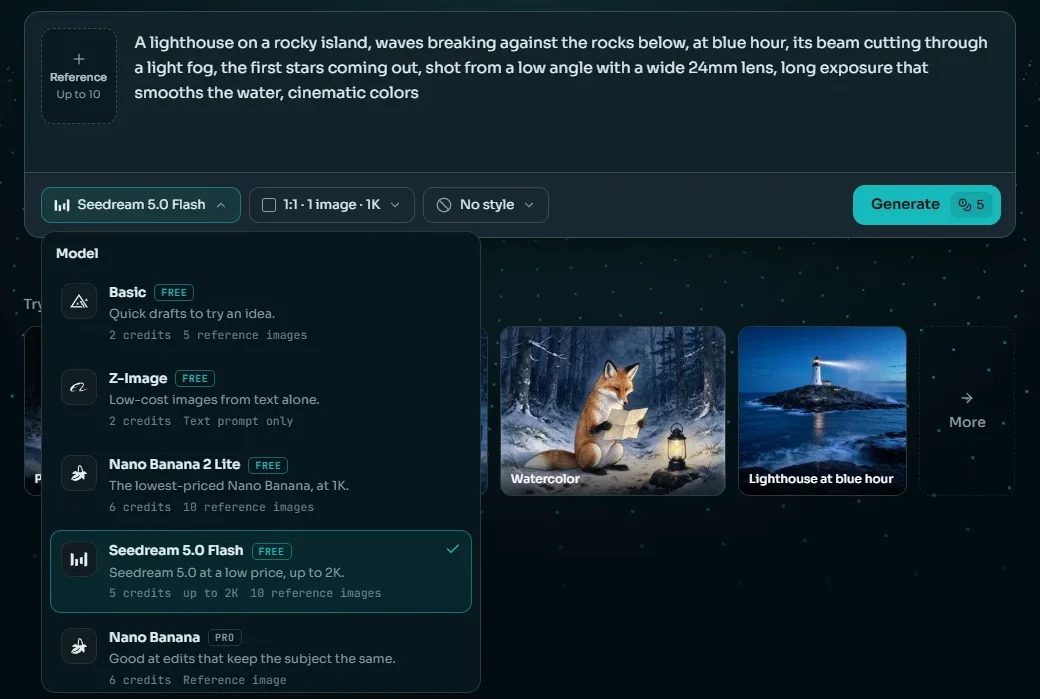
Schritt 2: Modell, Format und Stil wählen
Seedream 5.0 Flash ist vorausgewählt. Wechsle das Modell über den ersten Button, wähl ein Format wie 16:9 für ein Banner oder 9:16 für eine Story und füg bei Bedarf einen Stil hinzu. Der Preis auf dem Generieren-Button passt sich dabei an.
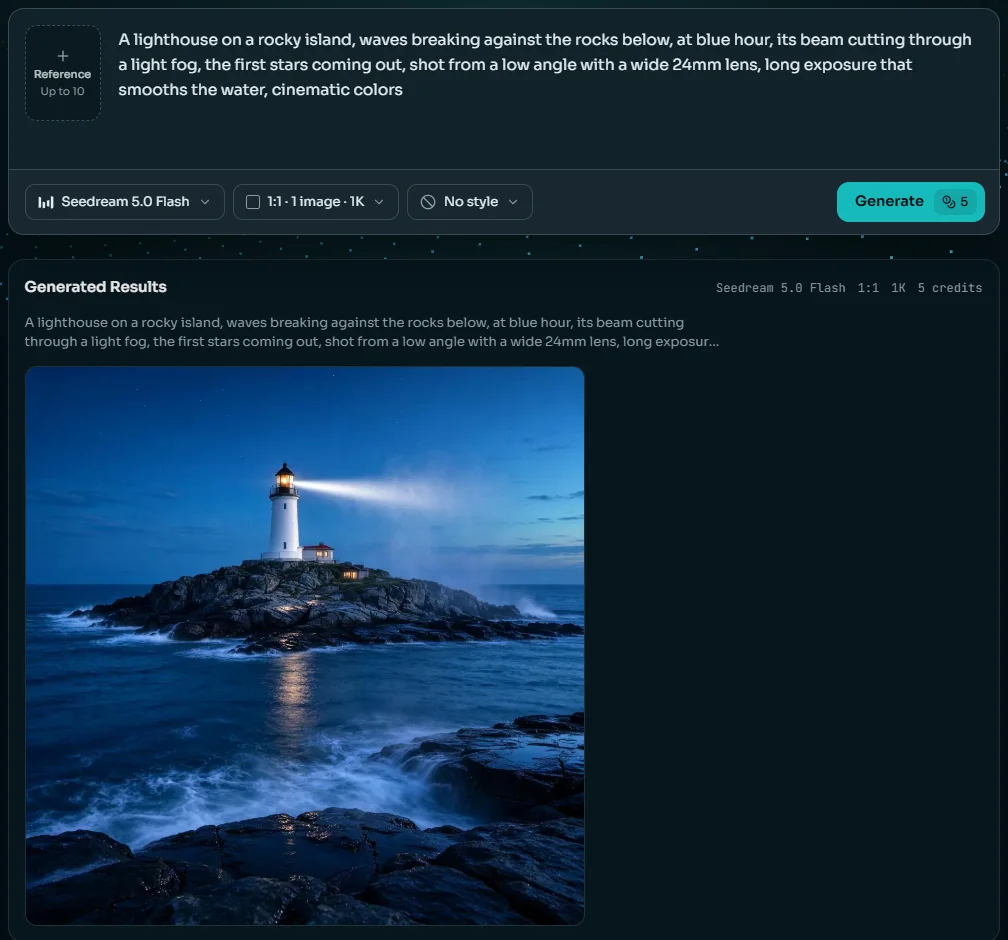
Schritt 3: Generieren, vergleichen, verfeinern
Klick auf Generieren. Das Bild erscheint unter dem Feld, zusammen mit dem Prompt, der es erzeugt hat. Ändere einen Teil des Prompts und generier neu, probier ein anderes Modell mit denselben Worten oder gib das Ergebnis an den Editor, den Vergrößerer oder ein Video weiter.
Was andere erstellen
Was Leute mit Text-zu-Bild-KI erstellen
Sechs echte Text-zu-Bild-Ergebnisse von unseren Modellseiten, jeweils mit dem Tool, das meist als Nächstes kommt.

Produktfotos
Ein sauberes Studiobild für Shop, Anzeige oder Moodboard, noch bevor das Produkt fotografiert ist.

Essen und Getränke
Speisekartenbilder, Rezept-Header und Kacheln für Liefer-Apps, in dem Licht und aus dem Winkel, den du beschreibst.

Plakate und Sprüche
Wenige Wörter auf einem klaren Layout für Social Posts und Drucke. Ein Wort änderst du später im Editor.

Räume und Stimmungen
Interieurs für Blogs, Inserate und Konzeptboards. Ein quadratisches Bild erweiterst du danach zum Banner.

Tierbilder und Stockfoto-Ersatz
Naturbilder für Artikel und Folien, ohne Stockfoto-Seiten zu durchsuchen. Vor dem Drucken vergrößern.

Standbilder, die sich danach bewegen
Ein Bild, das zum ersten Frame eines kurzen Videos für Reels oder TikTok wird.
Drei Wege zu einem Bild
Text zu Bild, Bild zu Bild oder KI-Bildbearbeitung?
Text zu Bild, Bild zu Bild und Bildbearbeitung laufen alle auf denselben Modellen. Womit du anfängst, entscheidet, was du brauchst.
| Text zu Bild | Bild zu Bild | KI-Bildbearbeitung | |
|---|---|---|---|
| Du beginnst mit | Nur Worten | Worten und einem oder mehreren Referenzbildern | Deinem Foto und einer Anweisung |
| Was gleich bleibt | Nichts: Jedes Bild ist neu | Motiv, Look oder Aufbau der Referenz | Alles, was du nicht ändern lässt |
| Am besten für | Neue Ideen, Plakate und Szenen von Grund auf | Ein neues Bild im Stil eines anderen oder mit dessen Motiv | Ein echtes Foto ändern: Hintergrund, Kleidung, Text oder Licht |
| Dieselbe Figur zweimal | Schwer: jedes Mal genau beschreiben | Leichter, dank der Referenz | Es ist die Person auf deinem Foto |
| Wo bei Anyscene | Diese Seite | Eine Referenz im selben Eingabefeld hinzufügen | Die Seite KI-Bildbearbeitung |
Leg ein Bild in den Referenzplatz, und aus dem Text-zu-Bild-Generator dieser Seite wird Bild zu Bild; der Generieren-Button zeigt den neuen Preis.
Ehrliche Grenzen
Wo Text zu Bild noch danebenliegt
Jedes Text-zu-Bild-Modell macht manches falsch. Das sind die sechs Fehler, die wir am häufigsten sehen, jeweils mit einer Lösung.
Langer Text
Ein ganzer Satz oder ein Absatz Kleingedrucktes kommt immer noch verstümmelt heraus. Halte jede Zeile in Anführungszeichen kurz oder füg den Text danach in einem Editor ein.
Genaue Anzahl
„Sieben Vögel“ können als fünf oder neun zurückkommen. Kleine Zahlen halten besser; bei mehr zählst du nach und generierst neu.
Gesichter in der Menge
Eine Person im Bild gelingt meist gut. Kleine Gesichter und Hände in einer Gruppe verformen sich am ehesten, also hol die Leute näher heran oder zeig weniger.
Dieselbe Figur zweimal
Worte allein halten ein Gesicht oder ein Maskottchen nicht von einem Bild zum nächsten. Füg das erste Bild als Referenz hinzu oder bearbeite es direkt.
KI-Bildbearbeitung →Links, rechts und dahinter
„Eine Katze links von einem Hund“ wird seltener befolgt, als man hofft. Sag, wo im Bild etwas steht, und verschieb es in einem Editor, wenn es falsch landet.
Echte Personen und Marken
Prompts, die echte Personen, Logos oder fremde Figuren nennen, können abgelehnt werden, und solche Bilder zu nutzen kann die Rechte anderer verletzen. Beschreib ein Aussehen, keinen Namen.
Ein Guthaben für jedes Text-zu-Bild-Modell
Ein Bild kostet je nach Modell und Größe 2 bis 38 Credits, mit dem Standardmodell 5. Tarife beginnen bei $15.9 im Monat bei jährlicher Zahlung, und Credit-Packs füllen jeden Tarif auf.
Starter
- 1.200 Credits pro Monat
- Bis zu 600 Bilder oder 30 Videos
Pro
Beliebt- 4.400 Credits pro Monat
- Bis zu 2.200 Bilder oder 110 Videos
Premium
- 8.400 Credits pro Monat
- Bis zu 4.200 Bilder oder 210 Videos
Jahrespreise, pro Monat angegeben. Monatliche Abrechnung und Credit-Packs findest du auf der Preisseite.
FAQ zu Text zu Bild mit KI
Text zu Bild mit KI verwandelt eine schriftliche Beschreibung in ein neues Bild. Du tippst einen Prompt, ein Modell, das mit beschrifteten Bildern trainiert wurde, erzeugt ein passendes Bild, und du kannst es herunterladen, bearbeiten oder in ein Video verwandeln.
Die meisten Modelle sind Diffusions- oder Flow-Modelle: Sie beginnen mit zufälligem Rauschen und entfernen es Schritt für Schritt, gesteuert von deinem Prompt. Einige neuere, etwa die GPT-Image-Reihe von OpenAI, sind in ein Sprachmodell eingebaut. Das hilft bei langen Anweisungen und bei Schrift im Bild.
Es gibt nicht das eine. Fang mit Seedream 5.0 Flash an, dem Standardmodell, für Alltagsbilder zu 5 Credits. Nimm Nano Banana Pro oder GPT Image 2.5, wenn Schrift ins Bild soll, Seedream 5.0 Pro für Porträts und Basic oder Z-Image zu 2 Credits, um eine Idee zu testen.
Von 2 Credits bei Basic und Z-Image bis 38 bei Nano Banana Pro in 4K; das Standardmodell kostet 5. Der Preis steht auf dem Generieren-Button, bevor du klickst, und ein fehlgeschlagenes Bild bekommt seine Credits zurück. Ein neues Konto startet mit 40 Credits für die vier Modelle, die kostenlosen Konten offenstehen: Basic, Z-Image, Seedream 5.0 Flash und Nano Banana 2 Lite.
Ja. Alles, was du auf Anyscene erstellst, darfst du kommerziell nutzen, auch in Anzeigen, Produktseiten und Social Posts. Fordere im Prompt keine echten Personen, Logos oder Figuren an, an denen du keine Rechte hast: Das Bild gibt dir diese Rechte nicht.
Setz den genauen Wortlaut in Anführungszeichen, sag, wo er hinkommt, beschreib die Schrift und halte jede Zeile kurz. Auf unseren Modellseiten haben Nano Banana Pro, GPT Image 2.5 und Qwen Image 3.0 jedes Wort in Anführungszeichen richtig geschrieben. Prüf jedes Wort in voller Größe, bevor du veröffentlichst.
Ja. Die meisten Modelle lesen Prompts auf Deutsch, Spanisch, Französisch, Portugiesisch, Chinesisch, Japanisch und Koreanisch ebenso wie auf Englisch. Versteht ein Modell einen Prompt falsch, probier denselben auf Englisch. Wörter, die im Bild stehen sollen, setzt du am besten in Anführungszeichen, genau so, wie sie erscheinen sollen.
Text zu Bild startet nur mit Worten, jedes Bild ist also neu. Bild zu Bild fügt ein Referenzbild hinzu, und das Ergebnis übernimmt dessen Motiv, Stil oder Aufbau. Füg im selben Eingabefeld eine Referenz hinzu, um zu wechseln.
Das hängt vom Modell ab: etwa 1K bei Basic und Z-Image, bis 2K bei Seedream 5.0 Flash und bis 4K bei Nano Banana 2, Nano Banana Pro, GPT Image 2, GPT Image 2.5 und Wan 2.7 Image Pro. Ergebnisse bleiben 30 Tage in deinem Verlauf, lade also die herunter, die du behalten willst.
Verwandte KI-Bildtools
Dieselben Credits, für das, was du als Nächstes mit einem Bild machen willst.
Dein nächstes Bild beginnt mit einem Satz
Melde dich an, schreib einen Prompt und wähle eins von 17 Text-zu-Bild-Modellen. Das Standardmodell erstellt ein Bild für 5 Credits, und fehlgeschlagene Bilder werden erstattet.