
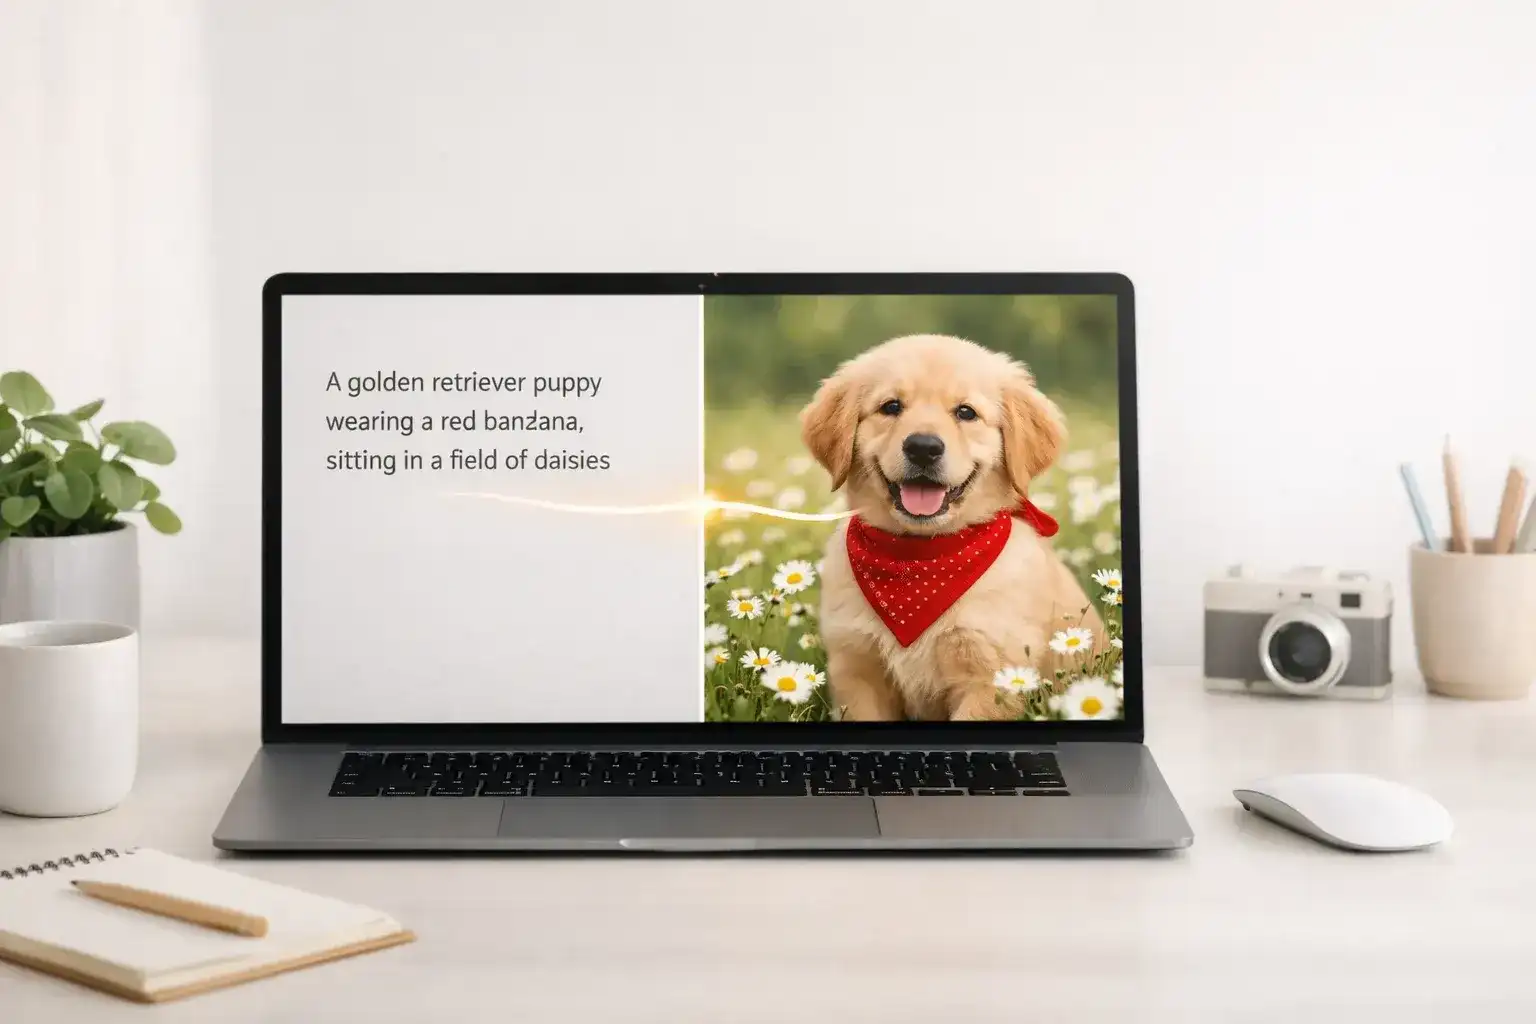
문장을 입력합니다. 1분 뒤, 그림이 생깁니다.
그게 2026년 텍스트-투-이미지 AI가 실제로 하는 일이며, 이 가이드는 모든 단계를 차근차근 안내합니다 — 모델 고르기, 죽처럼 뭉개지지 않는 프롬프트 작성하기, 손가락 여섯 개 고치기, 그리고 실제 사이트에 쓸 수 있는 이미지를 출력하기까지.
저희는 Anyscene을 운영하다 보니, 무엇이 통하는지 알아내기 전에 형편없는 이미지를 정말 많이 만들어 봤습니다. 아래 내용은 시작 첫날 누군가 저희에게 말해 줬으면 좋았을 모든 것입니다.
짧은 버전이 필요하면 계속 스크롤하세요. 긴 버전이 필요하면 북마크해 두세요.
텍스트-투-이미지 AI가 실제로 하는 일
대부분의 튜토리얼은 이 부분을 건너뜁니다. 그러지 마세요. 모델의 생김새를 알면 프롬프트 방식이 달라집니다.
확산 모델의 작동 원리, 쉬운 말로
사진 한 장을 가져옵니다. TV 화면의 노이즈처럼 보일 때까지 무작위 노이즈를 더합니다. 이제 신경망에 그것을 되돌리는 법을 가르칩니다 — 텍스트 프롬프트가 그 아래에 무엇이 있어야 하는지 알려주는 동안, 노이즈를 한 겹씩 벗겨내는 법을요.
학습 중에 이것을 수억 번 하면 Midjourney, Flux, 또는 Stable Diffusion이 됩니다. 그게 전부입니다.
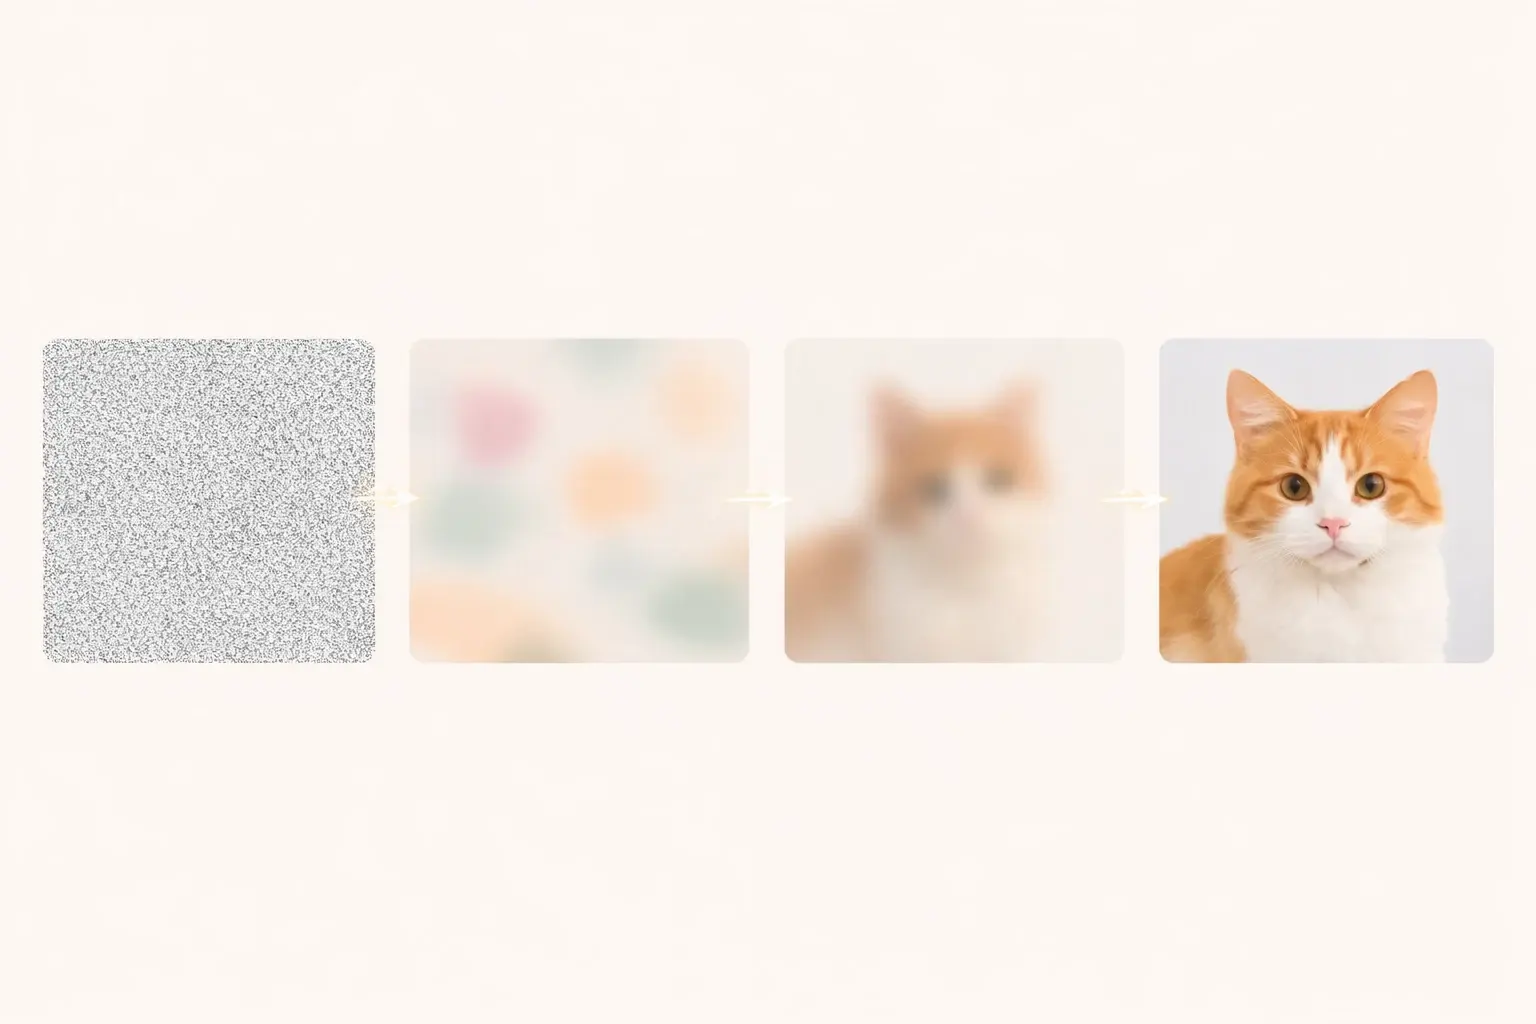
여기서 두 가지가 따라옵니다. 첫째, 모델은 당신의 정확한 이미지를 한 번도 본 적이 없습니다 — 당신의 설명에 맞는 이미지를 재구성하는 것입니다. 둘째, 프롬프트가 많은 일을 합니다. 단어가 모호하면 모델은 학습 데이터에서 가장 흔했던 것으로 빈틈을 채웁니다. 그래서 게으른 프롬프트는 평범한 스톡 사진을 줍니다.
텍스트-투-이미지 vs 이미지-투-텍스트 vs 이미지 편집
사람들은 이 셋을 끊임없이 헷갈립니다. 셋은 서로 다른 일입니다.
| 작업 | 입력 | 출력 | 예시 도구 |
|---|---|---|---|
| 텍스트-투-이미지 | 단어 | 새 이미지 | Anyscene, Midjourney, Flux |
| 이미지-투-텍스트(OCR) | 이미지 | 그 안의 단어 | Google Lens, Tesseract |
| 이미지 편집 | 이미지 + 지시 | 변경된 같은 이미지 | Photoshop AI, Canva |
이 가이드는 첫 번째에 관한 것입니다. 스크린샷에서 텍스트를 복사하려고 여기 오셨다면, 이 탭을 닫고 OCR을 검색하세요.
텍스트에서 이미지를 생성하는 네 단계
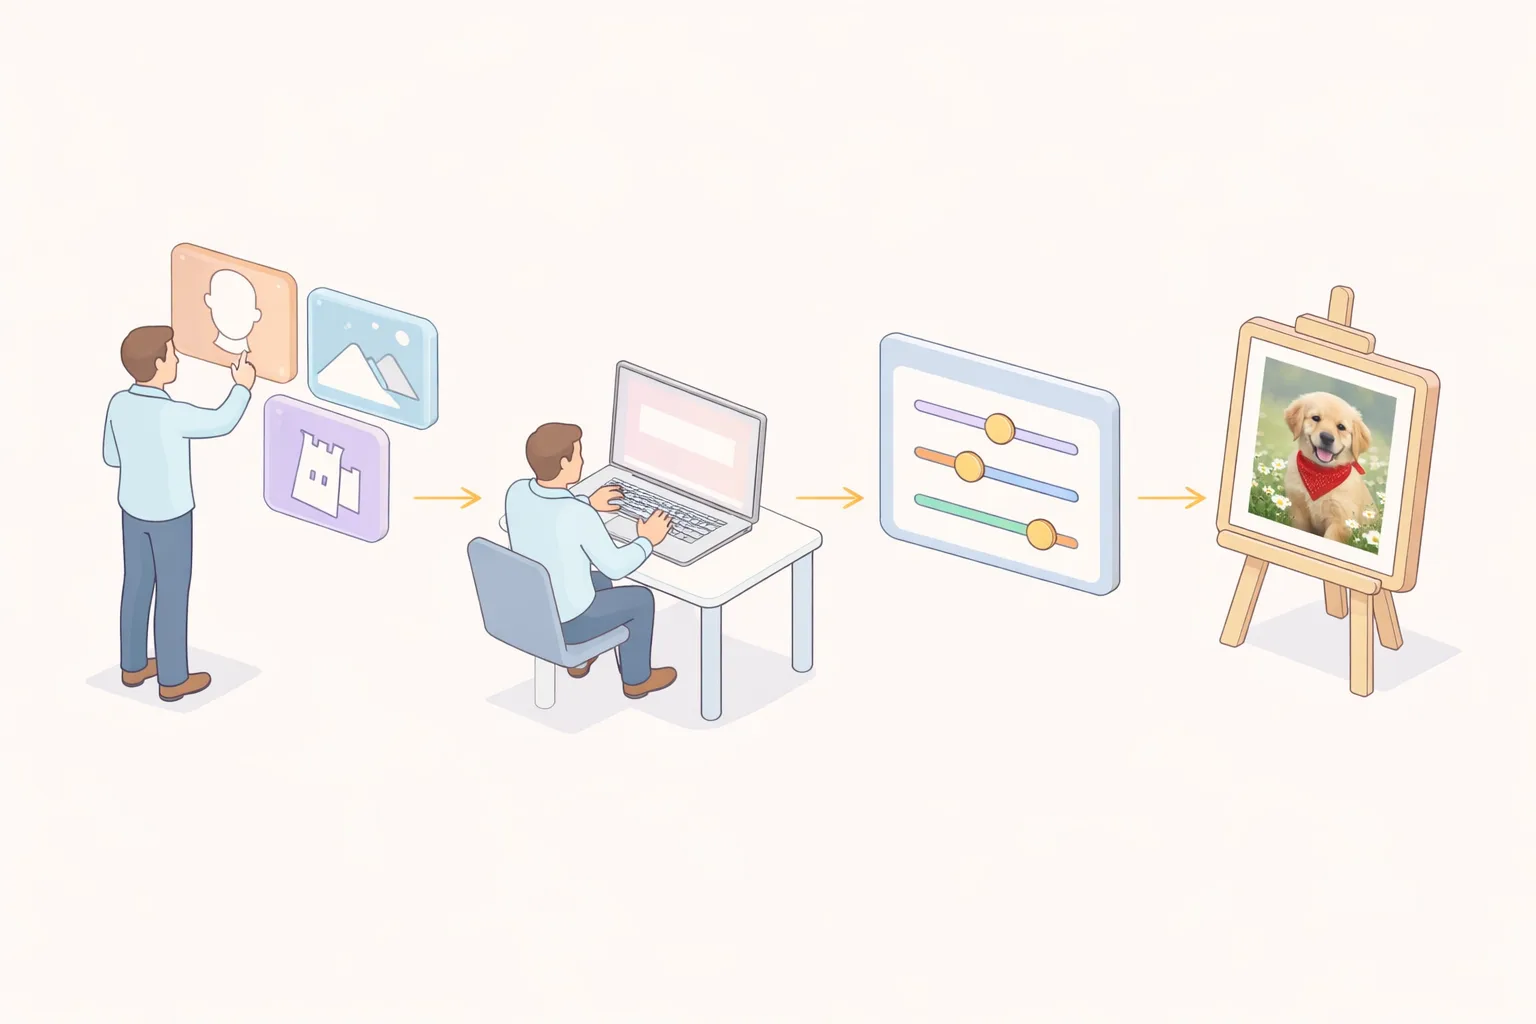
1단계 — 작업에 맞는 모델 고르기
모델마다 개성이 있습니다. 잘못된 모델을 쓰는 것은 스포츠 사진작가에게 결혼식을 찍어 달라고 하는 것과 같습니다.
- 사실적 표현 → Flux 1.1 Pro 또는 Midjourney V7. 둘 다 피부, 직물, 자연광을 플라스틱처럼 보이지 않게 다룹니다.
- 스타일라이즈드 아트나 일러스트 → Midjourney V7 또는 SDXL. 기본 상태에서 색 구성이 더 좋습니다.
- 이미지 속 텍스트(포스터, 간판, 로고) → Flux Pro 또는 DALL·E 3. 구형 모델은 단어를 알아볼 수 없는 글자로 만듭니다.
- 품질보다 속도 → Flux Schnell. 이미지당 2초 미만, 빠른 반복에 유용합니다.
어떤 것이 맞을지 모르겠다면, 텍스트-투-이미지 AI 페이지에서 17개 모델을 하나의 입력창으로 쓸 수 있습니다. 모델마다 잘하는 것과 이미지 한 장의 가격도 정리해 두었습니다.
아직 모르겠다면 하나를 골라 한나절 동안 매달리세요. 10분마다 도구를 바꾸면 아무것도 배우지 못합니다.
2단계 — 네 부분으로 된 프롬프트 작성하기
좋은 프롬프트는 네 가지 질문에 답합니다. 하나라도 빠지면 모델이 추측하고 — 그 추측은 대개 평범합니다.
| 부분 | 질문 | 예시 |
|---|---|---|
| 대상 | 사진에 무엇이 있나요? | a border collie catching a frisbee |
| 배경 | 어디서, 언제? | on a windy beach, late afternoon light |
| 스타일 | 어떻게 보이나요? | shot on Fujifilm X-T5, 35mm, shallow depth of field |
| 품질 | 얼마나 다듬어졌나요? | sharp focus, natural colors, no filter |
이어 붙이면:
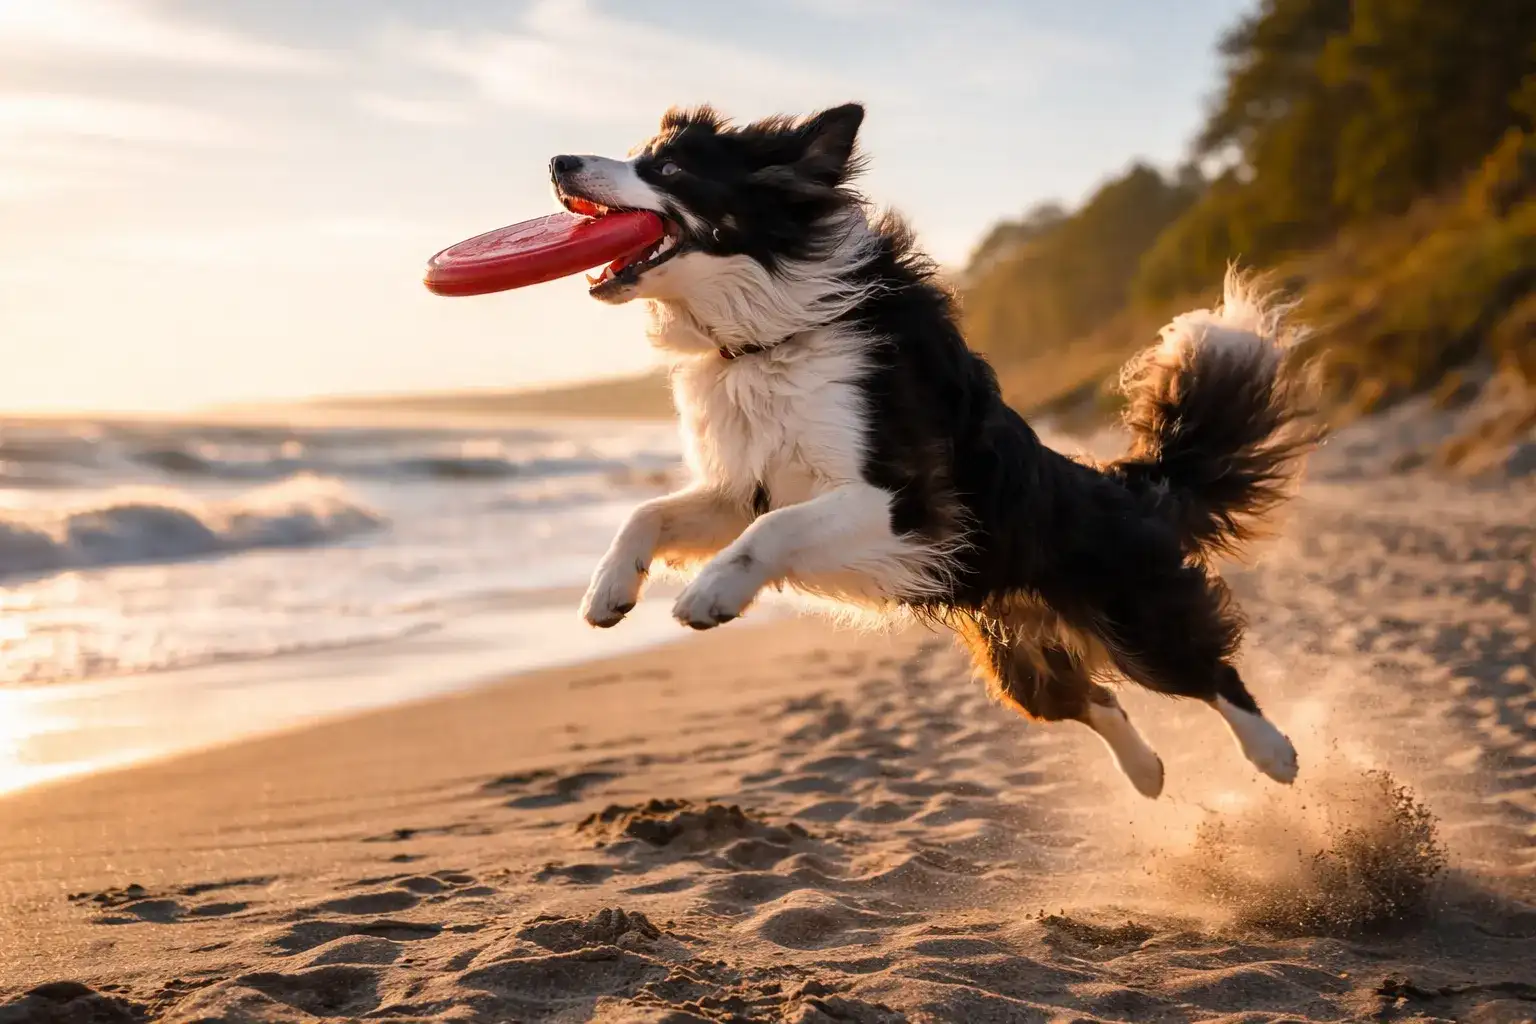
a border collie catching a frisbee on a windy beach, late afternoon light,
shot on Fujifilm X-T5, 35mm, shallow depth of field, sharp focus, natural colors
그게 전부입니다. 마법의 단어도, 비밀 파라미터도 없습니다. 그 프롬프트가 저희에게 준 결과는 이렇습니다:
3단계 — 세 가지 파라미터 조정하기 (나머지는 무시)
대부분의 플랫폼은 열다섯 개의 슬라이더를 들이댑니다. 당신에게 필요한 건 셋뿐입니다.
- 시드(Seed) — 같은 시드에 같은 프롬프트는 같은 이미지를 줍니다. 마음에 드는 것을 유지하면 그 주변으로 반복할 수 있습니다.
- 스텝(Steps) — 스텝이 많을수록 디테일이 늘고 기다림이 길어집니다. 30이 최적점입니다. 50 이상은 효과가 줄어듭니다.
- CFG / 가이던스 — 모델이 프롬프트를 얼마나 바짝 따르는지. 기본값은 7입니다. 정밀함에는 10으로 올리고, 창의적 해석에는 4로 내리세요.
나머지 — 샘플러, 스케줄러, 클립 스킵 — 는 더 나은 프롬프트만큼 중요하지 않습니다.
4단계 — 다시 시작하지 말고 반복하기
첫 이미지는 절대 적중하지 않습니다. 두 번째도 대개 그렇습니다.
한 번에 하나씩만 바꾸세요. 장면 전체가 아니라 렌즈를 바꾸세요. 대상이 아니라 시간대를 바꾸세요. 어떤 단어가 그림을 움직였는지 추적하세요 — 그게 여기서 진짜 기술이며, 익히는 데 쉰 번쯤의 생성이 걸립니다.
스무 번째 시도에서도 여전히 잘못돼 보인다면, 문제는 아마 프롬프트가 아닙니다. 모델입니다. 1단계를 참고하세요.
2026년 써 볼 가치가 있는 도구
가격과 기능은 몇 달마다 바뀝니다. 이 글을 쓰는 시점 기준으로, 각 도구가 이기는 지점은 이렇습니다.
| 도구 | 최적 용도 | 속도 | 가격 | 강점 |
|---|---|---|---|---|
| Anyscene | 장면 기반 생성, 마케터 | ~8초 | 무료 + 유료 등급 | 장면 프리셋, 원클릭 변형 |
| Midjourney V7 | 기본 상태의 아름다움 | ~15초 | 월 $10부터 | 후처리 불필요 |
| Flux 1.1 Pro | 사실성, 읽히는 텍스트 | ~10초 | 이미지당 결제 | 손, 얼굴, 타이포그래피 |
| Stable Diffusion 3.5 | 오픈소스, 로컬 사용 | GPU에 따라 다름 | 무료 | 완전한 제어, 검열 없음 |
| DALL·E 3 | 대화 중심 편집 | ~20초 | ChatGPT Plus 통해 | 다중 턴 다듬기 |
저희의 솔직한 견해: 오늘 결과가 필요하면 Anyscene이나 Midjourney로 시작하세요. 이미지 속 텍스트나 상업급 사실성이 필요하면 Flux로 넘어가세요. GPU와 주말 하나를 쓸 여유가 있을 때만 Stable Diffusion에 손대세요.
진짜로 그림을 움직이는 프롬프트 엔지니어링
대부분의 "프롬프트 가이드"는 똑같은 다섯 가지 아이디어를 열두 단락으로 늘립니다. 여기 짧은 버전이 있습니다.
재사용하는 4부 공식
대상 · 배경 · 스타일 · 품질. 모든 프롬프트에 쓰세요. 외우고 프롬프트 가이드 읽기를 멈추세요.
복사해 쓰는 10가지 프롬프트 템플릿
이 중 아무거나 붙여 넣고, 명사를 바꾸면, 작동하는 프롬프트가 됩니다.
1. Product photography: matte-white ceramic {product} on a peach-to-coral
   gradient background, studio softbox lighting, soft shadow, centered, 1:1.

2. Isometric SaaS illustration: a cloud dashboard with floating charts,
   pastel palette, clean lines, marketing style, 16:9.

3. Anime portrait: young woman with short black hair, cherry blossoms
   drifting, cel shading, pastel colors, 2:3.

4. Architectural concept: modernist house with glass walls, cantilevered
   over a pine forest at dusk, warm interior glow, cinematic, 16:9.

5. Botanical watercolor: eucalyptus sprig, loose brushstrokes, soft greens,
   paper texture, white background, 1:1.

6. Low-poly 3D scene: tiny mountain village with pine trees and a river,
   mint and sky-blue palette, soft ambient occlusion, 16:9.

7. Pixel art: cozy wizard's study, bookshelves, crystal ball, black cat,
   warm candlelight, 16-bit style, 1:1.

8. Minimalist line drawing: hand holding a coffee cup, thin black line
   on off-white paper, centered, 1:1.

9. Cyberpunk cityscape: neon pink and teal signage, wet streets, light
   rain, lone silhouette, anamorphic lens, 16:9.

10. Studio food photography: overhead shot of ramen with soft-boiled egg,
    scallions, nori, dark slate background, side lighting, 1:1.
각각은 대상 · 배경 · 스타일 · 품질을 따릅니다. 그 관점으로 다시 읽어 보세요.
네거티브 프롬프트
모델이 지원한다면, 네거티브 프롬프트는 재시도를 절반으로 줄입니다. 네거티브 필드에 이것을 붙여 넣고 넘어가세요:
blurry, extra fingers, deformed hands, text artifacts, watermark,
low contrast, oversaturated, distorted face
네거티브 프롬프트 필드를 노출하지 않는 모델(DALL·E 3)은 이것을 무시합니다. 노출하는 모델(Flux, SD, --no가 있는 Midjourney)은 고마워할 것입니다.
이미지가 망가져 나올 때: 해결 표
이 부분은 대부분의 가이드가 건너뜁니다. 출력이 잘못됐을 때 필요한 건 더 많은 이론이 아니라 — 찾아보기 표입니다.
| 문제 | 원인 | 해결 |
|---|---|---|
| 손가락 여섯 개, 뭉개진 손 | 팔다리 학습 부족 | anatomically correct hands, five fingers 추가; 네거티브 필드에 deformed hands, extra fingers |
| 간판의 깨진 글자 | 토크나이저가 철자를 못 씀 | Flux Pro나 DALL·E 3으로 전환; 텍스트는 네 단어 이하로; 따옴표로 감싸기 |
| 얼굴이 어색함 | 화면비가 너무 넓음 | 인물에는 16:9가 아니라 2:3이나 3:4 사용 |
| 색이 바램 | CFG가 너무 낮음 | 가이던스를 8~10으로 올리기 |
| 모든 얼굴이 똑같음 | 기본 체크포인트 편향 | 구체적인 인종, 나이, 특징 추가 |
| 이상하거나 밋밋한 조명 | 프롬프트에 빛 방향 없음 | rim light, golden hour, 또는 studio softbox 추가 |
| 대상이 작아 장면에 묻힘 | 프레이밍 단어 없음 | close-up, medium shot, 또는 wide angle 추가 |
| 이미지가 AI 생성 티가 남 | 과하게 매끈한 피부, 대칭 얼굴 | film grain, natural imperfections, asymmetric features 추가 |
이 표를 코팅해 두세요. 다시 찾게 될 겁니다.
사람들이 실제로 쓰는 용도
미술 전시가 아닙니다. 진짜, 평범하고, 쓸모 있는 것들입니다.
블로그·기사 비주얼. 스톡 사진 대체가 저희가 보는 가장 큰 단일 용도입니다. 프롬프트 하나, 라이선스 절차 없음, 정확히 당신 주제에 맞춤. 이 가이드도 셋을 씁니다.
제품 목업. 디자이너가 손대기 전에 패키지 디자인을 보세요. 한나절에 병 모양 다섯 가지를 테스트하세요. 비싼 렌더 전에 잘못돼 보이는 것을 걸러내세요.
소셜 콘텐츠. 열 시간이 아니라 한나절에 게시물 변형 열 개를. 같은 프롬프트, 다른 시드, 가장 좋은 둘을 고르기.
스토리보드·콘셉트 작업. 예산을 쓰기 전에 아이디어를 시각적으로 테스트하세요. 광고, 제품 출시, 그리고 윗선에 제안해야 하는 모든 것에 좋습니다.
리스팅·카탈로그. 같은 제품 샷의 배경 변형을 생성하세요. 사진 한 장에 캠페인 다섯 개가 있을 때 유용합니다.
이 이미지에 자기 자신을 넣고 싶으신가요? AI 이미지 생성기에 자신을 넣는 방법 보기 →
30초로 보는 법적 사항
짧은 버전: 도구의 라이선스가 허용하면 상업적 이용은 대체로 괜찮습니다. Anyscene, Midjourney 유료 등급, Flux Pro, DALL·E 3은 모두 상업적 출력을 허용합니다.
여전히 곤란해질 수 있는 두 가지가 있습니다. 살아 있는 아티스트의 스타일을 지정하는 프롬프트(in the style of [Name])는 잘해야 회색 지대이고 최악의 경우 소송 대상입니다. 상표가 있는 캐릭터 — 미키 마우스, 포켓몬, 브랜드 로고 — 를 재현하는 출력물의 책임은 도구가 아니라 당신에게 있습니다.
일부 관할권은 이제 광고와 편집 콘텐츠에 AI 고지를 요구합니다. 게시 전에 현지 규정을 확인하세요.
자주 묻는 질문
AI 텍스트-투-이미지는 무료인가요? 네, 대부분의 플랫폼에서 하루 제한된 생성까지는 무료이며 Anyscene도 포함됩니다. 유료 등급은 속도, 더 높은 해상도, 상업적 라이선스를 줍니다.
초보자에게 가장 좋은 AI 이미지 생성기는? Anyscene이나 Midjourney. 둘 다 평범한 말로 작동합니다. 첫날 배워야 할 파라미터가 없습니다.
AI 생성 이미지를 상업적으로 사용할 수 있나요? 대부분의 유료 등급에서는 가능합니다. 구체적인 플랜의 라이선스 페이지를 확인하세요. 무료 등급 이미지는 흔히 사용 제한이 따릅니다.
GPU가 필요한가요? Stable Diffusion을 로컬로 실행할 때만요. 웹 도구는 연산을 대신 해 줍니다.
이미지 한 장에 얼마나 걸리나요? Flux Schnell 같은 빠른 모델에서는 2초. 고품질 모델에서는 최대 30초.
왜 제 이미지가 계속 똑같아 보이나요? 같은 시드이거나, 같은 짧은 프롬프트입니다. 둘 중 하나를 바꾸세요.
AI가 이미지에 읽히는 텍스트를 그릴 수 있나요? Flux Pro와 DALL·E 3은 가능합니다. 텍스트는 네 단어 이하로 유지하세요. 구형 모델은 그보다 길면 무엇이든 뭉갭니다.
이것이 디자이너를 대체하나요? 스톡 사진과 콘셉트 스케치에는 대체로 그렇습니다. 브랜드 아이덴티티와 프로덕션 아트에는 아닙니다 — 여전히 누군가는 무엇이 좋은지 정해야 합니다.
첫 문장을 입력하세요. 그게 중요한 유일한 단계입니다.
다음 읽을거리: Kling 2.6이 동영상 생성을 어떻게 바꿨는지 →