 Anyscene AI
텍스트-투-이미지 AI
보고 싶은 장면을 글로 쓰면 이미지로 돌려받습니다. 모든 텍스트-투-이미지 모델이 하나의 입력창을 함께 쓰고, 가격은 누르기 전에 버튼에 표시됩니다.
예시로 시작하기
프롬프트 하나, 스타일 여섯
같은 텍스트-투-이미지 프롬프트, 여섯 가지 스타일
생성기의 스타일 메뉴는 프롬프트 끝에 짧은 문구 하나를 붙입니다. 같은 여우 프롬프트를 이 페이지의 기본 텍스트-투-이미지 모델인 Seedream 5.0 Flash로 여섯 가지 스타일에 모두 돌려, 그 문구 하나가 그림을 얼마나 바꾸는지 확인했습니다.
실제로 보낸 프롬프트
A red fox sitting on a snowy forest path at night, reading a paper map by the light of a small lantern, [style] style
- 피사체
- 장소
- 빛
- 스타일
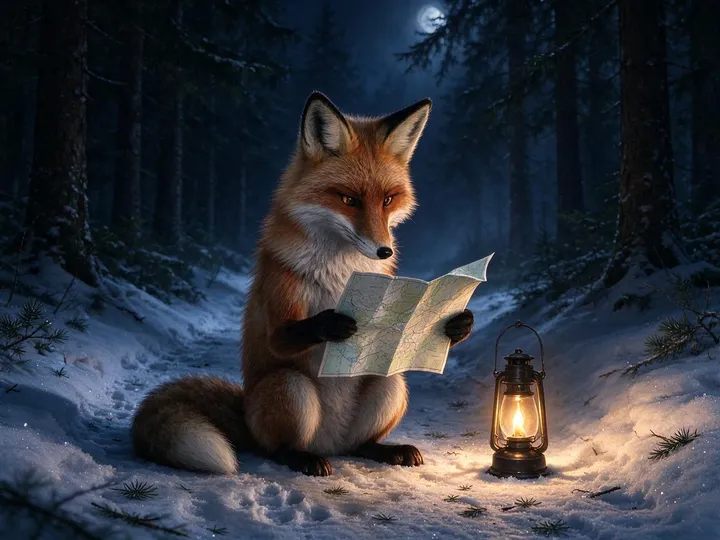
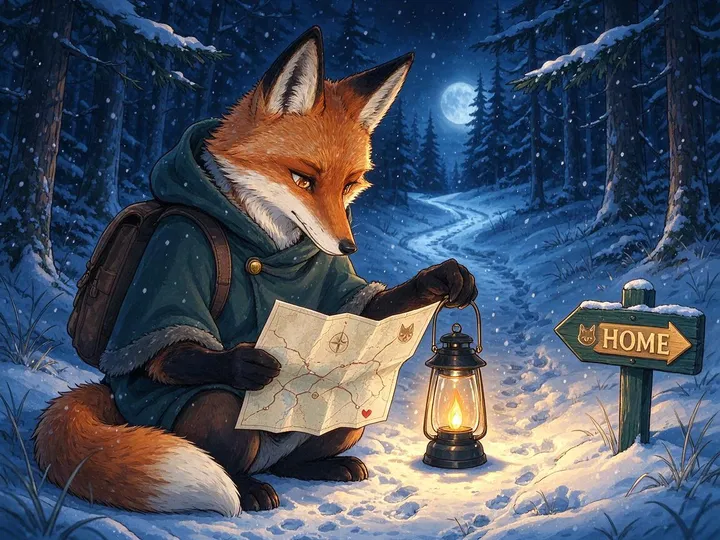
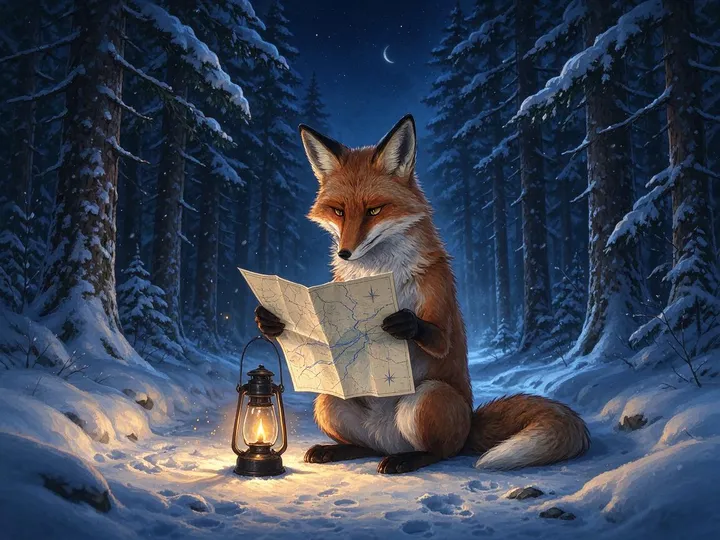
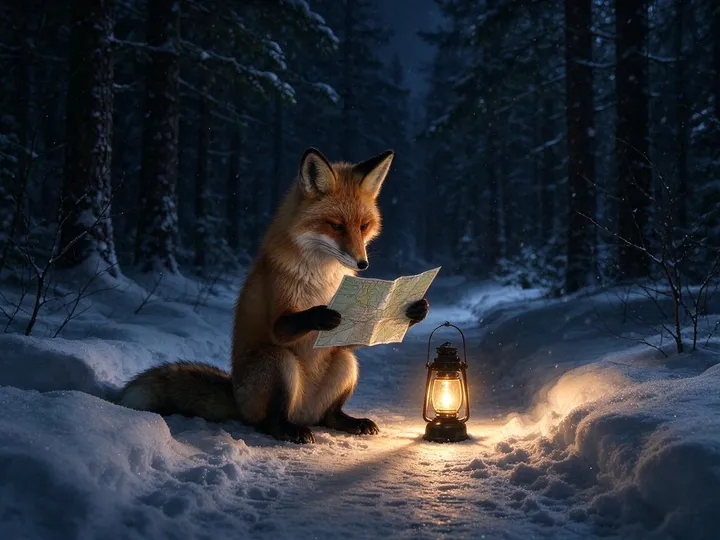
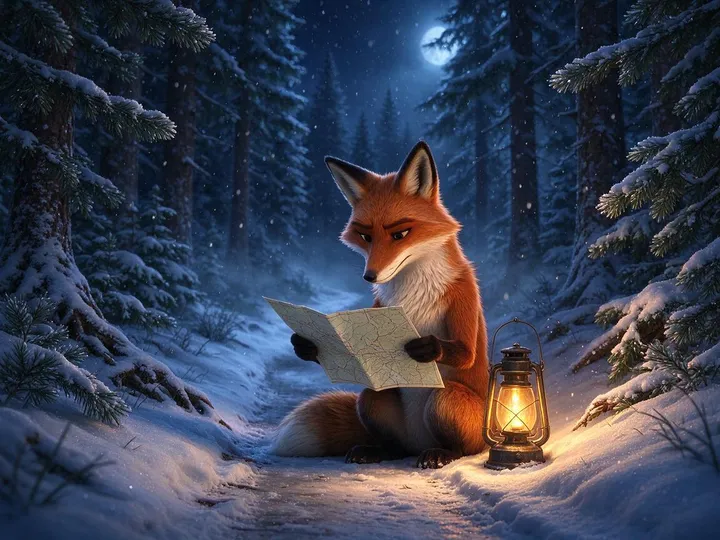
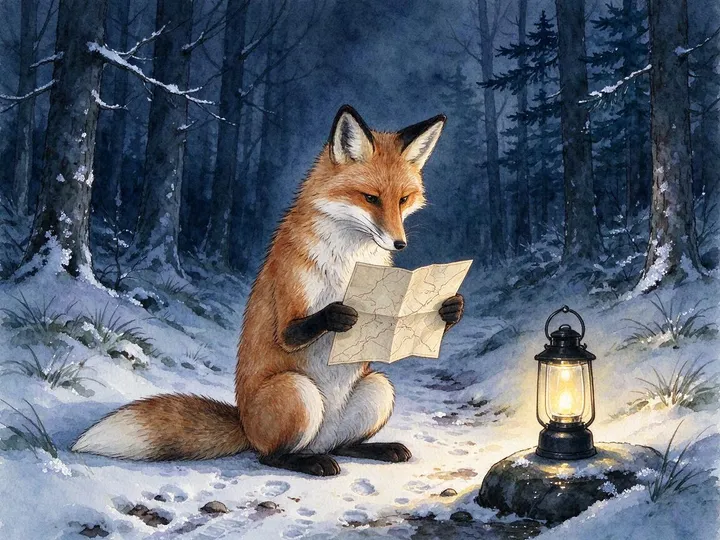
달라진 것과 달라지지 않은 것
- 가장 크게 달라진 것은 애니메이션입니다. 여우가 후드 코트를 입고 배낭을 멨고, HOME이라고 적힌 표지판까지 생겼습니다. 모두 프롬프트에 없던 것입니다.
- 수채화는 윤곽이 부드러워지고 눈이 밝아졌지만 구도는 그대로였습니다.
- 디지털 아트, 시네마틱, 3D 모델은 포토리얼과 거의 비슷하게 나왔습니다. 이 모델에서 스타일 단어는 지시가 아니라 살짝 미는 정도입니다.
- 스타일이 먹히지 않으면 재질을 직접 쓰세요. "부드러운 점토 질감과 스튜디오 조명의 3D 렌더"가 "3D 모델 스타일"보다 훨씬 많은 것을 알려 줍니다.
2026년 10월 23일에 스타일마다 한 번씩 돌린 텍스트-투-이미지 생성 6회이며, 다시 돌리거나 보정하지 않았습니다. 장당 14~25초가 걸렸습니다.
한마디로
텍스트-투-이미지 AI란?
AI 텍스트-투-이미지는 생성형 AI 가운데 그림을 그리는 부분입니다. 글로 장면을 설명하면 모델이 그려 냅니다.
텍스트-투-이미지 AI는 프롬프트라고 부르는 글 설명을 새 이미지로 바꾸는 소프트웨어입니다. 설명이 달린 이미지 수백만 장으로 학습한 모델이 프롬프트를 읽고 그에 맞는 픽셀을 생성합니다. 사진, 일러스트, 글자가 들어간 포스터까지, 비율은 원하는 대로 고를 수 있습니다.
당신의 프롬프트
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out, shot from a low angle with a wide 24mm lens, long exposure that smooths the water, cinematic colors
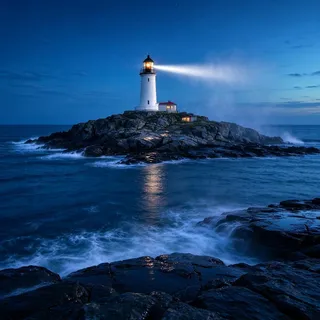
확산 방식을 단순하게 그린 그림이며, 실제 생성 과정의 프레임이 아닙니다. 마지막 그림은 아래 4단계의 등대입니다.
노이즈를 걷어내는 모델
Flux, Seedream, Qwen Image를 비롯한 대부분의 텍스트-투-이미지 모델은 확산 모델 또는 플로 모델입니다. 노이즈에서 출발해 프롬프트의 안내를 받으며 단계적으로 다듬습니다. 최신 모델은 앞단에 언어 모델을 두어, 세상에 대한 이해를 바탕으로 프롬프트를 읽습니다.
"The model couples the Mistral-3 24B parameter vision-language model with a rectified flow transformer."
Black Forest Labs, FLUX.2 발표 글챗봇 안에 들어 있는 모델
OpenAI의 GPT Image 계열은 별도의 이미지 모델을 붙인 것이 아니라, ChatGPT를 움직이는 GPT-4o에 내장된 이미지 생성에서 시작했습니다. OpenAI에 따르면 자세한 지시를 따를 수 있고, 이미지에 글자를 넣는 일도 안정적으로 해냅니다.
"…because it is embedded natively, deep in the architecture of our omnimodal GPT‑4o model, 4o image generation can use everything it knows…"
OpenAI, 4o 이미지 생성 시스템 카드이상한 손과 깨진 글자를 고치는 방법까지 담긴 긴 버전이 필요하다면 텍스트-투-이미지 가이드 읽기 →
프롬프트 하나, 네 단계
텍스트-투-이미지 프롬프트가 구체적으로 바뀌는 과정
프롬프트가 짧으면 모든 선택을 모델이 합니다. 아래 단계마다 같은 등대 프롬프트에 한 종류씩 디테일을 더했습니다. 새로 넣은 단어는 표시하고, 앞서 넣은 단어는 회색으로 두었습니다.
 1 / 4
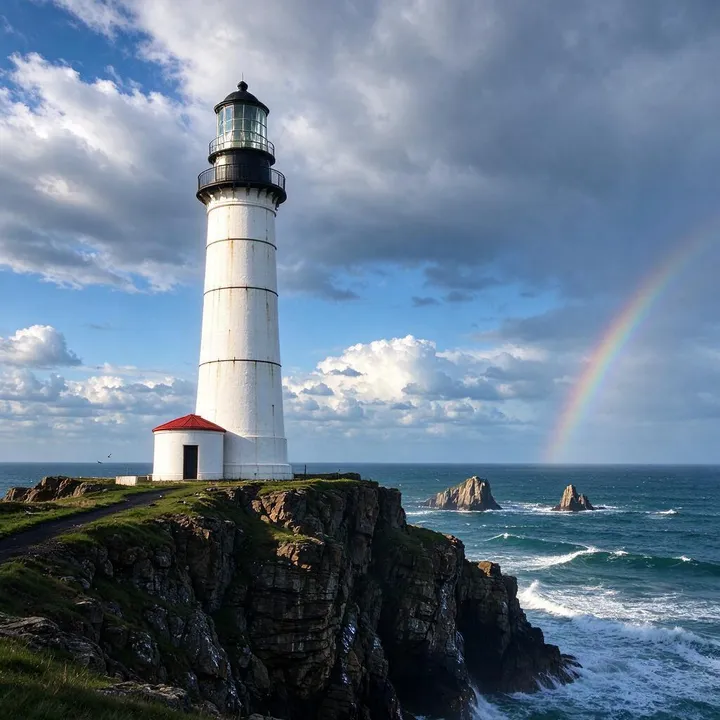
1. 피사체만
A lighthouse
두 단어로는 맑은 날 절벽 위의 등대와 무지개가 나왔습니다. 나머지는 모두 모델이 가장 흔한 등대 그림으로 채웠습니다.
 2 / 4
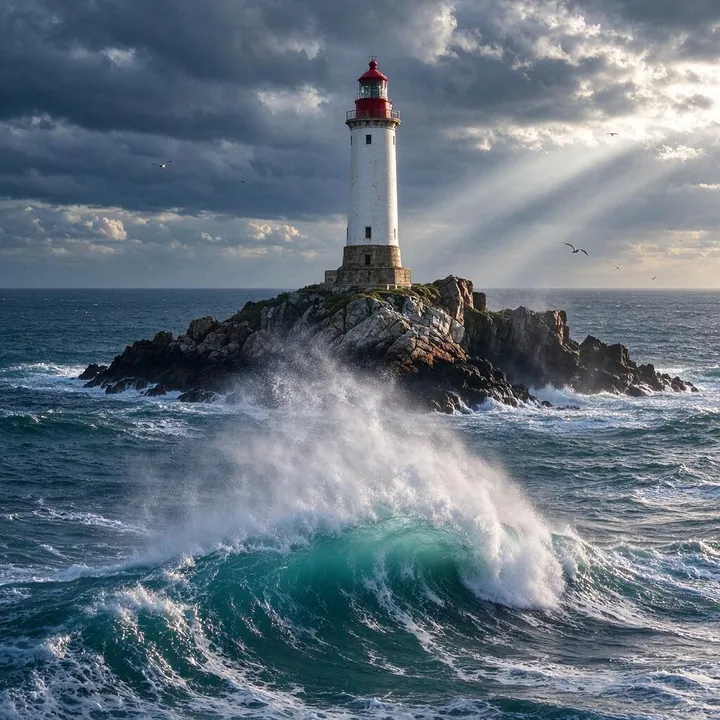
2. 장소 더하기
A lighthouse on a rocky island, waves breaking against the rocks below
장소를 적자 등대가 먼바다의 바위 위로 옮겨 갔고, 앞에 부서지는 파도가 생겼습니다.
 3 / 4
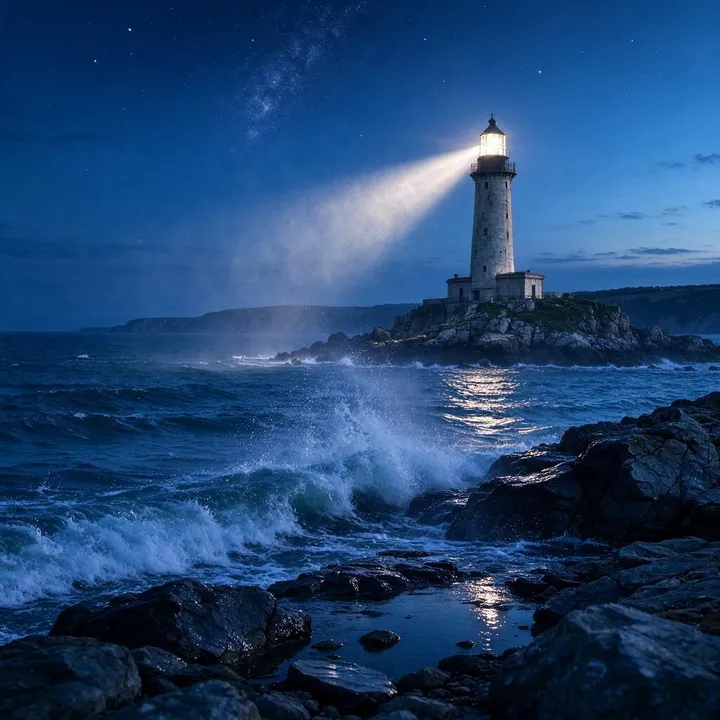
3. 빛과 시간 더하기
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out
블루 아워, 안개, 별이 분위기를 통째로 바꿨습니다. 이번 생성에서는 이 단계에서 그림이 가장 많이 달라졌습니다.
 4 / 4
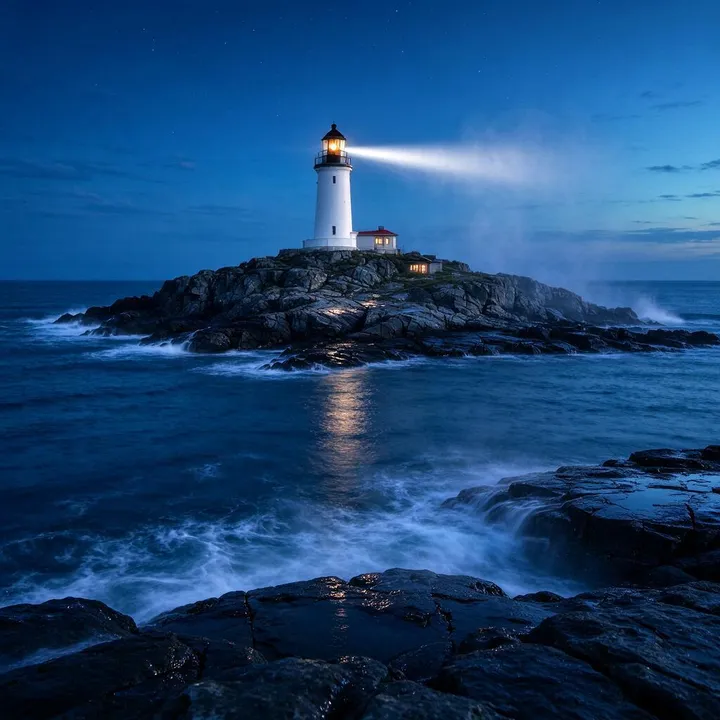
4. 카메라 더하기
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out, shot from a low angle with a wide 24mm lens, long exposure that smooths the water, cinematic colors
장노출로 물결은 매끄러워졌지만 24mm 로우 앵글은 거의 드러나지 않습니다. 이 모델이 가장 덜 따른 것은 카메라 단어였습니다.
Seedream 5.0 Flash, 1:1, 2026년 10월 23일에 단계마다 한 번씩 텍스트-투-이미지를 생성했고, 장당 14~19초가 걸렸습니다.
프롬프트 빌더
텍스트-투-이미지 프롬프트 만들기
무엇을 써야 할지 모르겠다면, 이 텍스트-투-이미지 프롬프트 생성기에 피사체를 하나 쓰고 그룹마다 문구를 하나씩 고르세요. 프롬프트가 저절로 완성됩니다. 페이지 맨 위 생성기로 보내거나 복사할 수 있습니다.
내 프롬프트
도자기 커피 머그, 창가의 나무 테이블 위, 부드러운 아침 햇살
- 피사체
- 장소
- 빛
- 카메라
- 스타일
- 글자
- 피사체를 맨 앞에 두세요. 그 앞에 놓인 단어가 주인공으로 오해받지 않습니다.
- 장소 하나, 빛 하나, 스타일 하나. 스타일이 둘이면 서로 잡아당깁니다.
- 느낌보다 눈에 보이는 것을 쓰세요. "안개와 낮게 뜬 해"가 "감성적인"보다 잘 통합니다.
- 그려 넣을 글자는 따옴표 안에, 짧을수록 좋습니다.
이미지 속 글자
AI 이미지 속 글자를 정확하게 쓰게 하는 법
간판, 라벨, 포스터 제목은 텍스트-투-이미지 AI가 가장 자주 틀리던 곳이었습니다. 지금의 모델은 프롬프트만 제대로 쓰면 짧은 글자를 정확하게 씁니다. 아래 네 장이 그 예입니다.
01
넣을 글자는 그대로 따옴표 안에
따옴표는 텍스트-투-이미지 모델에게 표현할 뜻이 아니라 그릴 글자라고 알려 줍니다. 책과 차에 관한 간판이 아니라 "Books & Tea"라고 적힌 간판이라고 쓰세요.
02
글자가 들어갈 자리를 쓰기
손글씨 간판 위에, 라벨 위에, 포스터 맨 위에. 자리가 없는 글자는 허공에 떠 있거나 엉뚱한 곳에 들어갑니다.
03
글씨체를 설명하기
손글씨, 굵은 글자, 우아한 세리프체. 글씨체를 정해 주면 모델이 맞출 기준이 생겨 글자 모양도 고르게 나옵니다.
04
짧게 쓰고, 한 글자씩 확인하기
아래 예시에서 따옴표 안의 글자는 모두 한 줄에 영어 여섯 단어 이하입니다. 모델은 아무도 부탁하지 않은 글자를 더하기도 합니다. Seedream 5.0 Pro는 커피 인포그래픽에 부제와 설명 문구를 붙였습니다.
 1
 2
 3
 4
1Nano Banana Pro16:9
A cozy bookshop storefront on a cobblestone street at dusk, a hand-painted sign reading "The Paper Lantern — Books & Tea", warm light spilling from the windows, a bicycle leaning against the wall
2GPT Image 2.52:3
A vintage travel poster for Kyoto: a five-storey pagoda among cherry blossoms at sunset, the title "KYOTO" in bold letters at the top and "Cherry Blossom Season" at the bottom, flat screen-print style
3Nano Banana Pro4:5
A kraft-paper coffee bag on a café counter, the label printed with "MORNING RITUAL — Single Origin, Ethiopia" in an elegant serif, soft morning light, shallow depth of field
4Qwen Image 3.03:4
A chalkboard café menu titled "Morning Menu" listing Espresso 3.00, Latte 4.50 and Croissant 3.50, hand-lettered, warm café light
모델 페이지의 결과이며, 각각 한 번씩만 생성했습니다. 따옴표 안의 글자는 모두 쓴 그대로 나왔지만, 게시하기 전에 직접 쓴 글자의 철자도 확인하세요.
모든 모델의 가격
어떤 텍스트-투-이미지 모델을 고를까
17개 모델 모두 같은 프롬프트를 받습니다. 다른 점은 잘하는 것, 필요한 크레딧, 돌려주는 이미지의 크기입니다. 아래 표의 크레딧, 크기, 이용 가능한 계정은 생성 버튼이 쓰는 것과 같은 가격표에서 가져왔습니다.
표를 옆으로 밀면 모든 열을 볼 수 있습니다.
| 모델 | 잘하는 것 | 장당 크레딧 | 최대 크기 | 이용 범위 |
|---|---|---|---|---|
| Basic | 아이디어를 시험하는 빠른 초안 | 2 크레딧 | 1K | 모든 계정 |
| Z-Image | 텍스트만으로 만드는 저렴한 이미지 | 2 크레딧 | 1K | 모든 계정 |
| Seedream 5.0 Flash | 저렴한 일상용 이미지, 이 페이지의 기본 텍스트-투-이미지 모델 | 5 크레딧 | 2K | 모든 계정 |
| GPT Image 1.5 | 길고 자세한 프롬프트를 충실히 따름 | 6 크레딧 | 1K | 모든 요금제 또는 크레딧 팩 |
| Nano Banana | 평범한 장면, 그리고 피사체를 그대로 두는 편집 | 6 크레딧 | 1K | 모든 요금제 또는 크레딧 팩 |
| Nano Banana 2 Lite | 단순한 장면과 음식 사진을 Nano Banana 중 가장 낮은 가격으로 | 6 크레딧 | 1K | 모든 계정 |
| Wan 2.7 Image | 저렴하면서 일상용으로 충분한 품질, Pro 등급은 더 섬세함 | 6–20 크레딧 | 4K | 모든 요금제 또는 크레딧 팩 |
| Flux 2 | 사진 같은 디테일(Pro)과 가장 정교한 타이포그래피(Flex) | 8–36 크레딧 | 2K | 모든 요금제 또는 크레딧 팩 |
| GPT Image 2 | 깔끔한 글자, 레이아웃, UI 목업 | 8–22 크레딧 | 4K | 모든 요금제 또는 크레딧 팩 |
| Nano Banana 2 | 초대 Nano Banana보다 선명한 디테일 | 8–22 크레딧 | 4K | 모든 요금제 또는 크레딧 팩 |
| Qwen Image 3.0 | 글자가 들어간 메뉴, 간판, 포스터를 중간 가격으로 | 8 크레딧 | 2K | 모든 요금제 또는 크레딧 팩 |
| GPT Image 2.5 | 문구가 한 글자도 틀리면 안 되는 포스터와 앱 화면 | 10–26 크레딧 | 4K | 모든 요금제 또는 크레딧 팩 |
| Seedream 5 Lite | 최대 3K의 크고 섬세한 이미지 | 10–14 크레딧 | 3K | 모든 요금제 또는 크레딧 팩 |
| Seedream 5.0 Pro | 자연스러운 피부 질감의 인물 사진과 인포그래픽 | 11–22 크레딧 | 2K | 모든 요금제 또는 크레딧 팩 |
| Nano Banana Pro | 가장 어려운 프롬프트와 작고 정확한 글자 | 29–38 크레딧 | 4K | 모든 요금제 또는 크레딧 팩 |
텍스트-투-이미지 모델은 모두 17개입니다. 아직 써 보지 않은 모델이 있다면, 그 모델 페이지에서 실제 생성 예시를 볼 수 있습니다.
텍스트를 이미지로 만드는 3단계
첫 단어부터 이미지 다운로드까지, 텍스트-투-이미지는 세 단계면 됩니다. 기본 모델이라면 기다리는 시간은 30초가 채 안 됩니다.
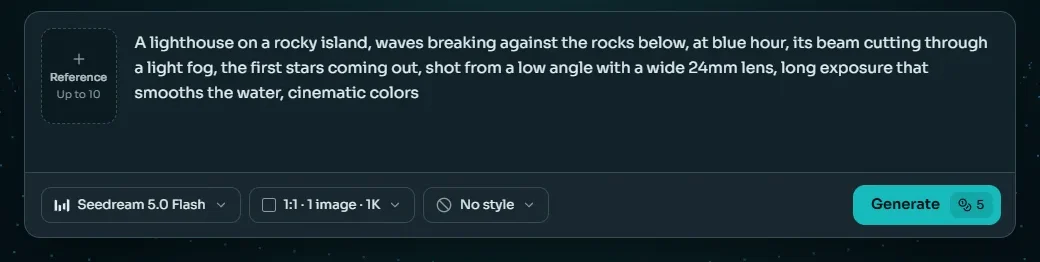
1단계: 프롬프트 쓰기
페이지 맨 위의 텍스트-투-이미지 입력창에 이미지에 담을 것을 쓰세요. 피사체를 먼저, 그다음 장소, 빛, 스타일 순서입니다. 막막하다면 프롬프트 빌더나 입력창 아래의 예시에서 시작하세요.
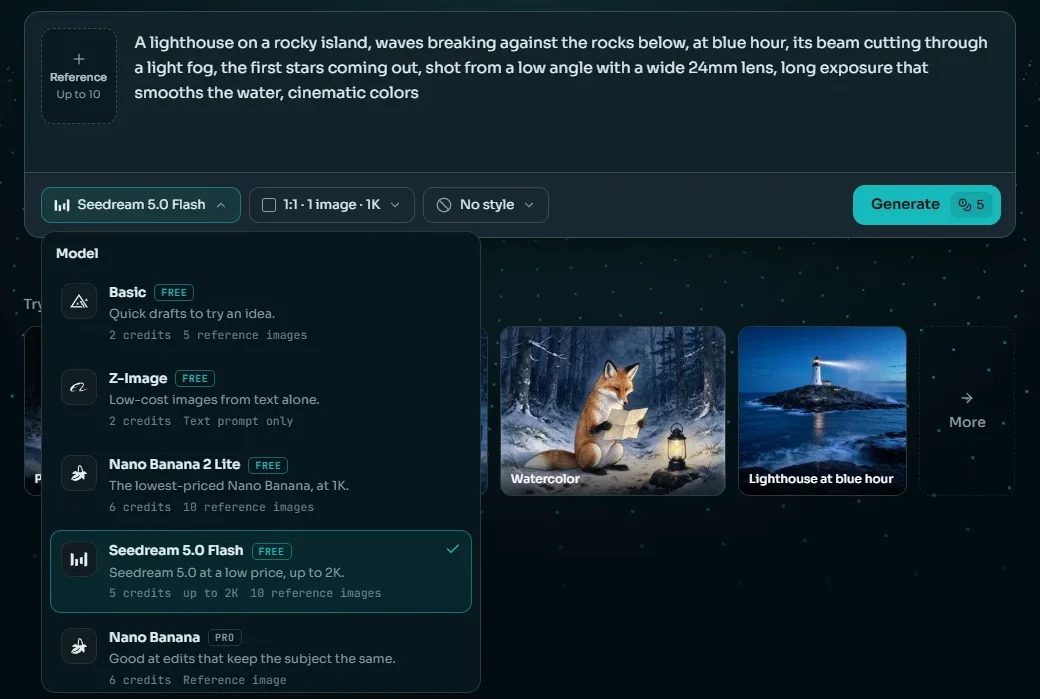
2단계: 모델, 비율, 스타일 고르기
처음에는 Seedream 5.0 Flash가 선택되어 있습니다. 첫 번째 버튼으로 모델을 바꾸고, 배너는 16:9, 스토리는 9:16처럼 비율을 고른 뒤, 원하면 스타일을 더하세요. 생성 버튼의 가격도 함께 바뀝니다.
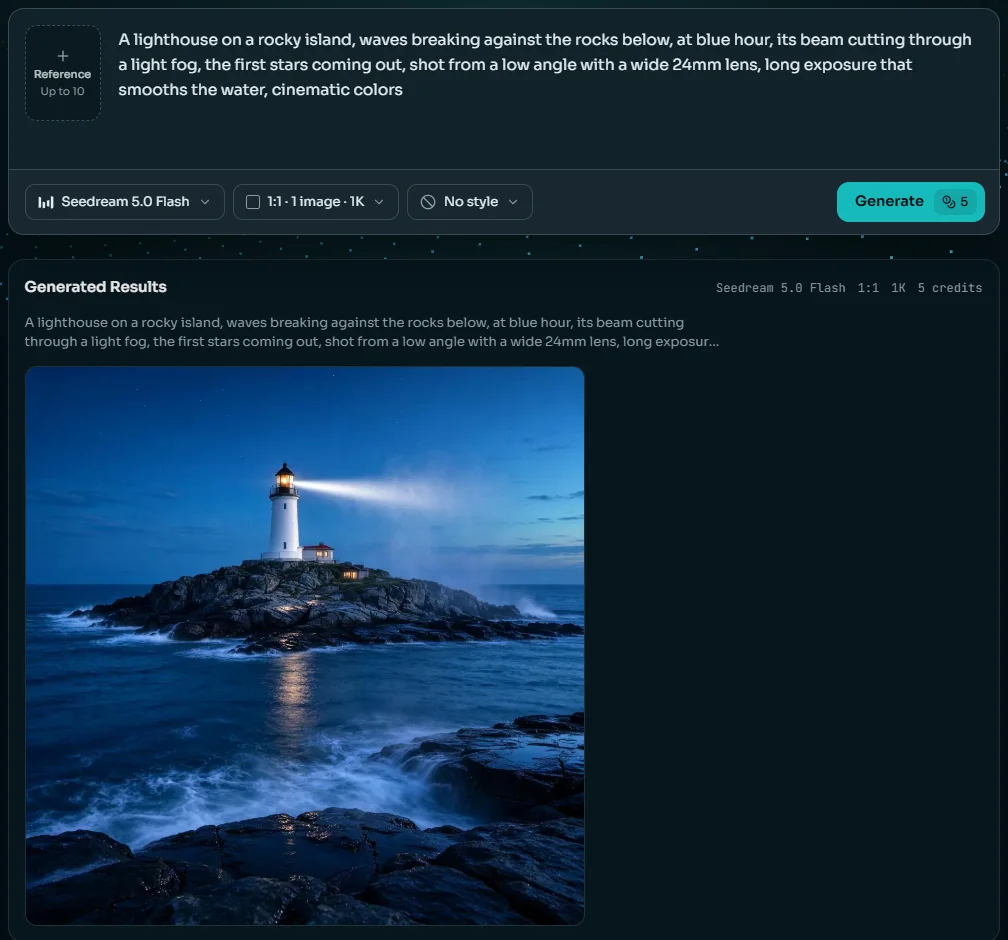
3단계: 생성하고, 비교하고, 고치기
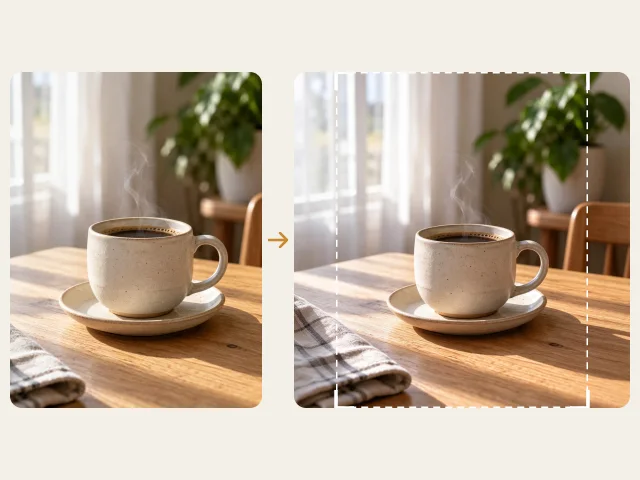
생성을 누르면 입력창 아래에 이미지가 그 이미지를 만든 프롬프트와 함께 나타납니다. 프롬프트의 한 부분을 바꿔 다시 돌리거나, 같은 문장으로 다른 모델을 써 보거나, 결과를 편집기, 업스케일, 동영상으로 넘길 수 있습니다.
사람들이 만드는 것
텍스트-투-이미지 AI로 만드는 것들
모델 페이지에 있는 실제 텍스트-투-이미지 결과 여섯 장과, 보통 그다음에 쓰는 도구를 함께 소개합니다.


야생동물과 스톡 사진 느낌의 이미지
기사와 슬라이드에 쓸 자연 사진을 스톡 사이트를 뒤지지 않고. 인쇄하기 전에 업스케일하세요.

이미지를 만드는 세 가지 방법
텍스트-투-이미지, 이미지-투-이미지, AI 이미지 편집기?
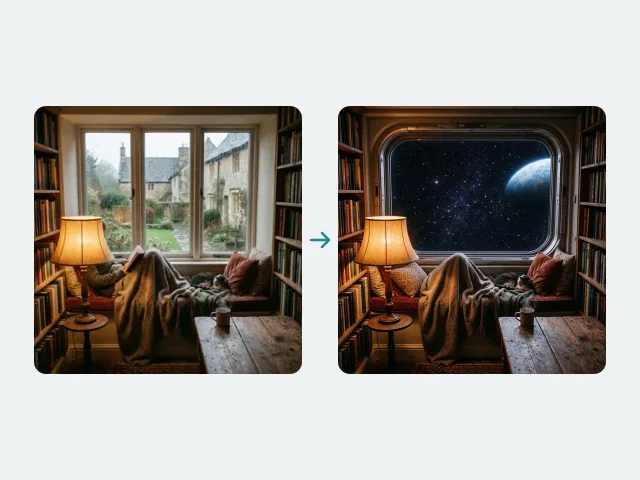
텍스트-투-이미지, 이미지-투-이미지, 이미지 편집은 모두 같은 모델로 돌아갑니다. 무엇에서 시작하느냐가 어느 쪽을 쓸지 정합니다.
| 텍스트-투-이미지 | 이미지-투-이미지 | AI 이미지 편집기 | |
|---|---|---|---|
| 시작하는 것 | 글자만 | 글과 한 장 이상의 참고 이미지 | 내 사진과 지시 한 문장 |
| 그대로 남는 것 | 없음: 매번 새 이미지 | 참고 이미지의 피사체, 분위기, 레이아웃 | 바꾸라고 하지 않은 모든 것 |
| 잘 맞는 용도 | 새 아이디어, 포스터, 처음부터 만드는 장면 | 다른 이미지의 스타일이나 피사체로 새 이미지 만들기 | 실제 사진 바꾸기: 배경, 옷, 글자, 빛 |
| 같은 캐릭터를 다시 | 어려움: 매번 자세히 설명 | 참고 이미지가 있어 비교적 쉬움 | 사진 속 바로 그 사람 |
| Anyscene에서는 | 바로 이 페이지 | 같은 입력창에 참고 이미지 추가 | AI 이미지 편집기 페이지 |
참고 이미지 칸에 이미지를 넣으면 이 페이지의 텍스트-투-이미지 생성기가 이미지-투-이미지가 되고, 생성 버튼에 새 가격이 표시됩니다.
솔직한 한계
텍스트-투-이미지가 아직 실수하는 곳
어떤 텍스트-투-이미지 모델이든 틀리는 부분이 있습니다. 우리가 가장 자주 보는 여섯 가지와 각각의 대처법입니다.
긴 글자
문장 하나나 작은 글씨 한 단락은 아직도 깨져 나옵니다. 따옴표 안의 글자는 줄마다 짧게 쓰거나, 나중에 편집기에서 넣으세요.
정확한 개수
"새 일곱 마리"가 다섯 마리나 아홉 마리로 나올 수 있습니다. 개수가 적을수록 잘 맞고, 많을 때는 결과를 세어 보고 다시 돌리세요.
군중 속의 손과 얼굴
화면에 한 사람이면 대개 잘 나옵니다. 여러 사람 속의 작은 얼굴과 손에서 모양이 틀어지니, 인물을 가까이 두거나 수를 줄이세요.
왼쪽, 오른쪽, 뒤쪽
"개 왼쪽에 있는 고양이"는 생각보다 잘 지켜지지 않습니다. 화면 어디에 무엇이 있는지 쓰고, 어긋나면 편집기에서 옮기세요.
실존 인물과 브랜드
실존 인물, 로고, 내 것이 아닌 캐릭터의 이름을 넣은 프롬프트는 거절될 수 있고, 그런 이미지를 쓰면 다른 사람의 권리를 침해할 수 있습니다. 이름 대신 생김새를 설명하세요.
모든 텍스트-투-이미지 모델을 하나의 잔액으로
이미지 한 장은 모델과 크기에 따라 2~38크레딧이고, 기본 모델은 5크레딧입니다. 요금제는 연간 결제 시 월 $15.9부터이며, 크레딧 팩으로 어떤 요금제에든 충전할 수 있습니다.
표시된 가격은 연간 결제를 월 단위로 환산한 금액입니다. 월간 요금과 크레딧 팩은 요금 페이지에서 확인하세요.
텍스트-투-이미지 AI 자주 묻는 질문
글로 쓴 설명을 새 이미지로 바꾸는 AI입니다. 프롬프트를 입력하면 설명이 달린 이미지로 학습한 모델이 그에 맞는 이미지를 생성하고, 이를 다운로드하거나 편집하거나 동영상으로 만들 수 있습니다.
대부분의 모델은 확산 모델 또는 플로 모델로, 무작위 노이즈에서 시작해 프롬프트의 안내를 받으며 노이즈를 조금씩 걷어냅니다. OpenAI의 GPT Image 계열처럼 언어 모델에 내장된 최신 모델도 있으며, 긴 지시와 이미지 속 글자에 강합니다.
하나만 정답인 모델은 없습니다. 일상용 이미지는 기본 모델인 Seedream 5.0 Flash(5크레딧)로 시작하세요. 글자가 들어가면 Nano Banana Pro나 GPT Image 2.5, 인물 사진은 Seedream 5.0 Pro, 아이디어 시험에는 2크레딧인 Basic이나 Z-Image가 좋습니다.
Basic과 Z-Image의 2크레딧부터 4K Nano Banana Pro의 38크레딧까지이며, 기본 모델은 5크레딧입니다. 가격은 누르기 전에 생성 버튼에 표시되고, 실패한 이미지는 크레딧이 돌아옵니다. 새 계정에는 40크레딧이 있어, 무료 계정에 열린 네 모델(Basic, Z-Image, Seedream 5.0 Flash, Nano Banana 2 Lite)에 쓸 수 있습니다.
네. Anyscene에서 만든 것은 광고, 상품 페이지, SNS 게시물을 포함해 모두 상업적으로 쓸 수 있습니다. 권리가 없는 실존 인물, 로고, 캐릭터를 프롬프트에 넣지는 마세요. 이미지를 만든다고 그 권리가 생기지는 않습니다.
넣을 글자를 그대로 따옴표 안에 쓰고, 들어갈 자리와 글씨체를 설명하고, 줄마다 짧게 쓰세요. 우리 모델 페이지에서 Nano Banana Pro, GPT Image 2.5, Qwen Image 3.0은 따옴표 안의 글자를 모두 정확하게 썼습니다. 게시하기 전에 원본 크기로 한 글자씩 확인하세요.
네. 대부분의 모델은 영어뿐 아니라 한국어, 중국어, 일본어, 스페인어, 프랑스어, 독일어, 포르투갈어 프롬프트도 읽습니다. 모델이 잘못 알아들으면 같은 프롬프트를 영어로 시도해 보세요. 이미지에 그릴 글자는 보여야 할 모양 그대로 따옴표 안에 넣는 것이 가장 확실합니다.
텍스트-투-이미지는 글만으로 시작하므로 매번 새 이미지가 나옵니다. 이미지-투-이미지는 참고 이미지를 더해, 그 이미지의 피사체, 스타일, 레이아웃을 이어받습니다. 같은 입력창에 참고 이미지를 넣으면 전환됩니다.
모델마다 다릅니다. Basic과 Z-Image는 약 1K, Seedream 5.0 Flash는 최대 2K, Nano Banana 2, Nano Banana Pro, GPT Image 2, GPT Image 2.5, Wan 2.7 Image Pro는 최대 4K입니다. 결과는 기록에 30일 동안 남으니, 간직하고 싶은 것은 다운로드하세요.
관련 AI 이미지 도구
같은 크레딧으로, 이미지를 만든 다음 하고 싶어질 일.
다음 이미지는 한 문장에서 시작됩니다
로그인하고 프롬프트를 쓴 뒤 텍스트-투-이미지 모델 17개 중 하나를 고르세요. 기본 모델은 장당 5크레딧이고, 실패한 이미지는 크레딧이 돌아옵니다.