
자, AI 이미지 생성기에 자신을 넣는 방법이 궁금하시군요. 좋은 소식: 방법은 네 가지입니다. 나쁜 소식: 지금까지 읽으신 대부분의 가이드는 그중 하나만, 그것도 보통 당신 용도에 맞지 않는 것만 다룹니다.
이 가이드는 넷을 모두 나란히 펼칩니다 — 각각 얼마나 걸리는지, 비용은 얼마인지, 결과는 얼마나 좋아 보이는지, 그리고 프라이버시 함정은 어디 있는지. 끝까지 읽으면 어떤 방법이 당신 프로젝트에 맞는지 알게 되고 오늘 바로 실행할 도구를 갖게 됩니다.
저희는 Anyscene을 운영하므로 실제 사진과 실제 예산으로 모든 접근법을 시도해 봤습니다. 아래는 2년 전이 아니라 2026년에 통하는 것입니다.
"자신을 넣기"가 하나가 아닌 이유
이 주제의 검색 결과를 읽어 보면 혼란스럽습니다. 어떤 글은 사진 열 장을 업로드해 한 시간 동안 모델을 학습하라고 합니다. 다른 글은 프롬프트에 "나"라고 입력하라고 합니다. 세 번째는 월 30달러짜리 서비스를 밀어붙입니다.
모두 맞습니다. 서로 다른 질문에 답하고 있으니까요.
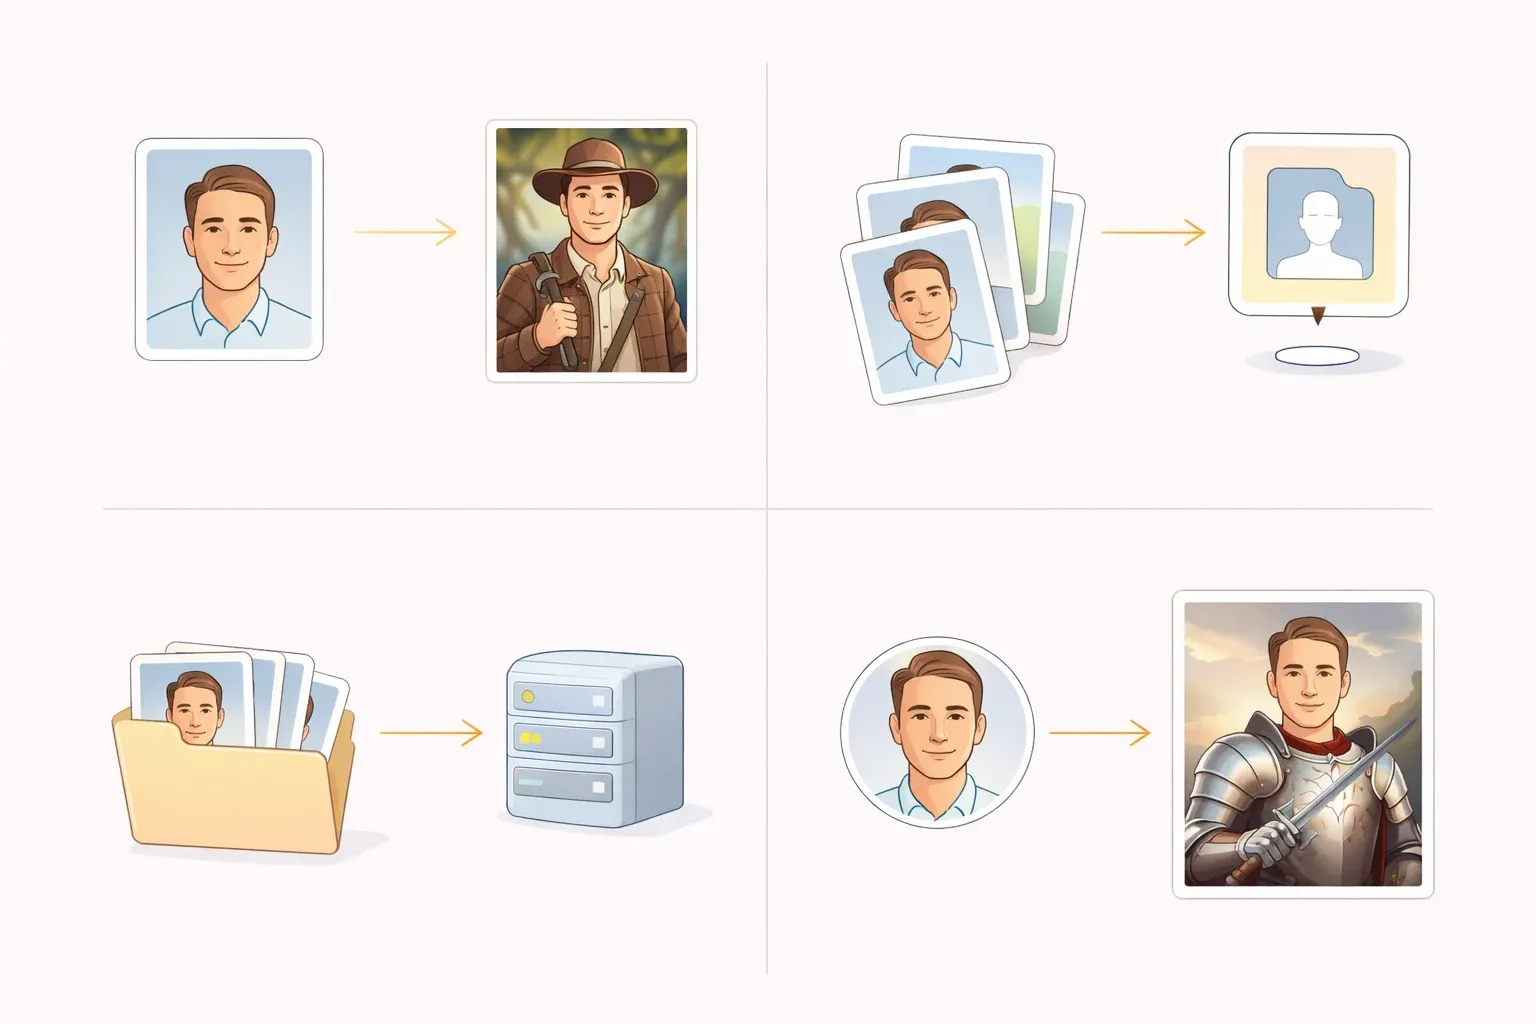
사람들이 AI 이미지 생성기에 자신을 넣는 방법을 검색할 때, 그들이 의미하는 것은 다음 네 가지 중 하나입니다:
- 등장인물이 어렴풋이 나를 닮은 그림을 생성하고 싶다.
- AI에게 내 사진을 보여주고 무언가 스타일라이즈드한 것을 만들게 하고 싶다.
- 내 얼굴을 실제로 학습해 어떤 장면에서든 나를 생성할 수 있는 모델을 원한다.
- 이미 존재하는 특정 이미지에 내 얼굴을 넣고 싶다.
각각 다른 도구, 다른 노력, 다른 비용이 필요합니다. 대부분의 글은 하나를 골라 나머지는 없는 척합니다. 이 글은 그러지 않습니다.
네 가지 방법, 나란히
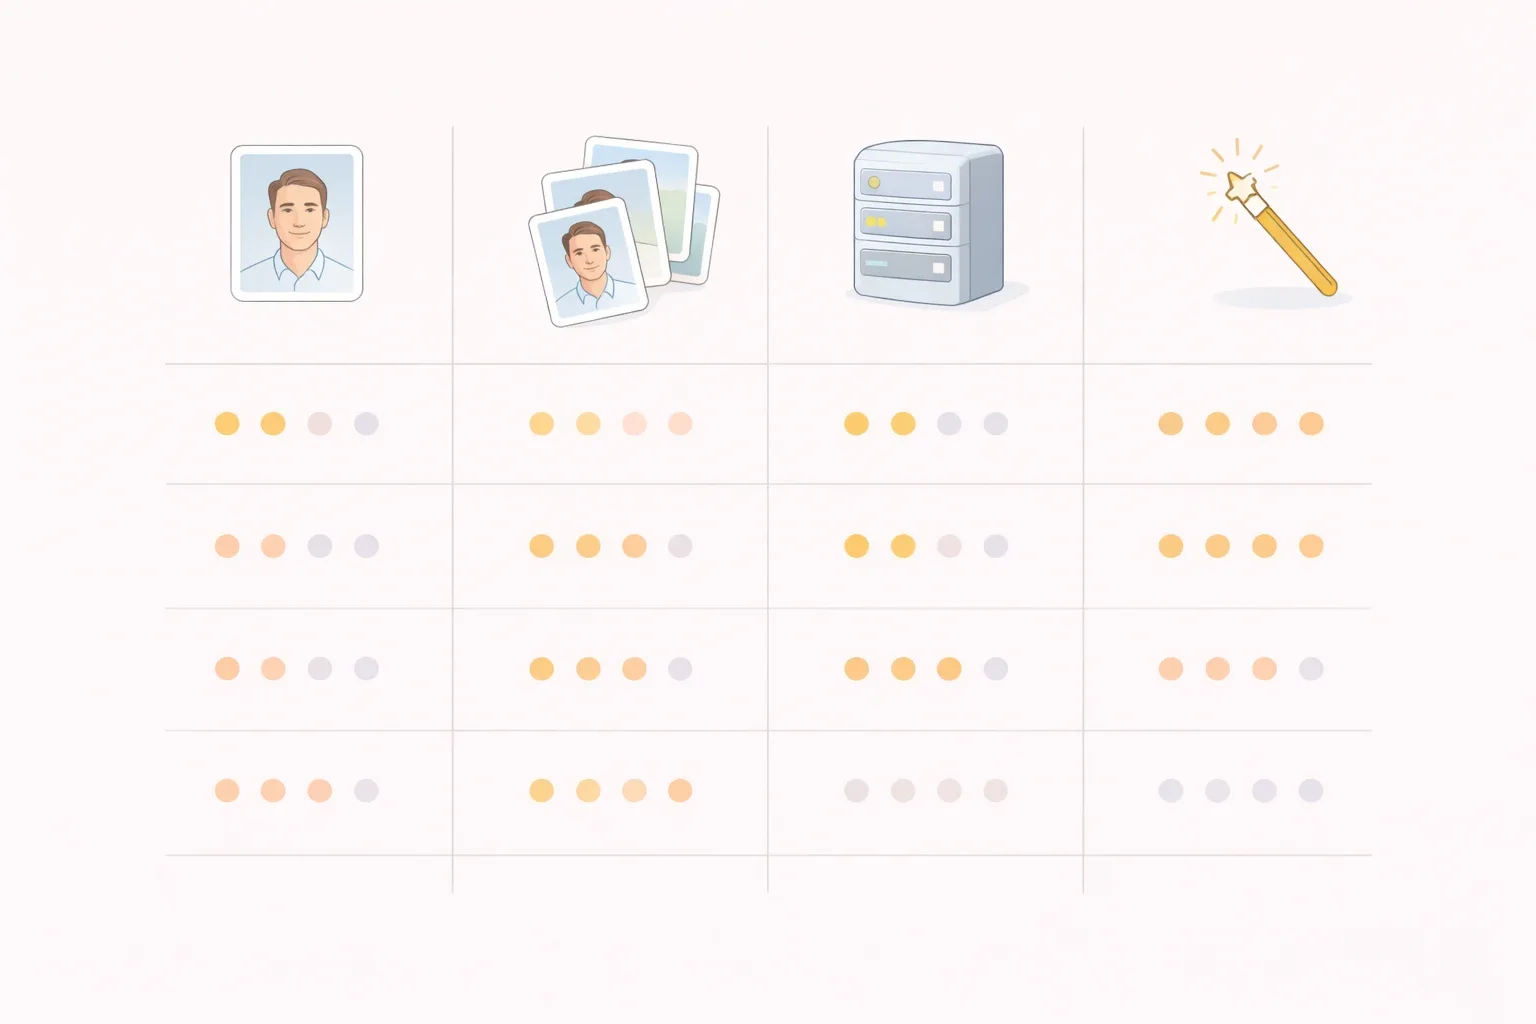
전체 지도를 표 하나에 담았습니다. 다음 섹션에서 각각을 분해합니다.
| 방법 | 필요한 것 | 품질 | 시간 | 비용 | 프라이버시 위험 |
|---|---|---|---|---|---|
| 1 — 프롬프트로 자신을 묘사 | 셀카 1장(선택) | 낮음 | 30초 | 무료 | 낮음 |
| 2 — 참조 사진 업로드 | 사진 1~5장 | 중간 | 2분 | 무료~월 $10 | 중간 |
| 3 — 자신으로 LoRA 학습 | 사진 10~20장 | 높음 | 10~60분 | $3~$15 | 중간~높음 |
| 4 — 이미지에 페이스 스왑 | 대상 이미지 + 셀카 | 중간 | 10초 | 무료 | 낮음 |
잘못 고르면 한나절을 낭비합니다. 제대로 고르면 몇 분 만에 끝납니다.
방법 1 — 그냥 프롬프트로 자신을 묘사하기
가장 간단한 방법. 업로드도, 학습도, 계정 생성도 없습니다. 자신이 어떻게 생겼는지 입력하면 모델이 그 묘사에 맞는 사람을 생성합니다.
"셀프 포트레이트 프롬프트" 작성법
어떤 AI 이미지에도 통하는 같은 4부 구조 — 대상, 배경, 스타일, 품질 — 를 쓰되, 대상 줄을 당신에 대한 정밀한 묘사로 바꿉니다.
a 32-year-old man with short dark hair, warm brown eyes, light stubble,
wearing a navy wool coat, walking through a snowy Brooklyn street at dusk,
shot on Fujifilm X-T5, 35mm, shallow depth of field, natural colors
구체적일수록 출력이 더 가깝게 느껴집니다. 키, 체형, 피부 톤, 머리 길이와 질감, 안경, 수염, 두드러지는 특징 — 모든 단어가 추측을 좁힙니다. 모호한 프롬프트는 마침 머리 색만 같은 낯선 사람을 줍니다.
4부 프롬프트 공식의 전체 설명은 AI로 텍스트에서 이미지를 생성하는 방법 가이드를 참고하세요.
이 방법의 한계
실제로 당신처럼 보이지는 않습니다. 당신의 묘사에 맞는 누군가처럼 보일 뿐이고, 그건 아주 다른 것입니다. 당신 가족이 아닌 쌍둥이, 세쌍둥이, 한 가족 전체.
다음의 경우에는 그게 버그가 아니라 기능입니다:
- "작성자"가 특정한 당신이 아니라 예시적인 블로그 글의 히어로 이미지가 필요할 때.
- 무드보드나 콘셉트 아트를 작성 중이고 얼굴이 중요하지 않을 때.
- 제3자 서버에 개인 데이터를 전혀 남기지 않을 때.
같은 사람이 열 장의 이미지에 일관되게 등장해야 하거나, 이미지에 당신 이름이 캡션으로 달릴 때는 잘못된 도구입니다.
이 접근에 가장 좋은 도구
Anyscene, Midjourney, Meta AI, Microsoft Copilot이 모두 이 방법을 잘 다룹니다. Meta AI는 프롬프트에 me라는 단어를 더하면 당신의 프로필 사진 쪽으로 미묘한 편향이 작동한다는 점에서 독특합니다 — 이미 로그인되어 있다면 유용합니다. 평범한 말로 된 프롬프트로 Anyscene에서 이 방법을 시도해 얼마나 가까워지는지 보세요.
방법 2 — 참조 사진 업로드
충실도가 한 단계 높습니다. 모델에 자신의 사진 한 장 이상과, 등장하고 싶은 장면을 설명하는 프롬프트를 줍니다. 모델은 새 가중치 파일을 학습하는 대신 사진을 시각적 안내로 사용합니다.
비전 기반 생성의 작동 원리
모델은 당신의 사진을 비전 인코더에 통과시켜 얼굴을 나타내는 임베딩을 추출한 뒤, 그 임베딩에 생성을 조건화합니다. 학습은 일어나지 않습니다. 임베딩은 그 생성 동안만 — 또는 도구에 따라 짧은 세션 동안만 — 존재합니다.
스케치 작가에게 참조 사진을 20분 건넸다가 다시 가져가는 것이라고 생각하세요.
단계별 따라하기
흐름은 도구 전반에서 거의 동일합니다:
- 사진 한 장(지원하는 서비스에서는 최대 다섯 장)을 업로드합니다. 얼굴이 또렷하게 보이고, 선글라스 없이, 적당한 빛.
- 원하는 장면의 프롬프트를 작성합니다 — 방법 1과 같은 4부 공식이지만, 사진이 그것을 담고 있으므로 자기 묘사는 빼세요.
- 스타일이나 화면비를 고릅니다.
- 생성합니다. 30초에서 2분 기다립니다.
시도해 볼 만한 도구: Photo AI, Starryai, ImagineMe, Flux Kontext(Flux 자체의 참조 이미지 기능).
이 방법을 선택할 때
중간 지점입니다. 방법 1보다 더 닮고, 방법 3보다 훨씬 덜 수고스럽습니다. 다음의 경우에 쓰세요:
- 스무 장의 배치가 아니라 멋진 이미지 한 장이 필요할 때.
- 학습 서비스에 사진 20장을 넘기고 싶지 않을 때.
- 이미지마다 얼굴이 약간 달라져도 괜찮을 때.
정확도는 각도에 따라 크게 달라집니다. 사진이 정면 스튜디오 샷인가요? 결과는 대개 알아볼 수 있습니다. 3/4 각도나 측면 프로필이 필요한가요? 출력이 변형되기 시작합니다.
방법 3 — 개인화 모델(LoRA) 학습
가장 고품질, 가장 수고스러운 옵션. 당신이 어떻게 생겼는지 학습하는 작은 모델 — LoRA — 를 학습한 뒤 Flux나 Stable Diffusion 같은 베이스 모델에 끼웁니다. 학습 후에는 모든 생성에 당신이 포함됩니다.
LoRA란, 쉬운 말로
LoRA는 Low-Rank Adaptation의 약자입니다. 베이스 모델 위에 얹혀 가중치를 특정 개념 — 이 경우 당신의 얼굴 — 쪽으로 밀어주는 작은 파일(약 5 MB)입니다.
새 AI를 처음부터 학습하는 게 아닙니다. 기존 AI에게 새 단어를 가르치는 것입니다. 학습은 대여한 GPU 시간으로 15분에서 한 시간 걸립니다. 결과 파일은 학습 중에 고른 토큰을 참조하는 어떤 프롬프트와도 작동합니다.
필요한 사진
질이 양을 이기지만, 그래도 다양성이 필요합니다.
- 개수: 10~20장. 10장 미만이면 모델이 학습 부족이고, 20장 초과는 개선을 거의 보기 어렵습니다.
- 각도: 정면, 3/4, 측면의 조합. 그렇지 않으면 모델이 측면 뷰에서 당신을 생성할 수 없습니다.
- 표정: 무표정, 미소, 진지함. 단조로운 세트는 당신을 그 표정에 가둡니다.
- 조명: 다양하게. 실내, 실외, 부드럽게, 강하게. 단조로운 조명은 당신 얼굴이 한 종류의 빛 아래에서만 존재한다고 모델에게 가르칩니다.
- 크롭: 대부분 얼굴과 어깨. 디테일을 위한 클로즈업; 맥락을 위한 미디엄 샷 두세 장.
- 금지: 선글라스, 강한 필터, 단체 사진, 같은 촬영의 중복 샷.
2026년 학습 장소 (가격 포함)
이 글을 쓰는 시점 기준 신뢰할 수 있는 네 가지 옵션. 가격은 모델당 1회입니다.
| 서비스 | 모델 | 학습 시간 | 가격 |
|---|---|---|---|
| Replicate (ostris/flux-dev-lora-trainer) | Flux Dev | 15~25분 | ~$3 |
| fal.ai | Flux 또는 SDXL | 10~20분 | ~$4 |
| Astria | SDXL | 30~60분 | $8~$12 |
| Hugging Face AutoTrain (셀프 호스팅) | Flux 또는 SDXL | 20~40분 | GPU 시간만 |
이후 생성은 같은 플랫폼에서 실행하거나, GPU가 있으면 LoRA 파일을 다운로드해 로컬로 실행하세요.
한 가지 더 결정할 것: 베이스로 Flux냐 SDXL이냐. 2026년 기준 얼굴과 사실적인 피부에는 Flux가, 스타일라이즈드 출력과 더 큰 LoRA 생태계에는 SDXL이 이깁니다. 첫 모델을 학습하고 자신의 사실적인 사진을 생성할 계획이라면 Flux를 쓰세요. 애니메이션, 일러스트, 또는 강하게 스타일라이즈드된 출력을 원한다면 SDXL에는 당신 것 위에 쌓을 수 있는 커뮤니티 LoRA가 더 많습니다. 2026년에 SD 1.5는 피하세요 — 저렴하지만 출력 품질이 두 세대 뒤처져 있습니다.
문제 해결: 언캐니 밸리, 정체성 표류
LoRA 학습은 첫눈에는 괜찮아 보이다가 3초 뒤 잘못돼 보이는 방식으로 미묘하게 어긋나는 곳입니다.
- 밀랍 인형 피부. 학습 데이터가 과하게 필터링됐거나 베이스 모델이 과하게 매끈하게 만듭니다. 프롬프트에
film grain, natural skin texture, pores visible를 더하고 CFG를 6으로 내리세요. - 배치 전반의 정체성 표류. 같은 시드, 같은 프롬프트인데 얼굴이 모두 약간 다릅니다. 토큰 단어를 두 번 더하고 프롬프트에
consistent character를 포함하세요. - 정면에서만 당신처럼 보임. 학습 세트가 너무 정면 위주였습니다. 3/4와 측면 샷을 추가해 재학습하세요.
- 잘못된 피부 톤. 베이스 모델 편향. 프롬프트에 인종과 톤을 명시적으로 지정하세요.
- 세대를 거치며 특징 과장. LoRA 강도가 너무 높을 때 일어납니다. 강도를 1.0에서 0.75로 내리세요.
방법 4 — 기존 이미지에 페이스 스왑
때로는 새 이미지를 원하지 않습니다. 기존의 특정 이미지에서 그 안의 누군가를 당신 얼굴로 바꾸고 싶은 거죠. 그게 페이스 스왑이고, 완전히 다른 파이프라인입니다.
Flux Pro + 인페인팅
2026년 가장 깔끔한 접근. 소스 이미지의 얼굴을 마스킹하고, 참조 셀카를 업로드한 뒤, Flux가 인페인트하게 하세요. 10초, 한 번의 생성, 학습 없음. 장면, 조명, 구성을 보존하고 — 얼굴만 바뀝니다.
소스 얼굴이 당신 셀카와 비슷한 각도일 때 가장 잘 작동합니다. 각도가 어긋나면 눈에 띄는 이음매가 생깁니다.
전용 페이스 스왑 도구
Flux를 세팅하고 싶지 않다면, 전용 서비스가 마스킹을 자동으로 처리합니다.
- Pincel — 대상 이미지와 셀카 한 장을 업로드하면 1분 이내에 스왑.
- Remaker — 무료 등급, 기본적이지만 기능적.
- InsightFace 기반 도구 — 오픈소스, GPU가 있으면 로컬로 실행.
스왑이 학습을 이길 때
다음의 경우 스왑이 이깁니다:
- 들어가고 싶은 특정 이미지 하나가 있을 때(잡지 표지, 그림, 밈 포맷).
- 학습을 기다리고 싶지 않을 때.
- 완벽한 닮음보다 대상 장면이 더 중요할 때.
자신의 일관된 이미지 스무 장이 필요할 때는 학습이 이깁니다. 지금 이미지 한 장이 필요할 때는 스왑이 이깁니다.
어떤 방법을 골라야 할까요?
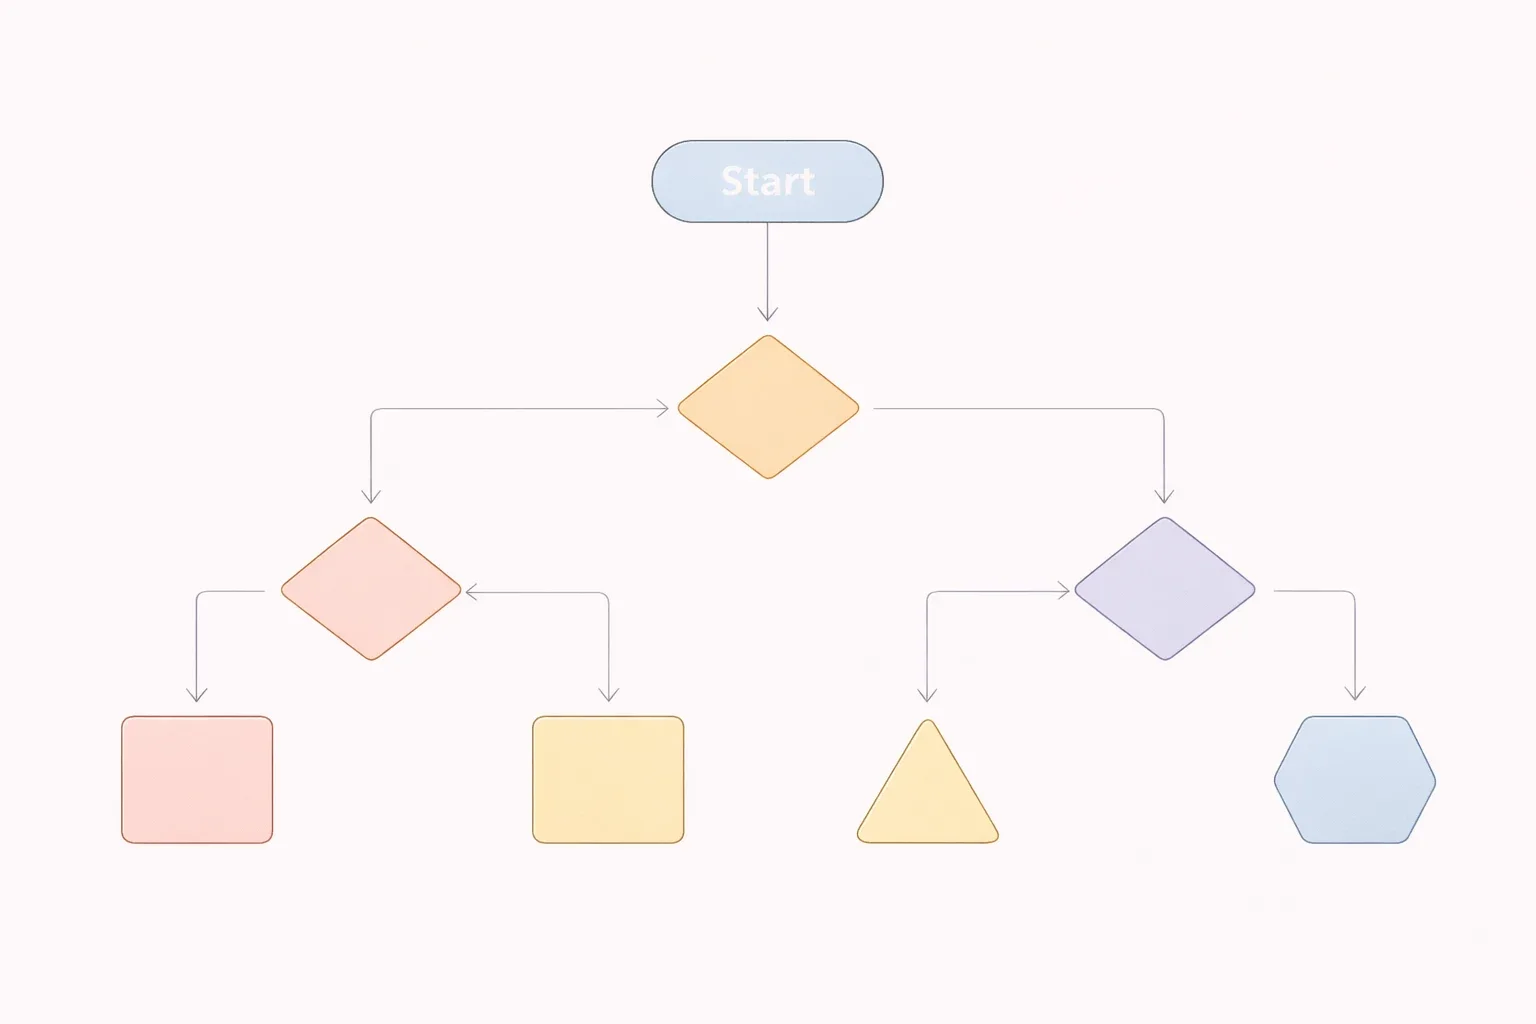
빠른 결정 표:
| 이렇게 하고 싶다면... | 사용 | 이유 |
|---|---|---|
| 아무 부담 없이 한 번 시도 | 방법 1 | 무료, 업로드 없음, 계정 없음 |
| 2분 이내에 괜찮은 헤드샷 얻기 | 방법 2 | 품질과 노력의 최적 균형 |
| 자신의 일관된 이미지 20장 이상 생성 | 방법 3 (LoRA) | 얼굴을 실제로 학습하는 유일한 방법 |
| 기존의 특정 이미지 하나에 얼굴 넣기 | 방법 4 | 장면을 보존하고 얼굴만 교체 |
| 생체 데이터를 제3자 서버에 남기지 않기 | 방법 1 | 아무것도 기기를 벗어나지 않음 |
| 예산이 0일 때 | 방법 1 또는 4 | 둘 다 무료 등급 있음 |
대부분은 과하게 잡습니다. 방법 2로 2분이면 풀렸을 용도에 LoRA를 학습합니다. 실제 필요에 답하는 가장 간단한 방법을 고르세요.
흔한 실패와 해결법
방법마다 고유한 실패 방식이 있습니다. 이 표는 대부분의 가이드가 빠뜨리는 한 가지입니다.
| 문제 | 원인 | 해결 |
|---|---|---|
| 출력이 낯선 사람처럼 보임 | 프롬프트가 너무 모호(방법 1) | 나이, 체형, 피부 톤, 머리, 두드러지는 특징 추가 |
| 생성마다 얼굴이 변형됨 | 학습된 표현 없음(방법 1 또는 2) | 일관성이 필요하면 방법 3(LoRA)으로 전환 |
| 밀랍 인형처럼 보임 | 과하게 매끈한 피부 | film grain, natural skin texture 추가; CFG를 6으로 내리기 |
| 측면에서 당신처럼 안 보임 | 학습 사진이 모두 정면 | 3/4와 측면 샷으로 재학습 |
| 잘못된 피부 톤 | 베이스 모델 편향 | 프롬프트에 인종과 톤 명시 |
| 배치 전반에 정체성 표류 | LoRA 랭크가 너무 낮거나 시드 재사용 | 랭크 16+로 재학습하거나 시드 고정 후 consistent character 추가 |
| 얼굴이 떠 있어 장면 조명과 안 맞음 | 프롬프트에 빛 방향 없음 | matching ambient light 추가하거나 광원 지정 |
| 페이스 스왑에 보이는 이음매 | 각도 불일치 | 대상 얼굴 각도와 맞는 셀카 사용 |
| 몇 세대 뒤 특징 과장 | LoRA 강도가 너무 높음 | 강도를 1.0에서 0.75로 내리기 |
이 표를 저장하세요. 다시 찾게 될 겁니다.
프라이버시, 동의, 그리고 법적 사항
이 섹션은 규칙이 단순해서 짧습니다 — 그리고 대부분의 가이드는 이걸 통째로 건너뜁니다.
당신의 사진은 생체 데이터입니다. EU의 GDPR, 캘리포니아의 CCPA, 그리고 여러 유사 법률에 따라 당신의 얼굴은 보호되는 개인정보입니다. 학습 서비스에 셀카 15장을 업로드한다는 것은 그 서비스와 생체 데이터를 공유한다는 뜻입니다. 그들의 보존 정책을 읽으세요. 일부는 학습 후 삭제하고, 일부는 "모델 개선"을 위해 사진을 무기한 보관합니다.
자신만 학습할 수 있습니다. 동의 없이 타인의 사진으로 모델을 학습하는 것은 최소한 프라이버시 침해입니다. 여러 관할권에서는 콘텐츠를 생성하면 명예훼손이나 사칭이기도 합니다. 전 연인, 상사, 유명인을 학습하지 마세요.
자신의 AI 이미지를 상업적으로 사용하는 것은 대개 괜찮습니다, 도구의 라이선스가 허용한다면요. 링크드인 헤드샷, 자기 사업 광고, 또는 웹사이트에 쓰는 것은 일반적으로 허용됩니다. 복잡해지는 지점은 이미지에 보증을 암시할 수 있는 AI 생성 배경(가짜 식당, 가짜 제품)이 포함될 때입니다. 사용한 도구의 라이선스 페이지를 확인하세요.
일부 플랫폼은 이제 AI 고지를 요구합니다, 광고나 편집 용도에 대해. 프랑스, EU AI Act, 그리고 여러 미국 주 법률이 모두 2026년에 걸쳐 시행되는 규정을 두고 있습니다. 상업적 맥락에서 자신의 AI 이미지를 게시한다면, 게시 버튼을 누르기 전에 현지 요건을 확인하세요.
자주 묻는 질문
무료로 할 수 있나요? 네. 방법 1과 4는 완전히 무료인 경로가 있습니다. 방법 2는 대부분의 도구에 무료 등급이 있습니다. 방법 3(LoRA 학습)만 GPU 시간 결제가 필요한데 — 보통 모델당 1회 $3~$15입니다.
사진이 몇 장 필요한가요?
방법 1: 0장. 방법 2: 15장. 방법 3: 1020장. 방법 4: 대상 이미지 1장과 셀카 1장.
정확히 저처럼 보일까요? 방법 1은 당신 묘사에 맞는 누군가처럼 보입니다. 방법 2는 가깝게 보입니다. 방법 3은 잘 학습하면 정면 샷에서 종종 구별이 안 됩니다. 방법 4는 소스 이미지의 장면을 보존하고 얼굴을 교체합니다 — 정확도는 각도 일치에 달려 있습니다.
자신의 AI 사진을 상업적으로 사용하는 게 합법인가요? 대부분의 유료 등급에서는 네. 구체적인 도구의 라이선스 페이지를 확인하세요. 무료 등급 출력은 흔히 사용 제한이 있습니다.
타인의 사진을 사용하면요? 하지 마세요. 동의 없이 타인의 얼굴 모델을 학습하는 것은 대부분의 관할권에서 프라이버시법을 위반하며, 유해한 콘텐츠를 생성하면 명예훼손이나 사칭이 될 수 있습니다.
Google에 이런 기능이 있나요? Google의 Gemini는 참조 사진을 업로드하고 그 주변 장면을 변환하게 합니다 — 방법 2에 가장 가깝습니다. LoRA 학습은 제공하지 않습니다.
2026년 LoRA 학습은 얼마나 걸리나요?
Replicate, fal.ai, Astria에서 1060분. 소비자용 GPU로 로컬에서는 3090분.
가장 저렴하게 시도하는 방법은? 방법 1. 아무 무료 도구 — Anyscene, Meta AI, Copilot — 의 프롬프트에 자신을 입력하세요. 비용 0, 30초.
LoRA를 학습하려면 GPU가 필요한가요? Replicate, fal.ai, Astria 같은 호스팅 서비스를 쓰면 필요 없습니다 — 그들이 GPU 시간을 대여하고 분 단위로 청구합니다. 로컬로 학습하고 싶다면 필요합니다. VRAM 12 GB의 소비자용 GPU(RTX 3060 이상)는 약 한 시간 만에 Flux LoRA 학습을 처리할 수 있습니다.
방법을 조합할 수 있나요? 네, 그리고 흔히 최상의 결과입니다. 자신으로 LoRA를 학습하고(방법 3), 페이스 스왑(방법 4)으로 LoRA 출력을 아주 특정한 소스 이미지에 넣으세요. 또는 당신의 LoRA를 커뮤니티의 스타일 LoRA와 함께 써서 특정 아트 스타일 속의 자신을 얻으세요.
AI 모델이 저를 영원히 기억하나요? LoRA를 학습할 때만요. 방법 1, 2, 4는 생성이 끝난 뒤 당신 얼굴을 어디에도 보존하지 않습니다. 방법 3은 학습 플랫폼이나 당신 디스크에서 삭제할 때까지 존재하는 파일을 만듭니다.
가장 좋은 방법은 거의 언제나 가장 어려운 것이 아닙니다. 방법 1로 시작하고, 결과가 충분히 좋지 않을 때만 방법 2로 넘어가며, 스무 장의 이미지에 같은 얼굴이 필요할 때만 LoRA 학습으로 가세요.
다음 읽을거리: AI로 텍스트에서 이미지를 생성하는 방법: 완벽 가이드 →