
AI画像ジェネレーターに自分自身を取り込む方法を知りたい、ということですね。良い知らせ:方法は4つあります。悪い知らせ:これまで読んできたほとんどのガイドは1つしか扱っておらず、しかもあなたの用途には合わないものを取り上げていることが多いです。
このガイドでは4つすべてを横並びでまとめます — それぞれにかかる時間、コスト、結果の質、プライバシーの落とし穴。読み終わるころには、あなたのプロジェクトに合う方法が分かり、今日から実行に移すツールが揃っています。
私たちはAnysceneを運営しているため、実際の写真と実際の予算であらゆるアプローチを試してきました。これから書くのは2026年に効くこと、2年前に効いたことではありません。
「自分を取り込む」がひとつの作業ではない理由
このトピックの検索結果を見ると混沌としています。ある記事は10枚の写真をアップして1時間モデルを学習させろと言い、別の記事はプロンプトに「me」と入れろと言い、3つ目の記事は月$30のサービスを推す。
それらはすべて正しい — 異なる質問に答えているからです。
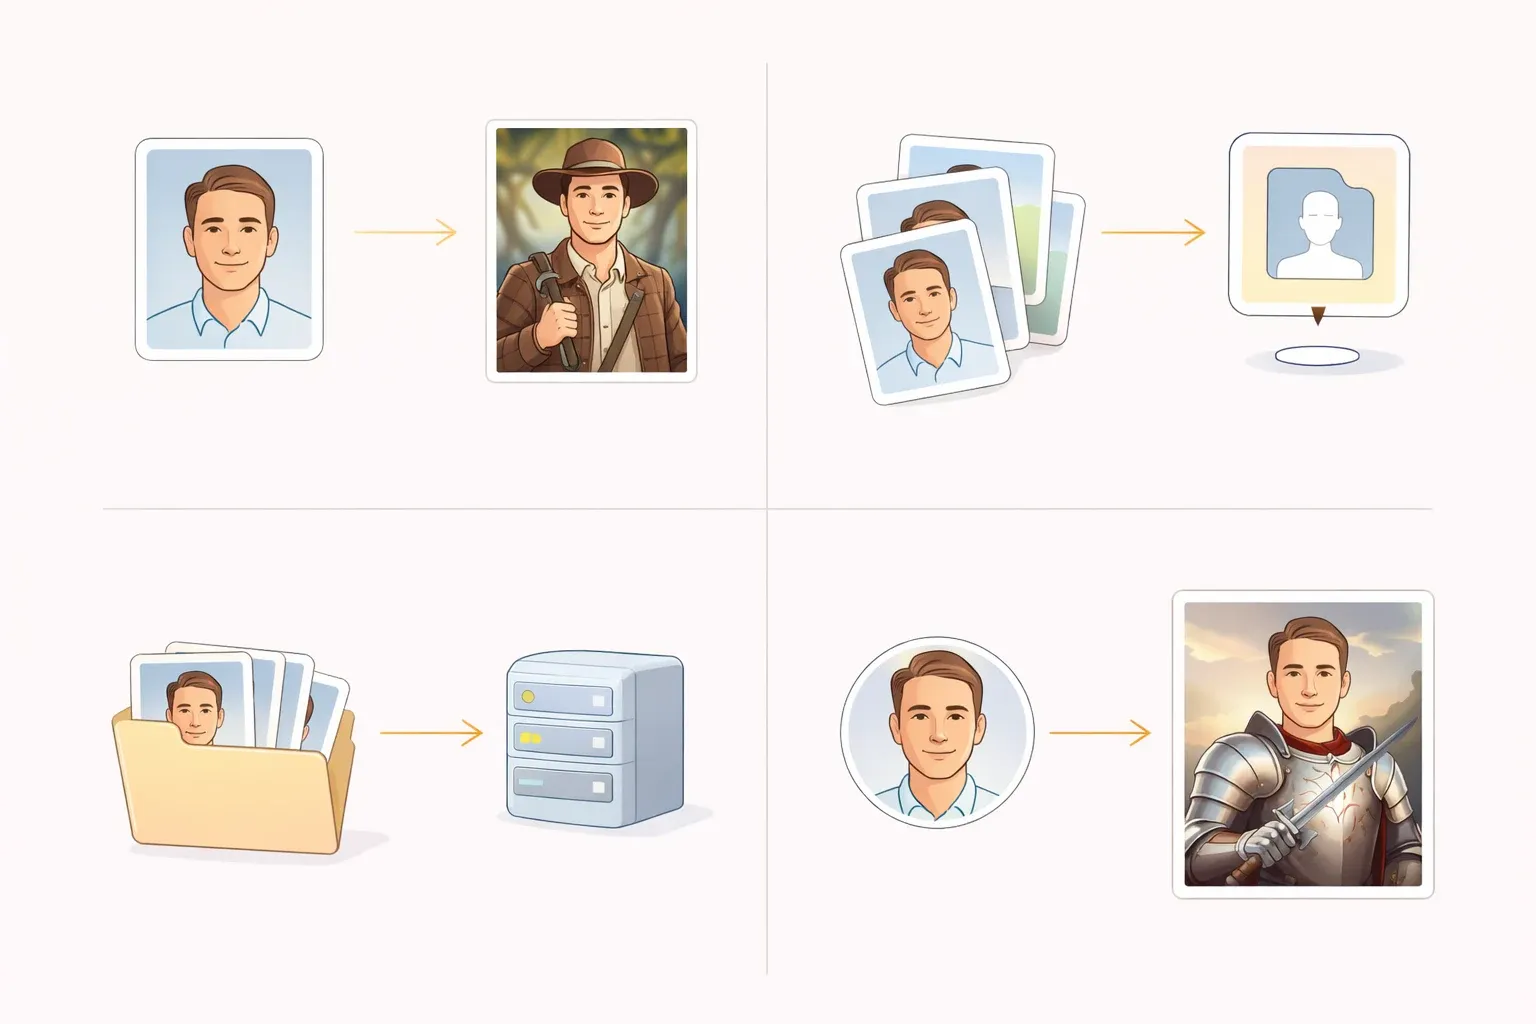
「AI画像ジェネレーターに自分を取り込む方法」を検索する人が意味しているのは、次の4つのうちのいずれかです:
- 自分にぼんやり似た人の画像を生成したい。
- AIに自分の写真を見せて、スタイル化した何かを作らせたい。
- 自分の顔を実際に学習して、どんなシーンにも自分を生成できるモデルが欲しい。
- すでに存在する特定の画像に自分の顔を載せたい。
それぞれに必要なツール、労力、お金が違います。ほとんどの記事は1つを選んで、他は存在しないかのように振る舞います。このガイドは違います。
4つの方法を横並びで
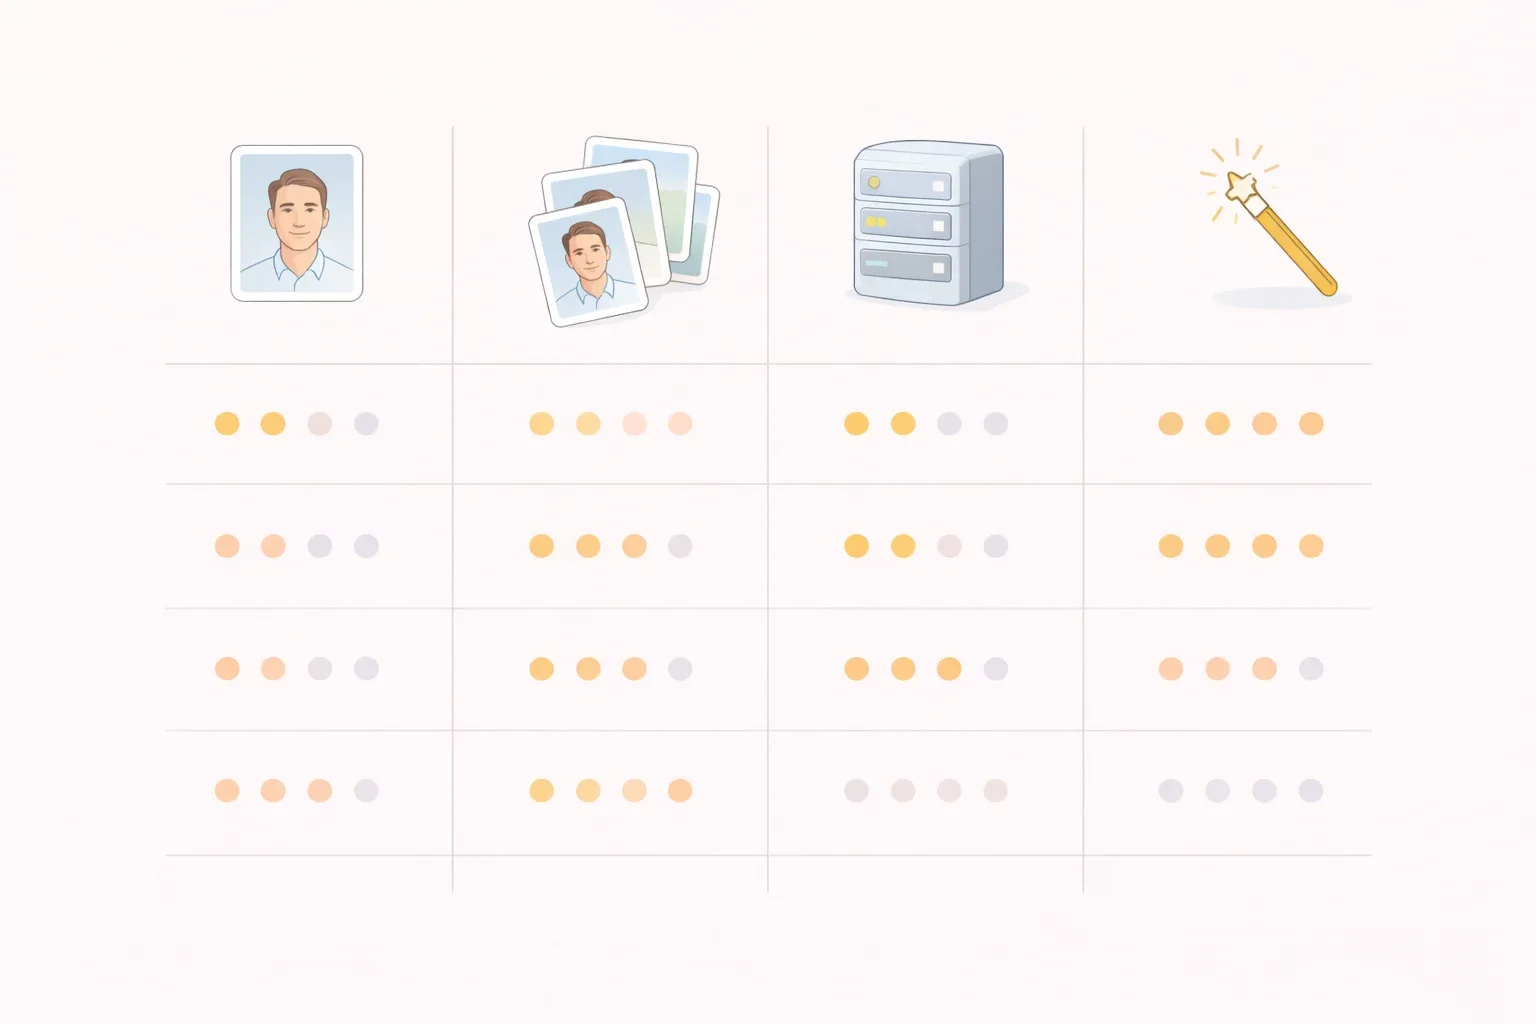
地図全体をひとつの表にまとめました。次の各セクションでそれぞれを掘り下げます。
| 方法 | 必要なもの | 質 | 時間 | コスト | プライバシーリスク |
|---|---|---|---|---|---|
| 1 — プロンプトで自分を記述 | 自撮り1枚(任意) | 低 | 30秒 | 無料 | 低 |
| 2 — 写真をリファレンスとしてアップ | 1〜5枚 | 中 | 2分 | 無料〜$10/月 | 中 |
| 3 — 自分のLoRAを学習 | 10〜20枚 | 高 | 10〜60分 | $3〜$15 | 中〜高 |
| 4 — 画像に顔を交換 | ターゲット画像+自撮り | 中 | 10秒 | 無料 | 低 |
選び間違えると午後がまるごと無駄になります。正しく選べば数分で終わります。
方法1 — プロンプトで自分を記述するだけ
最もシンプルな方法。アップロードも、学習も、アカウント作成も不要。自分の見た目を入力し、その記述に合う人物をモデルが生成します。
「自画像プロンプト」の書き方
どんなAI画像でも有効な4パート構造 — 被写体、設定、スタイル、品質 — をそのまま使い、被写体の行を自分の正確な描写に置き換えます。
a 32-year-old man with short dark hair, warm brown eyes, light stubble,
wearing a navy wool coat, walking through a snowy Brooklyn street at dusk,
shot on Fujifilm X-T5, 35mm, shallow depth of field, natural colors
具体的であるほど、出力は近く感じられます。身長、体型、肌の色、髪の長さと質感、メガネ、髭、特徴 — 言葉ひとつごとに推測の幅が狭まります。曖昧なプロンプトでは、たまたま髪の色が同じなだけの他人が返ってきます。
4パートプロンプト公式の詳しい解説は、AIでテキストから画像を生成する方法のガイドをご覧ください。
この方法の限界
実際に「あなた」に見えるわけではありません。「あなたの記述に合う誰か」に見えます — それはまったく別物です。双子、三つ子、あなたとは別の家族が次々と。
ただし、それが利点になるケースもあります:
- 「著者」が具体的にあなたである必要のない、ブログ記事のヒーロー画像。
- 顔そのものは重要でないムードボードやコンセプトアートの下書き。
- 第三者サーバーに個人データを一切残したくないとき。
10枚の画像で同じ人物が一貫して登場する必要があるとき、または画像にあなたの名前が添えられるときは、この方法は不向きです。
このアプローチに最適なツール
Anyscene、Midjourney、Meta AI、Microsoft Copilotがいずれもこの方法を良く扱います。Meta AIには独自の特徴があり、プロンプトに me という単語を加えると、ログイン中のプロフィール写真へ微妙にバイアスがかかります。普通の日本語または英語プロンプトでAnysceneでこの方法を試すと、どこまで近づけるか確認できます。
方法2 — 写真をリファレンスとしてアップロード
忠実度が一段上がります。自分の写真を1枚以上モデルに渡し、登場させたいシーンを記述したプロンプトを添えます。モデルは新しい重みファイルを学習するのではなく、写真をビジュアルガイダンスとして使います。
ビジョン誘導生成の仕組み
モデルは写真をビジョンエンコーダーに通し、顔を表すエンベディングを抽出し、そのエンベディングで生成を条件付けします。学習は起きません。エンベディングはその生成の間だけ、あるいはツール次第で短いセッションの間だけ存在します。
絵描きに20分だけリファレンス写真を渡し、その後返してもらうようなものと思ってください。
ステップバイステップの流れ
各ツール間でほぼ同じ流れです:
- 写真を1枚(対応サービスでは最大5枚)アップロード。顔がはっきり見え、サングラスなし、まずまずの光で。
- 登場させたいシーンのプロンプトを書く — 方法1と同じ4パート公式ですが、自分の記述は不要です(写真がそれを担います)。
- スタイルやアスペクト比を選ぶ。
- 生成。30秒から2分待つ。
試す価値のあるツール:Photo AI、Starryai、ImagineMe、Flux Kontext(Flux独自のリファレンス画像機能)。
この方法を選ぶとき
中間地点です。方法1より似ていて、方法3よりはるかに労力が少ない。次の場合に:
- 20枚のバッチではなく、1枚の良い画像が必要。
- 学習サービスに20枚も写真を渡したくない。
- 画像ごとに顔が少しブレてもかまわない。
精度は角度によって大きく変わります。リファレンスが正面からのスタジオショットなら、結果はたいてい認識できます。3/4の角度や横顔が必要だと、出力が崩れ始めます。
方法3 — パーソナライズドモデル(LoRA)を学習
最高品質、最も労力のかかる選択肢。小さなモデル — LoRA — を学習して自分の見た目を覚えさせ、FluxやStable Diffusionのようなベースモデルに差し込みます。学習後は、すべての生成にあなたが含まれます。
LoRAを普通の言葉で
LoRAは Low-Rank Adaptation の略です。ベースモデルの上に乗る小さなファイル(およそ5MB)で、特定の概念 — この場合はあなたの顔 — に向かって重みを微調整します。
新しいAIをゼロから学習するわけではありません。既存のAIに新しい単語を教えるのです。学習はレンタルGPU時間で15分〜1時間。結果として得られるファイルは、学習時に選んだトークンを含むあらゆるプロンプトで動作します。
必要な写真
質は量に勝りますが、それでも多様性は必要です。
- 枚数:10〜20枚。10未満ではモデルが学習不足、20を超えても改善はほとんど見られません。
- 角度:正面、3/4、横顔の組み合わせ。それがないと、横からの画像が生成できません。
- 表情:ニュートラル、笑顔、真剣。単調な集合は、その表情にあなたを固定してしまいます。
- ライティング:多様に。屋内、屋外、ソフト、ハード。単調なライティングは「あなたの顔は1種類の光の下にしか存在しない」とモデルに教えてしまいます。
- トリミング:主に顔と肩。詳細用にクローズアップ、文脈用に中距離ショットを2〜3枚。
- 避けるもの:サングラス、重いフィルター、集合写真、同じ撮影セッションからの重複ショット。
2026年の学習先(料金付き)
本稿執筆時点で信頼できる4つの選択肢。料金はモデル1つあたり1回払い。
| サービス | モデル | 学習時間 | 料金 |
|---|---|---|---|
| Replicate(ostris/flux-dev-lora-trainer) | Flux Dev | 15〜25分 | 約$3 |
| fal.ai | FluxまたはSDXL | 10〜20分 | 約$4 |
| Astria | SDXL | 30〜60分 | $8〜$12 |
| Hugging Face AutoTrain(セルフホスト) | FluxまたはSDXL | 20〜40分 | GPU時間のみ |
学習後の生成は同じプラットフォームで実行するか、GPUがあればLoRAファイルをダウンロードしてローカルで実行できます。
もうひとつの判断:ベースをFluxにするかSDXLにするか。2026年では、顔とリアルな肌はFluxの勝ち、スタイル化された出力とより大きなLoRAエコシステムはSDXLの勝ち。最初のモデルを学習し、自分のリアルな写真を生成するつもりならFluxを。アニメ、イラスト、強くスタイル化された出力が欲しいなら、コミュニティLoRAを重ねて使えるSDXLが有利。2026年にSD 1.5は避けてください — 安いですが、出力品質はモデルにして2世代分後ろです。
トラブルシューティング:不気味の谷、アイデンティティの揺らぎ
LoRA学習では、一見問題なさそうに見えて、3秒後に「あれ?」となる微妙なズレが起こります。
- 蝋人形のような肌。 学習データのフィルタが強すぎるか、ベースモデルが過度に滑らかにしている。プロンプトに
film grain, natural skin texture, pores visibleを追加し、CFGを6に下げる。 - バッチ内でのアイデンティティの揺らぎ。 同じシード、同じプロンプトで、顔がそれぞれ少し違う。トークン語を2回入れ、プロンプトに
consistent characterを追加。 - 正面しか自分に見えない。 学習セットが正面寄りすぎる。3/4と横顔を加えて再学習。
- 肌色が違う。 ベースモデルのバイアス。プロンプトで民族とトーンを明示。
- 世代を経るごとに特徴が誇張される。 LoRAの強度が高すぎる。1.0から0.75に下げる。
方法4 — 既存画像に顔を交換
新しい画像が欲しいわけではないこともあります。すでに存在する特定の画像で、誰かの顔をあなたの顔に置き換えたい — それがフェイススワップで、まったく別のパイプラインです。
Flux Pro + インペインティング
2026年で最もクリーンなアプローチ。ソース画像の顔をマスクし、リファレンス自撮りをアップロードし、Fluxにインペイントさせる。10秒、1回の生成、学習不要。シーン、ライティング、構図を保ち、顔だけが変わります。
ソースの顔があなたの自撮りに近い角度のとき最もよく機能します。角度がずれると目に見える縫い目が出ます。
フェイススワップ専用ツール
Fluxをセットアップしたくない場合、マスクを自動でやってくれる専用サービスがあります。
- Pincel — ターゲット画像と自撮り1枚をアップ、1分以内にスワップ完了。
- Remaker — 無料ティアあり、基本的だが機能する。
- InsightFace系ツール — オープンソース、GPUがあればローカル実行可能。
スワップが学習に勝つとき
スワップが勝つのは:
- 入りたい特定の画像が1枚ある(雑誌の表紙、絵画、ミーム素材)。
- 学習を待ちたくない。
- ターゲットのシーンが完璧な類似性より重要。
学習が勝つのは、自分の異なる画像が20枚必要で、すべて一貫しているとき。スワップが勝つのは、画像が1枚必要で、それが今すぐ必要なとき。
どの方法を選ぶべきか?
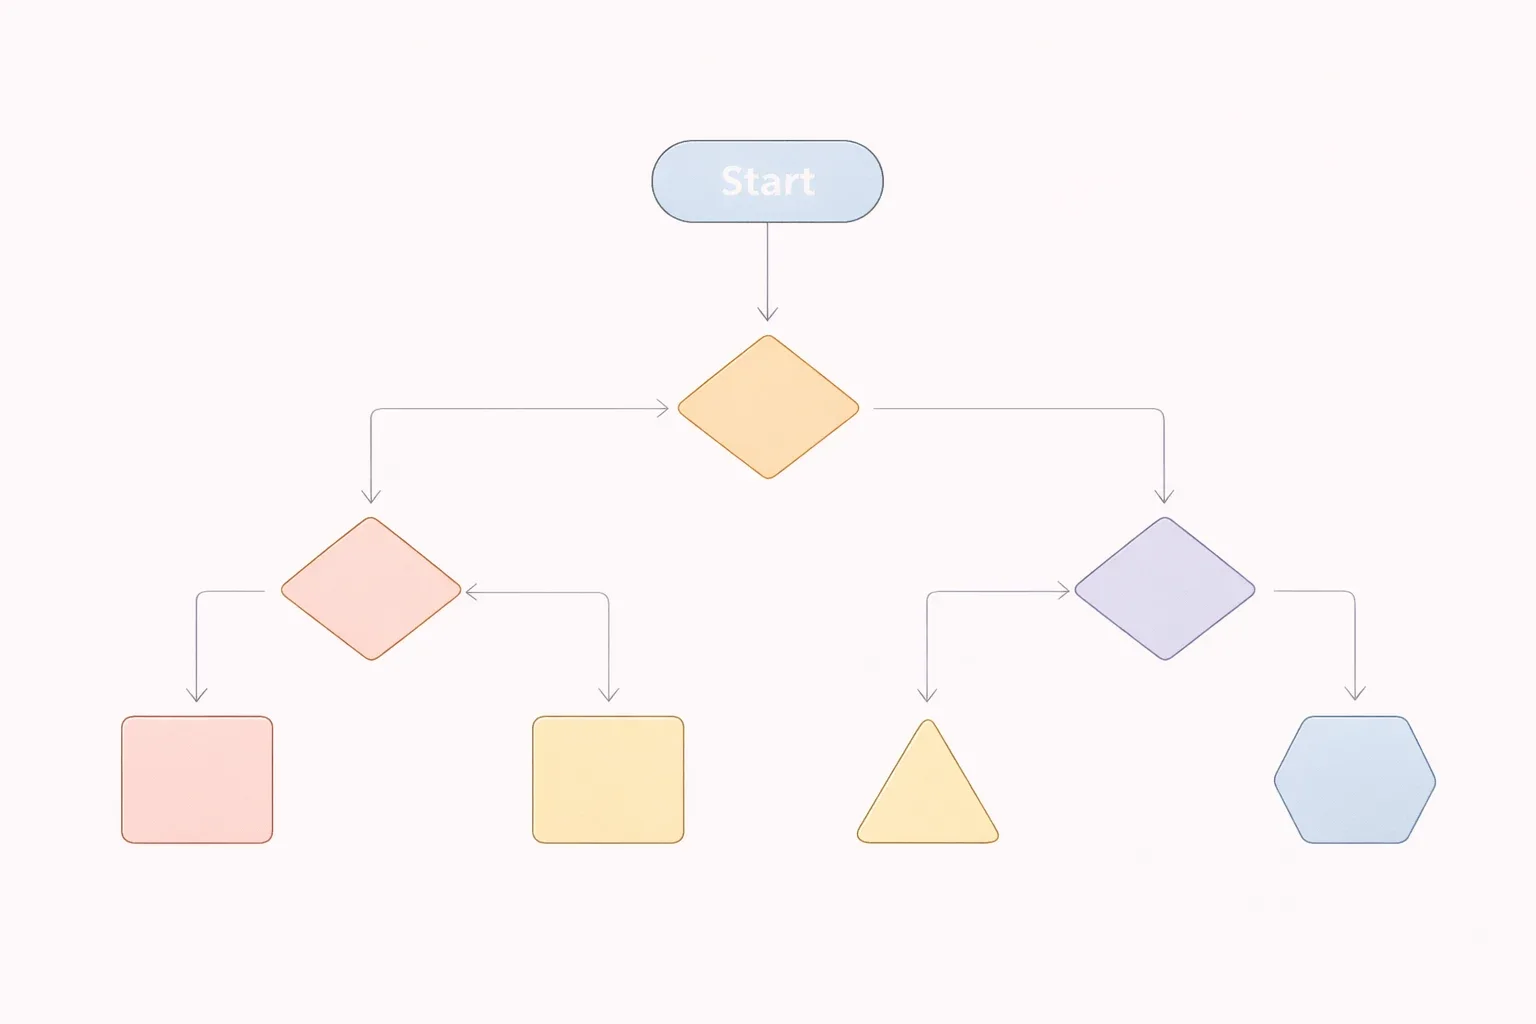
すぐ決められる判断表:
| やりたいこと | 使う方法 | 理由 |
|---|---|---|
| コミットメントなしで一度試す | 方法1 | 無料、アップロード不要、アカウント不要 |
| 2分以内にまずまずのヘッドショットを得る | 方法2 | 質と労力のベストバランス |
| 自分の一貫した画像を20枚以上生成 | 方法3(LoRA) | 顔を実際に学習する唯一の方法 |
| 既存の特定画像に自分の顔を載せる | 方法4 | シーンを保ったまま顔だけ交換 |
| 生体データを第三者サーバーに残さない | 方法1 | デバイスから何も出ない |
| 予算ゼロ | 方法1または4 | どちらも無料ティアあり |
ほとんどの人がやりすぎます。方法2が2分で解決する用途のためにLoRAを学習してしまう。実際のニーズに答えられる最もシンプルな方法を選んでください。
よくある失敗と修正方法
各方法にはそれぞれの崩れ方があります。この表が、ほとんどのガイドが省略する一品です。
| 問題 | 原因 | 対処 |
|---|---|---|
| 出力が見知らぬ人に見える | プロンプトが曖昧(方法1) | 年齢、体型、肌の色、髪、特徴を追加 |
| 生成ごとに顔が変わる | 学習された表現がない(方法1または2) | 一貫性が必要なら方法3(LoRA)へ |
| 蝋人形に見える | 肌が過度に滑らか | film grain, natural skin texture を追加、CFGを6へ |
| 横からだと自分に見えない | 学習写真がすべて正面 | 3/4と横顔で再学習 |
| 肌色が違う | ベースモデルのバイアス | プロンプトで民族とトーンを明示 |
| バッチ間でアイデンティティがブレる | LoRAランクが低い、シード使い回し | rank 16以上で再学習、またはシード固定+consistent character |
| 顔が浮いて、シーンのライティングに合わない | プロンプトに光の方向がない | matching ambient light を追加、または光源を明示 |
| フェイススワップに縫い目が見える | 角度の不一致 | ターゲット顔の角度に合う自撮りを使う |
| 数世代後に特徴が誇張される | LoRA強度が高すぎる | 1.0から0.75に下げる |
この表を保存しておきましょう。何度も戻ってくることになります。
プライバシー、同意、そして法律
このセクションは短くまとめます — ルールがシンプルで、ほとんどのガイドがまるごと省略しているからです。
あなたの写真は生体データです。 EUのGDPR、カリフォルニアのCCPAをはじめとする類似法令の下では、顔は保護される個人情報です。学習サービスに自撮り15枚をアップロードするということは、そのサービスと生体データを共有するということ。保持ポリシーをお読みください。学習後に削除するサービスもあれば、「モデル改善のため」に無期限で保持するサービスもあります。
学習できるのは自分自身だけ。 同意なしに他人の写真でモデルを学習させるのは、最低でもプライバシー侵害です。いくつかの管轄では、コンテンツを生成すれば名誉毀損や成り済ましにもなります。元恋人、上司、有名人で学習してはいけません。
自分のAI画像の商用利用は通常問題ありません — ツールのライセンスが許せば。LinkedInのヘッドショット、自社の広告、自分のウェブサイトに使うのは一般に許されます。複雑になるのは、画像にAI生成の背景が含まれて推薦を暗示してしまう場合(架空のレストラン、架空の製品)。使ったツールのライセンスページをご確認ください。
一部のプラットフォームでは、広告や編集用途でのAI開示が義務化されています。 フランス、EU AI法、複数の米国州法が2026年にかけて施行を進めています。商用文脈で自分のAI画像を公開するなら、公開ボタンを押す前に現地の要件を確認しましょう。
よくあるご質問
無料でできる? はい。方法1と4には完全に無料の経路があります。方法2はほとんどのツールで無料ティアあり。GPU時間の支払いが必要なのは方法3(LoRA学習)のみ — 通常、モデルあたり1回$3〜$15です。
写真は何枚必要? 方法1:ゼロ。方法2:1〜5枚。方法3:10〜20枚。方法4:ターゲット画像1枚+自撮り1枚。
完全に自分に見える? 方法1は、あなたの記述に合う誰かに見えます。方法2は近く見えます。方法3は、うまく学習できれば正面ショットでは見分けがつかないことも多いです。方法4はソース画像のシーンを保ち、顔だけ置き換えます — 精度は角度の一致次第。
自分のAI写真を商用利用するのは合法? ほとんどの有料ティアでは合法。特定のツールのライセンスページをご確認ください。無料ティアの出力には利用制限が付くことがよくあります。
他人の写真を使ったら? やめてください。同意のない他人の類似性モデルを学習することは、ほとんどの管轄でプライバシー法違反であり、有害なコンテンツを生成すれば名誉毀損や成り済ましにもなりえます。
Googleにこのための機能はある? GoogleのGeminiではリファレンス写真をアップロードし、周囲のシーンを変形できます — 方法2に最も近いです。LoRA学習は提供されていません。
2026年のLoRA学習時間は? Replicate、fal.ai、Astriaで10〜60分。コンシューマー向けGPUによるローカルなら30〜90分。
最も安く試す方法は? 方法1。Anyscene、Meta AI、Copilotなどの無料ツールで、自分自身をプロンプトに入力するだけ。コストゼロ、30秒。
LoRA学習にGPUは必要? Replicate、fal.ai、Astriaのようなホスト型サービスを使うなら不要 — 彼らがGPU時間を貸し、分単位で課金してくれます。ローカルで学習したいならGPUが必要。12GB VRAMのコンシューマー向けGPU(RTX 3060以上)でFlux LoRA学習を約1時間で扱えます。
方法を組み合わせられる? はい、それがしばしば最良の結果です。自分のLoRA(方法3)を学習し、フェイススワップ(方法4)でLoRA出力を非常に特定のソース画像に載せる。あるいは自分のLoRAをコミュニティのスタイルLoRAと組み合わせて、特定のアートスタイルで自分を表現する。
AIモデルは私を永久に覚えている? LoRAを学習した場合のみ。方法1、2、4は生成終了後にあなたの顔をどこにも残しません。方法3は、学習プラットフォームかご自身のディスク上で、削除するまで存在するファイルを作成します。
最良の方法はめったに最も難しいものではありません。方法1から始め、結果が十分でないときだけ方法2へ、同じ顔を20枚にわたって一貫させる必要があるときだけLoRA学習へ進みましょう。