 Anyscene AI
Texte vers image par IA
Écris ce que tu veux voir et récupère-le sous forme d'image. Tous les modèles texte vers image partagent un même champ de prompt, et le prix s'affiche sur le bouton avant que tu cliques.
Essaie un exemple
Un prompt, six styles
Un prompt texte vers image en six styles
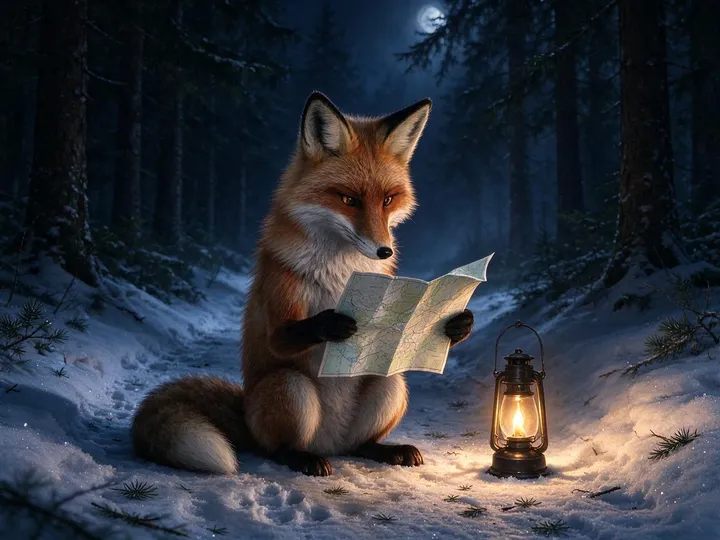
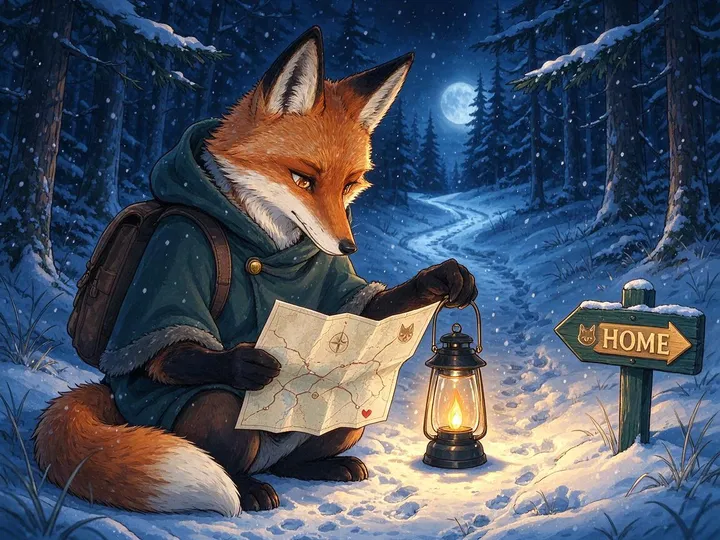
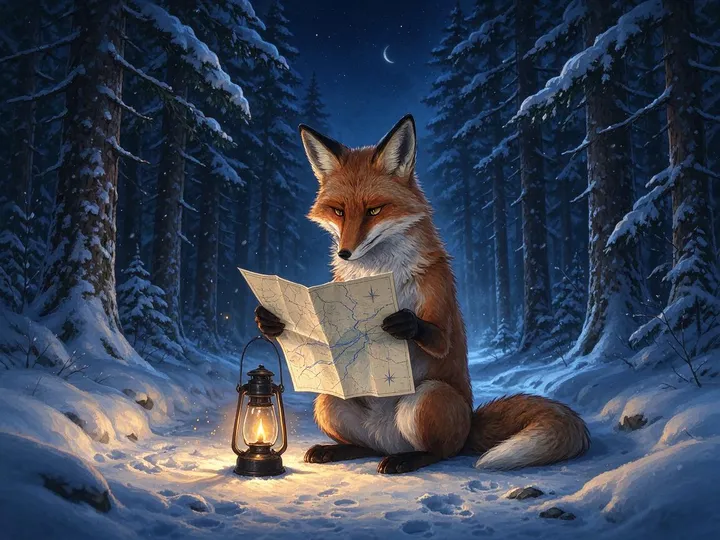
Le menu des styles du générateur ajoute une expression à la fin de ton prompt. Nous avons fait passer le même prompt du renard par les six styles sur Seedream 5.0 Flash, le modèle texte vers image par défaut de cette page, pour voir jusqu'où cette expression change l'image.
Le prompt, tel qu'envoyé
A red fox sitting on a snowy forest path at night, reading a paper map by the light of a small lantern, [style] style
- Sujet
- Décor
- Lumière
- Style
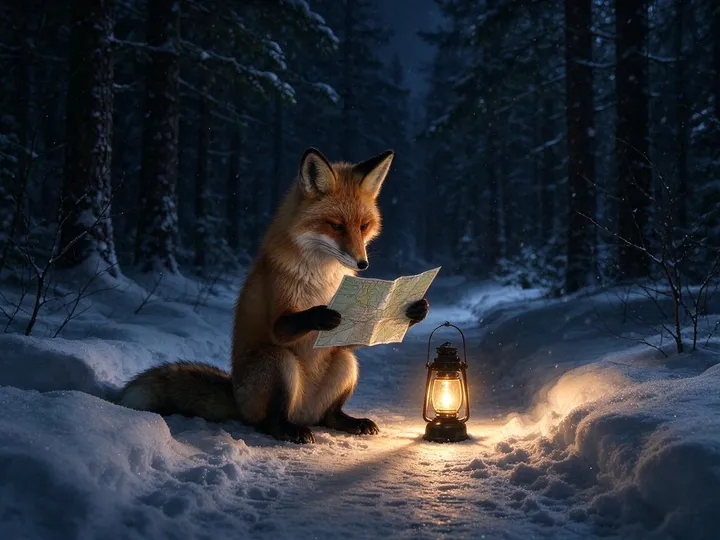
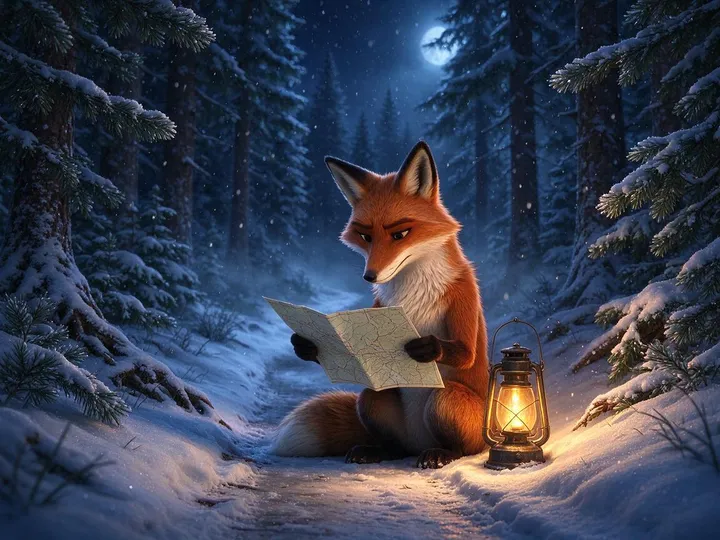
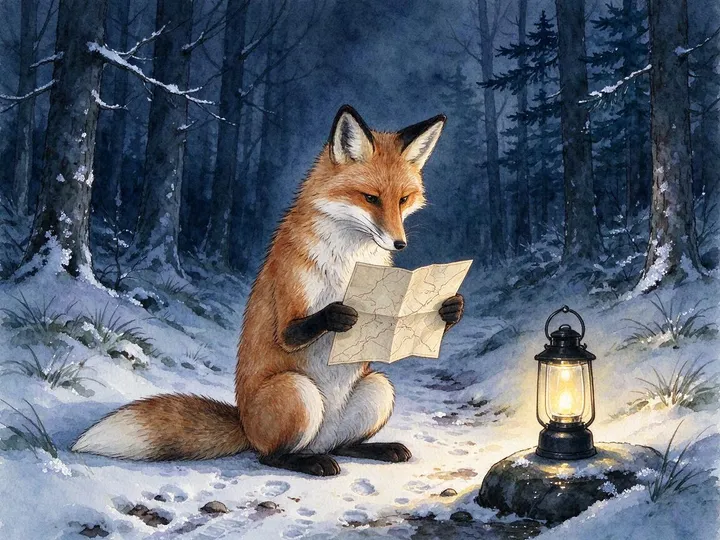
Ce qui a changé, et ce qui n'a pas changé
- Anime a le plus transformé l'image. Le renard a gagné un manteau à capuche, un sac à dos et un panneau indiquant HOME, rien de tout cela n'étant dans le prompt.
- Aquarelle a adouci les contours et éclairci la neige, mais a gardé la même composition.
- Art numérique, Cinématographique et Modèle 3D sont sortis très proches de Photoréaliste. Sur ce modèle, un mot de style est un coup de pouce, pas une consigne.
- Quand un style ne prend pas, décris la matière : « un rendu 3D avec des matières en pâte à modeler douce et un éclairage de studio » en dit bien plus que « style modèle 3D ».
Six générations texte vers image le 23 octobre 2026, une par style, sans rien relancer ni retoucher. Chacune a pris entre 14 et 25 secondes.
En bref
Qu'est-ce que l'IA texte vers image ?
L'IA texte vers image est la partie de l'IA générative qui dessine : tu décris une image avec des mots et un modèle la crée.
L'IA texte vers image est un logiciel qui transforme une description écrite, appelée prompt, en une nouvelle image. Un modèle entraîné sur des millions d'images légendées lit le prompt et génère des pixels qui lui correspondent : une photo, une illustration ou une affiche avec du texte, au format de ton choix.
Ton prompt
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out, shot from a low angle with a wide 24mm lens, long exposure that smooths the water, cinematic colors
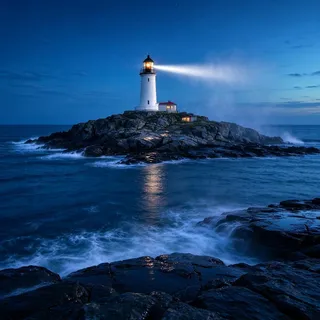
Un schéma simplifié du fonctionnement de la diffusion, pas des images d'une vraie génération. L'image finale est notre phare de l'étape 4, plus bas.
Les modèles qui retirent le bruit
La plupart des modèles texte vers image, dont Flux, Seedream et Qwen Image, sont des modèles de diffusion ou de flux : ils partent du bruit et l'affinent par étapes, guidés par ton prompt. Les plus récents placent un modèle de langage en amont, qui lit le prompt avec une meilleure connaissance du monde.
"The model couples the Mistral-3 24B parameter vision-language model with a rectified flow transformer."
Black Forest Labs, annonce de FLUX.2Les modèles intégrés à un chatbot
La gamme GPT Image d'OpenAI est née de la génération d'images intégrée à GPT-4o, le modèle derrière ChatGPT, plutôt que d'un modèle d'image séparé. Selon OpenAI, elle suit des instructions détaillées et place du texte dans les images de façon fiable.
"…because it is embedded natively, deep in the architecture of our omnimodal GPT‑4o model, 4o image generation can use everything it knows…"
OpenAI, fiche système de la génération d'images de 4oTu veux la version longue, avec des solutions pour les mains bizarres et le texte illisible ? Lire notre guide texte vers image →
Quatre étapes, un prompt
Comment un prompt texte vers image devient précis
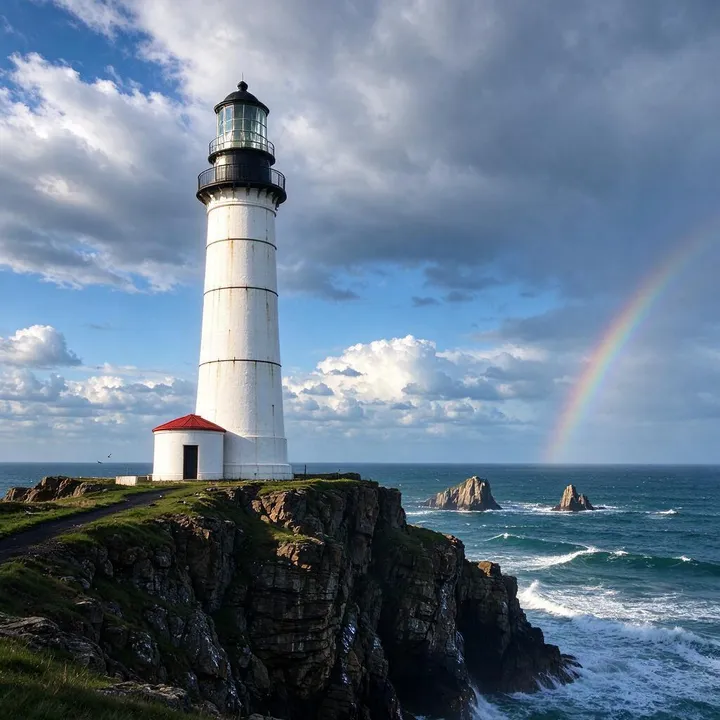
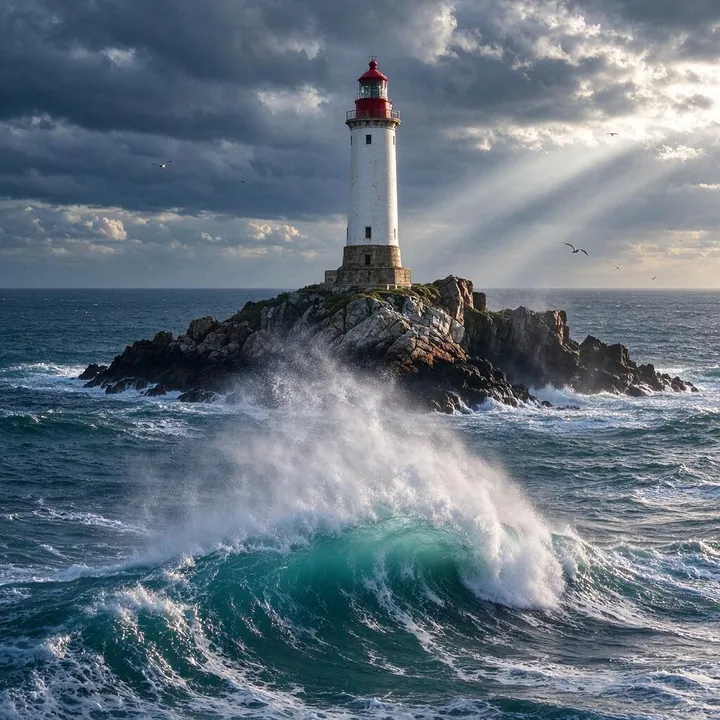
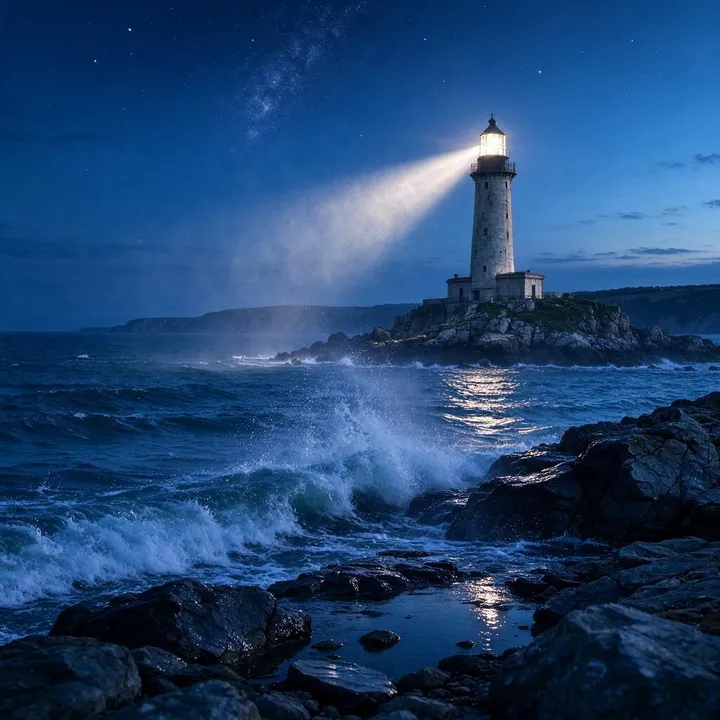
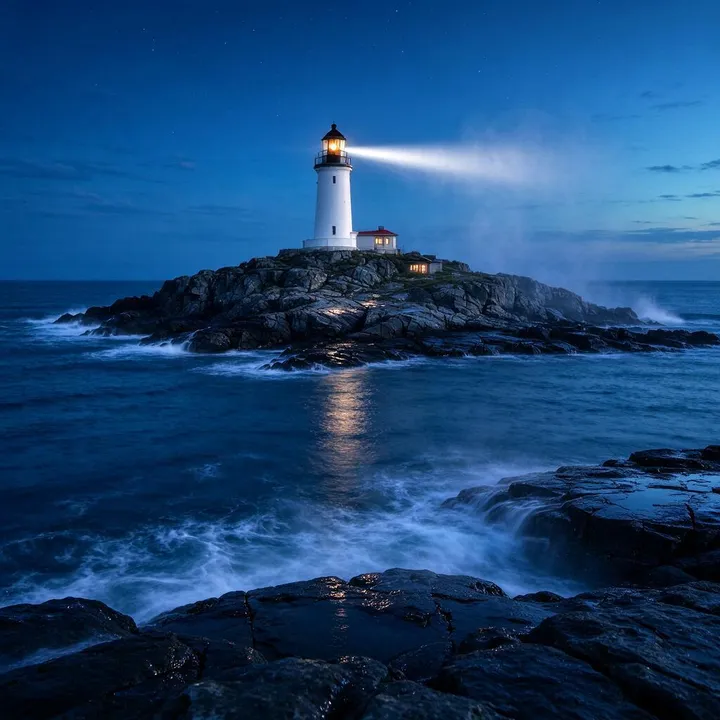
Un prompt court laisse tous les choix au modèle. Chaque étape ci-dessous ajoute un type de détail au même prompt du phare. Les nouveaux mots sont marqués, les précédents grisés.
 1 / 4
1. Le sujet seul
A lighthouse
Deux mots ont donné une falaise ensoleillée avec un arc-en-ciel. Le modèle a rempli tout le reste avec l'image la plus banale d'un phare.
 2 / 4
2. Ajouter le décor
A lighthouse on a rocky island, waves breaking against the rocks below
Nommer le lieu a posé le phare sur un rocher en pleine mer et a fait venir la vague qui se brise.
 3 / 4
3. Ajouter la lumière et l'heure
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out
L'heure bleue, le brouillard et les étoiles ont changé toute l'ambiance. Dans notre essai, c'est cette étape qui a le plus changé l'image.
 4 / 4
4. Ajouter la caméra
A lighthouse on a rocky island, waves breaking against the rocks below, at blue hour, its beam cutting through a light fog, the first stars coming out, shot from a low angle with a wide 24mm lens, long exposure that smooths the water, cinematic colors
La pose longue a lissé l'eau, mais la contre-plongée au 24 mm se voit à peine. Les mots de caméra sont ceux que ce modèle a le moins suivis.
Seedream 5.0 Flash en 1:1, une génération texte vers image par étape le 23 octobre 2026, de 14 à 19 secondes chacune.
Générateur de prompt
Composer un prompt texte vers image
Tu ne sais pas quoi écrire ? Ce générateur de prompt texte vers image n'a besoin que d'un sujet et d'une expression par groupe, et le prompt se compose tout seul. Envoie-le au générateur en haut de la page ou copie-le.
Ton prompt
Une tasse à café en céramique, sur une table en bois près d'une fenêtre, douce lumière du matin
- Sujet
- Décor
- Lumière
- Caméra
- Style
- Texte
- Mets le sujet en premier, pour que rien de ce qui le précède ne soit pris pour l'essentiel.
- Un décor, une lumière, un style : deux styles tirent dans des sens opposés.
- Nomme ce qu'on verrait, pas ce qu'on devrait ressentir. « Du brouillard et un soleil bas » marche mieux que « une ambiance ».
- Les mots à dessiner vont entre guillemets, et moins il y en a, mieux c'est.
Le texte dans l'image
Comment obtenir un texte bien orthographié dans une image IA
Enseignes, étiquettes et titres d'affiche étaient le point faible de l'IA texte vers image. Les modèles actuels écrivent correctement un texte court si le prompt est rédigé pour, comme le montrent les quatre résultats ci-dessous.
01
Mets les mots exacts entre guillemets
Les guillemets indiquent à un modèle texte vers image qu'il s'agit de lettres à dessiner, pas d'idées à illustrer : une enseigne où l'on lit « Books & Tea », pas une enseigne qui parle de livres et de thé.
02
Dis où va le texte
Sur une enseigne peinte à la main, sur l'étiquette, en haut de l'affiche. Un texte sans emplacement finit par flotter ou par atterrir au mauvais endroit.
03
Décris la typographie
Écriture manuscrite, lettres grasses, une serif élégante. Un style nommé donne au modèle un repère et garde des lettres régulières.
04
Fais court et vérifie chaque mot
Chaque ligne entre guillemets ci-dessous compte six mots ou moins. Les modèles ajoutent aussi des mots que personne n'a demandés : Seedream 5.0 Pro a mis un sous-titre et des légendes sur notre infographie du café.
 1
 2
 3
 4
1Nano Banana Pro16:9
A cozy bookshop storefront on a cobblestone street at dusk, a hand-painted sign reading "The Paper Lantern — Books & Tea", warm light spilling from the windows, a bicycle leaning against the wall
2GPT Image 2.52:3
A vintage travel poster for Kyoto: a five-storey pagoda among cherry blossoms at sunset, the title "KYOTO" in bold letters at the top and "Cherry Blossom Season" at the bottom, flat screen-print style
3Nano Banana Pro4:5
A kraft-paper coffee bag on a café counter, the label printed with "MORNING RITUAL — Single Origin, Ethiopia" in an elegant serif, soft morning light, shallow depth of field
4Qwen Image 3.03:4
A chalkboard café menu titled "Morning Menu" listing Espresso 3.00, Latte 4.50 and Croissant 3.50, hand-lettered, warm café light
Résultats de nos pages de modèles, une génération chacun. Chaque mot entre guillemets est sorti tel qu'écrit, mais vérifie l'orthographe des tiens avant de publier.
Chaque modèle, avec son prix
Quel modèle texte vers image choisir
Les 17 modèles acceptent le même prompt. Ils diffèrent par ce qu'ils font le mieux, ce qu'ils coûtent et la taille de l'image qu'ils renvoient. Les crédits, tailles et forfaits ci-dessous viennent de la même grille de prix que celle du bouton Générer.
Fais défiler le tableau sur le côté pour voir toutes les colonnes.
| Modèle | Idéal pour | Crédits par image | Taille max. | Disponible pour |
|---|---|---|---|---|
| Basic | Des brouillons rapides pour tester une idée | 2 crédits | 1K | Tous les comptes |
| Z-Image | Des images bon marché à partir du seul texte | 2 crédits | 1K | Tous les comptes |
| Seedream 5.0 Flash | Des images du quotidien à petit prix ; le modèle texte vers image par défaut de cette page | 5 crédits | 2K | Tous les comptes |
| GPT Image 1.5 | Suit de près les prompts longs et détaillés | 6 crédits | 1K | N'importe quel forfait ou pack de crédits |
| Nano Banana | Des scènes simples, et des retouches qui gardent le sujet intact | 6 crédits | 1K | N'importe quel forfait ou pack de crédits |
| Nano Banana 2 Lite | Des scènes simples et des photos culinaires au prix Nano Banana le plus bas | 6 crédits | 1K | Tous les comptes |
| Wan 2.7 Image | Une qualité suffisante au quotidien à petit prix, avec un niveau Pro plus détaillé | 6–20 crédits | 4K | N'importe quel forfait ou pack de crédits |
| Flux 2 | Un détail photographique (Pro) et la typographie la plus fine (Flex) | 8–36 crédits | 2K | N'importe quel forfait ou pack de crédits |
| GPT Image 2 | Du texte net, des mises en page et des maquettes d'interface | 8–22 crédits | 4K | N'importe quel forfait ou pack de crédits |
| Nano Banana 2 | Des détails plus nets que le premier Nano Banana | 8–22 crédits | 4K | N'importe quel forfait ou pack de crédits |
| Qwen Image 3.0 | Menus, enseignes et affiches avec du texte, à prix moyen | 8 crédits | 2K | N'importe quel forfait ou pack de crédits |
| GPT Image 2.5 | Des affiches et des écrans d'appli au texte exact | 10–26 crédits | 4K | N'importe quel forfait ou pack de crédits |
| Seedream 5 Lite | De grandes images détaillées jusqu'en 3K | 10–14 crédits | 3K | N'importe quel forfait ou pack de crédits |
| Seedream 5.0 Pro | Des portraits à la peau naturelle, et des infographies | 11–22 crédits | 2K | N'importe quel forfait ou pack de crédits |
| Nano Banana Pro | Les prompts les plus difficiles et le texte petit et exact | 29–38 crédits | 4K | N'importe quel forfait ou pack de crédits |
17 modèles texte vers image au total. Un modèle que tu n'as pas encore essayé ? Les exemples de sa page montrent à quoi ressemblent ses propres résultats.
Transformer un texte en image en 3 étapes
Du premier mot à l'image téléchargée, le texte vers image tient en trois étapes et, avec le modèle par défaut, moins d'une demi-minute d'attente.
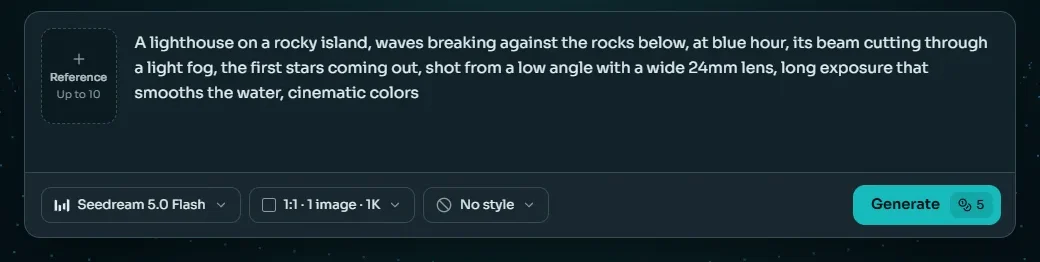
Étape 1 : écris ton prompt
Écris ce que l'image doit montrer dans le champ texte vers image en haut de cette page : d'abord le sujet, puis le décor, la lumière et un style. Pas d'idée ? Pars du générateur de prompt ou de l'un des exemples sous le champ.
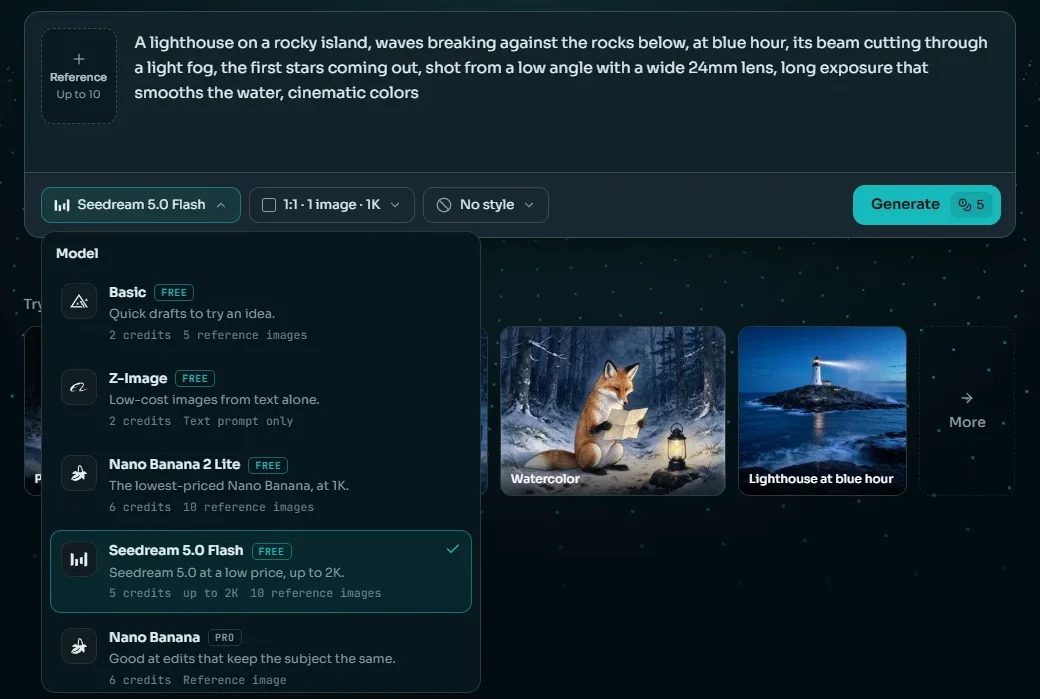
Étape 2 : choisis un modèle, un format et un style
Seedream 5.0 Flash est sélectionné au départ. Change de modèle avec le premier bouton, choisis un format comme 16:9 pour une bannière ou 9:16 pour une story, et ajoute un style si tu veux. Le prix du bouton Générer se met à jour au fur et à mesure.
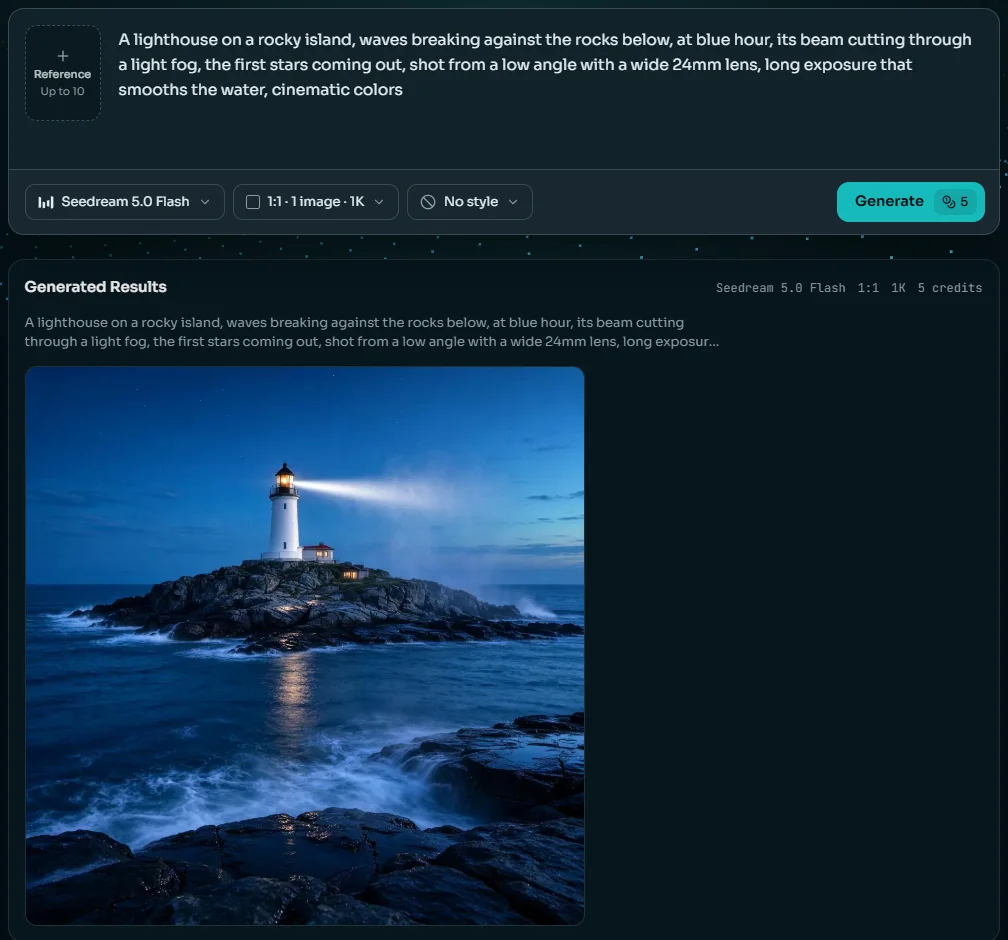
Étape 3 : génère, compare, affine
Clique sur Générer. L'image apparaît sous le champ, avec le prompt qui l'a créée. Change une partie du prompt et relance, essaie un autre modèle avec les mêmes mots, ou passe le résultat à l'éditeur, à l'agrandisseur ou à une vidéo.
Ce que les gens créent
Ce que les gens créent avec l'IA texte vers image
Six vrais résultats texte vers image tirés de nos pages de modèles, chacun avec l'outil qui vient d'habitude ensuite.

Photos produit
Une photo de studio nette pour une boutique, une pub ou un moodboard, avant même que le produit soit photographié.

Plats et boissons
Photos de menu, en-têtes de recettes et vignettes d'applis de livraison, sous la lumière et l'angle que tu décris.

Affiches et citations
Quelques mots sur une mise en page sobre pour les réseaux sociaux et l'impression. Change un mot plus tard dans l'éditeur.

Intérieurs et ambiances
Des intérieurs pour blogs, annonces immobilières et planches d'inspiration. Étends ensuite une image carrée en bannière.

Faune et images façon banque d'images
Des photos de nature pour articles et présentations, sans fouiller les banques d'images. Agrandis-la avant de l'imprimer.

Des images qui bougeront ensuite
Une image qui devient la première image d'une courte vidéo pour Reels ou TikTok.
Trois façons de créer une image
Texte vers image, image vers image ou éditeur d'images IA ?
Le texte vers image, l'image vers image et la retouche tournent tous sur les mêmes modèles. Ce avec quoi tu commences décide de celui qu'il te faut.
| Texte vers image | Image vers image | Éditeur d'images IA | |
|---|---|---|---|
| Tu pars de | Des mots seulement | Des mots et une ou plusieurs images de référence | Ta photo et une instruction |
| Ce qui reste identique | Rien : chaque image est nouvelle | Le sujet, le rendu ou la composition de la référence | Tout ce que tu ne demandes pas de changer |
| Idéal pour | Nouvelles idées, affiches et scènes de zéro | Une nouvelle image dans le style d'une autre, ou avec son sujet | Modifier une vraie photo : fond, tenue, texte ou lumière |
| Le même personnage deux fois | Difficile : le décrire en détail à chaque fois | Plus facile, grâce à la référence | C'est la personne de ta photo |
| Où sur Anyscene | Cette page | Ajoute une référence dans le même champ | La page Éditeur d'images IA |
Mets une image dans l'emplacement de référence, et le générateur texte vers image de cette page devient image vers image ; le bouton Générer affiche le nouveau prix.
Limites honnêtes
Là où le texte vers image se trompe encore
Chaque modèle texte vers image se trompe sur certaines choses. Voici les six erreurs que nous voyons le plus, chacune avec la parade.
Les textes longs
Une phrase entière ou un paragraphe en petits caractères sort encore illisible. Garde chaque ligne entre guillemets courte, ou ajoute le texte ensuite dans un éditeur.
Les nombres exacts
« Sept oiseaux » peut revenir avec cinq ou neuf. Les petits nombres tiennent mieux ; au-delà, compte le résultat et relance.
Visages dans une foule
Une seule personne dans le cadre s'en sort généralement bien. Les petits visages et les mains dans un groupe sont là où les formes se déforment, alors rapproche les gens ou montre-en moins.
Le même personnage
Les mots seuls ne gardent pas un visage ou une mascotte d'une image à l'autre. Ajoute la première image comme référence, ou retouche-la directement.
Éditeur d'images IA →Gauche, droite et derrière
« Un chat à gauche d'un chien » est respecté moins souvent qu'on l'espère. Dis où se trouve chaque chose dans le cadre, et déplace-la dans un éditeur si elle tombe mal.
Personnes et marques
Les prompts qui nomment des personnes réelles, des logos ou des personnages qui ne t'appartiennent pas peuvent être refusés, et utiliser ces images peut porter atteinte aux droits d'autrui. Décris une apparence, pas un nom.
Un seul solde pour tous les modèles texte vers image
Une image coûte de 2 à 38 crédits selon le modèle et la taille, 5 avec le modèle par défaut. Les forfaits commencent à $15.9 par mois en paiement annuel, et les packs de crédits rechargent n'importe quel forfait.
Starter
- 1 200 crédits par mois
- Jusqu'à 600 images ou 30 vidéos
Pro
Populaire- 4 400 crédits par mois
- Jusqu'à 2 200 images ou 110 vidéos
Premium
- 8 400 crédits par mois
- Jusqu'à 4 200 images ou 210 vidéos
Prix annuels, affichés par mois. La facturation mensuelle et les packs de crédits sont sur la page des tarifs.
FAQ sur l'IA texte vers image
L'IA texte vers image transforme une description écrite en une nouvelle image. Tu tapes un prompt, un modèle entraîné sur des images légendées génère une image qui lui correspond, et tu peux la télécharger, la retoucher ou en faire une vidéo.
La plupart des modèles sont des modèles de diffusion ou de flux : ils partent d'un bruit aléatoire et le retirent étape par étape, guidés par ton prompt. Certains plus récents, comme la gamme GPT Image d'OpenAI, sont intégrés à un modèle de langage, ce qui aide pour les instructions longues et le texte dans l'image.
Il n'y en a pas un seul. Commence par Seedream 5.0 Flash, le modèle par défaut, pour les images du quotidien à 5 crédits. Prends Nano Banana Pro ou GPT Image 2.5 quand l'image contient du texte, Seedream 5.0 Pro pour les portraits, et Basic ou Z-Image à 2 crédits pour tester une idée.
De 2 crédits avec Basic et Z-Image à 38 avec Nano Banana Pro en 4K ; le modèle par défaut coûte 5. Le prix s'affiche sur le bouton Générer avant que tu cliques, et une image qui échoue te rend ses crédits. Un nouveau compte démarre avec 40 crédits, utilisables sur les quatre modèles ouverts aux comptes gratuits : Basic, Z-Image, Seedream 5.0 Flash et Nano Banana 2 Lite.
Oui. Tout ce que tu crées sur Anyscene peut être utilisé commercialement, y compris dans des publicités, des fiches produit et des publications sur les réseaux. Ne demande pas dans ton prompt des personnes réelles, des logos ou des personnages sur lesquels tu n'as pas de droits : l'image ne te donne pas ces droits.
Mets les mots exacts entre guillemets, dis où ils vont, décris la typographie et garde chaque ligne courte. Sur nos pages de modèles, Nano Banana Pro, GPT Image 2.5 et Qwen Image 3.0 ont écrit correctement chaque mot entre guillemets. Vérifie chaque mot en taille réelle avant de publier.
Oui. La plupart des modèles lisent les prompts en français, espagnol, allemand, portugais, chinois, japonais et coréen aussi bien qu'en anglais. Si un modèle comprend mal un prompt, essaie le même en anglais. Les mots à faire apparaître dans l'image se mettent de préférence entre guillemets, exactement comme ils doivent s'afficher.
Le texte vers image part uniquement de mots, donc chaque image est nouvelle. L'image vers image ajoute une image de référence, et le résultat en garde le sujet, le style ou la composition. Ajoute une référence dans le même champ de prompt pour passer de l'un à l'autre.
Cela dépend du modèle : environ 1K avec Basic et Z-Image, jusqu'à 2K avec Seedream 5.0 Flash et jusqu'à 4K avec Nano Banana 2, Nano Banana Pro, GPT Image 2, GPT Image 2.5 et Wan 2.7 Image Pro. Les résultats restent 30 jours dans ton historique, alors télécharge ceux que tu veux garder.
Outils d'image IA associés
Les mêmes crédits, pour la prochaine chose que tu voudras faire d'une image.
Éditeur d'images IA
Modifie n'importe quelle image en décrivant le changement en une phrase.
Extenseur d'Image IA
Étends une image à un nouveau format, les bords complétés.
Agrandisseur d'images IA
Rends une image jusqu'à quatre fois plus grande et plus nette.
Image en image
Pars d'une image et transforme-la en une nouvelle.
Ta prochaine image commence par une phrase
Connecte-toi, écris un prompt et choisis l'un des 17 modèles texte vers image. Le modèle par défaut crée une image pour 5 crédits, et les images ratées sont remboursées.